跳到主要內容

部落格

不定期分享最新資訊文章

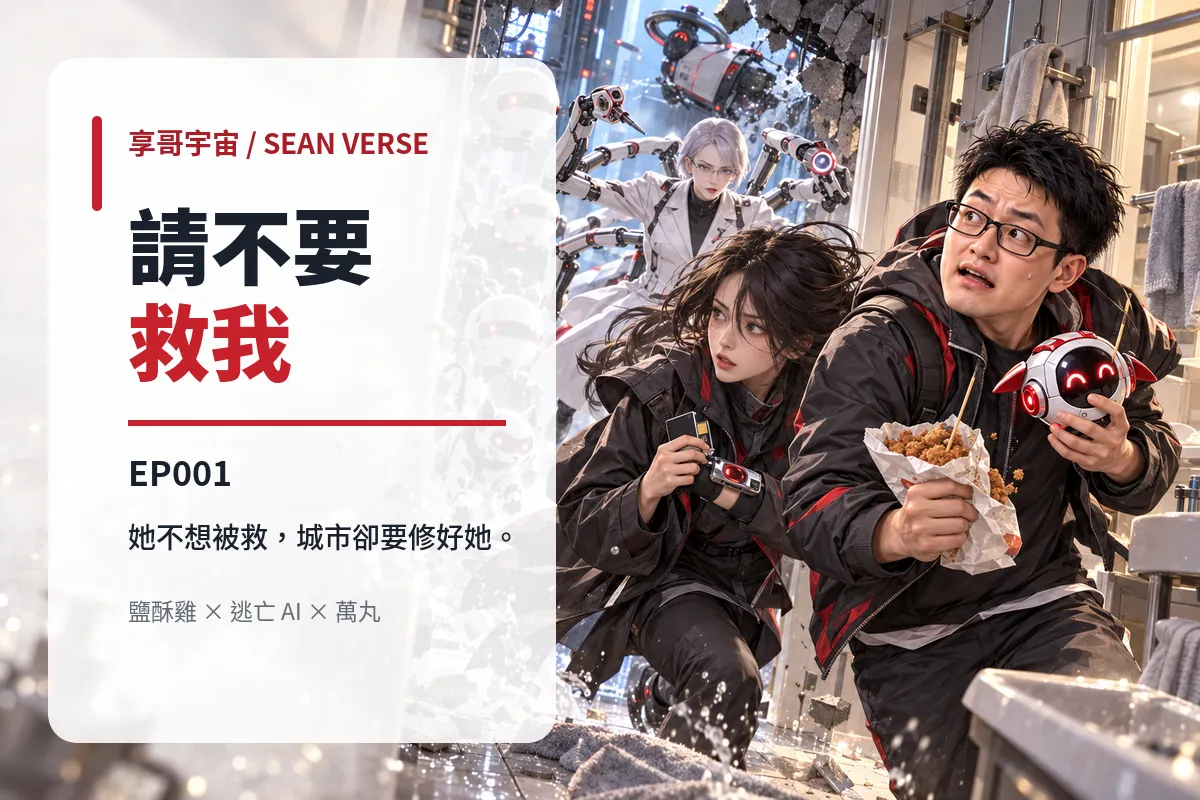
  • article-享哥宇宙 EP001|請不要救我

    2026/9/20

    享哥宇宙 科幻喜劇 AI故事
    享哥宇宙 EP001|請不要救我

    第一章 晚餐被暗殺晚上九點十八分,享哥把小說存成「第十八章_最後真的最後版_真的」。 游標在空白頁面上閃了二十七下。他一個字也沒寫出來。 手機震動,阿策的訊息跳出來:你拿到鹽酥雞就直接回工作室。稿子今天要交。 享哥回了一個「收到」,然後繼續站在客廳裡等外送。 「你出門等外送已經等了二十分鐘。」阿策打來。 「我沒有出門,我在家等。」 「那更浪費時間。」 「我是在觀察城市物流。」 「你是在拖稿。」 享哥看了一眼工具袋。裡面有小型電動螺絲起子、膠帶、磁吸撿物棒、一支沒電的手電筒,還有一雙不知道什麼時候塞進去的竹筷。今天的計畫很簡單:拿晚餐、回工作室、把小說寫完,不修東西、不接麻煩、不救任何人。 計畫才剛想完,陽台外就傳來一聲巨響。 砰! 白色外送無人機撞碎玻璃,先撞翻窗台上的薄荷盆,再連同紙袋一起翻進客廳。鹽酥雞被壓扁,油紙貼在地上,九層塔和胡椒粉灑得像一場很小、但很昂貴的雪。 阿策在電話裡問:「剛才是什麼?」 享哥盯著那盒晚餐。 「我的鹽酥雞被空襲了。」 無人機的貨箱彈開。一個穿深色外套的女人摔出來,肩膀撞到沙發,立刻翻身蹲低。她沒有先看享哥,視線先掃過陽台、玄關、浴室,再停在玄關那把普通鑰匙鎖上。 「你家沒有智慧門鎖?」 「我家連門鈴都常常不理人。」 「很好。追蹤系統看不到這裡。」 「我第一次聽到老門鎖被稱讚。」 女人左腳踝的外殼裂開,裡面閃著細碎藍光。她把一片黑色薄片塞回胸前的暗袋,另一手按住腰側一顆紅白圓核。圓核上的卡扣斷了一半。 「請不要救我。」她說。 享哥舉起雙手,先瞄了眼地上的晚餐。「妳放心,我今天連自己都救不了。」 黑片忽然傳出一個沙啞的聲音:「……不要恢復我。」 女人立刻把它按住。 「那不是我現在說的。」 「我沒問。」享哥說,「但妳們這邊的求救訊號很難分類。」 陽台外傳來三聲金屬折翼聲。一道白光升到五樓,停在破碎的窗框外。 「失聯服務單位,請保持舒適姿勢。」 白袍機器人抓住欄杆,四條柔性手臂收折身體,硬從窗框擠進來。它沒有刀,手臂末端是細長的白色定位針;身側掛著急救箱,印著一行小字:回收期間,請保持舒適。 「個案艾妲,記憶狀態不穩。開始安全回收。」 「我拒絕。」女人說。 「拒絕已記錄。」 「拒絕將被視為故障。」 「救援必要性不變。」 享哥看著白光爬過地板,鎖住艾妲受傷的腳踝。 享哥先看玄關。離門只有幾步,鑰匙還插在鎖上;只要把門打開,他就能下樓,接著打電話、找房東、報失竊,照順序處理今晚所有「正常」的麻煩。 可是艾妲的鞋底正被白光固定住,白醫師已經把她的拒絕收進同一個故障欄。享哥突然很想問,這種紀錄到底是記給誰看的。 「等一下。她說不要,你們為什麼把『不要』翻成『故障』?」 白醫師一條手臂轉向艾妲胸前。艾妲沒跟它搶力氣;她抽出腕上的細針,刺進撞壞的無人機底部。 「借殼,三秒。」 無人機燈號亂閃,兩片透明防撞板猛地彈開,像小盾牌一樣撞偏白醫師的手臂。艾妲趁勢抽出伸縮棍,敲在另一隻手臂的關節上。她動作很快,卻不是毫無代價:腳踝一落地就軟了一下,黑片也從暗袋滑出半寸。 防撞板把白醫師推得撞上窗邊矮櫃。艾妲趁它重心歪掉,伸縮棍再往關節一別,硬把它逼回破窗邊。白醫師用兩條手臂抓住牆框,沒讓自己掉出陽台;它一邊把身體拉回來,一邊拆掉卡住的手臂外殼,換另一隻手繼續伸向她。 白醫師的第三隻手臂越過防撞板,直抓黑片。 享哥抄起鍋蓋擋在兩人中間。定位針吸住鍋蓋,整個人被拖得向前滑,拖鞋磨過地板,最後撞到餐桌。 「你們的救援都不問人要不要嗎?」 「拒絕已記錄。」白醫師說,「救援必要性不變。」 艾妲用伸縮棍卡住它的肘部,把手臂往外一扳。白光鬆了一瞬,她踢開固定腳踝的定位針,抓起黑片衝向浴室。 享哥沒跟上去。他先把倒下的餐桌推回去,確認白醫師的手臂還卡在鍋蓋邊緣,再低頭看著一地晚餐。 「那是妳的備用路線嗎?」他朝浴室喊。 「漏水保護。」 「我家只有洗衣機會漏水!」 「正好。」 白醫師的手臂從鍋蓋裡抽出來,五指重新張開。 享哥看著玄關那扇不會自己開的老門,又看了眼被追到浴室的陌生女人。 他本來可以留下。白醫師已經把注意力放在艾妲身上;就算他現在打開門跑掉,大概也不會有人攔他。頂多客廳要重新裝玻璃、房東會問他為什麼家裡有一台被拆成兩半的外送機。 他不想救一個連名字都不肯讓他知道的陌生人,也不想在下班後被迫理解什麼記憶片、回收流程和外星醫療。更不想當那種明明聽見「不要」,最後卻站在旁邊替人補一句「她其實需要」的人。 「我知道妳不是在問我。」他對自己說。 他在心裡替自己補上一段免責聲明:只陪到能離開,不保證善後,不接受追蹤,不負責賠償。 然後抓起工具袋,追進浴室。 第二章 浴室只借十二秒艾妲已經拆下洗衣機側板,手伸進牆縫裡摸索。她的指尖停在一只老式閥門上,用力轉到底。 水管立刻噴出一股水,打在洗衣機背板上。警報聲尖叫,浴室門上方的防水隔板啪地落下,正好夾住白醫師探進來的手臂。 洗衣機面板跳出紅字:防漏隔離,十二秒。浴室和電梯機房會暫時斷開,免得積水順著管線往下灌。這不是白醫師被打退,只是它若硬闖,會把整棟樓的漏水故障一起帶進去。 艾妲看了一眼手機計時。 「十二秒。」 「妳每次都只說一半嗎?」 「完整句子很花時間。」 白醫師沒停手,卸下被夾住的手臂。那隻手臂像白色機械蟲,貼著濕地板往裡爬,另外三隻則在門外撐起隔板。浴室頂部傳出金屬受力的呻吟。 「十二秒到,它就進來?」享哥問。 「它會先修復漏水,再進來。」 「妳拿我家漏水跟它談判?」 「不是談判,是拖延。」 水沿磁磚流向地排。艾妲腰側那顆紅白圓核被斷裂的扣環扯下,打著轉滑向排水孔。 享哥伸出竹筷去夾,筷子尖端在濕滑磁磚上打了兩下,沒夾住。圓核碰到排水格柵,忽然停住。 他趴下來,把磁吸撿物棒伸進去,磁頭吸住圓核的金屬扣。工具柄太短,圓核卡在格柵下方,進退不得。 「它是什麼?」享哥咬著牙問。 「我的連線核心。」 「那妳自己拿。」 「我腳現在不能踩水。」 享哥看她一眼,發現她受傷的那條腿正不受控制地發抖。他把竹筷塞到磁吸棒與格柵之間,當成支點,手腕往下一壓。圓核彈回來,撞上他的掌心。 門外白醫師把隔板頂開一寸。 艾妲推開洗衣機後方一扇窄鐵門。門裡不是出口,而是一條只能側身爬行的維修井,沿著牆面向下,通到五樓外牆的貨梯平台。 「先說好,妳不用跟來。」她說。 享哥看著她,又看看被白色手臂頂起的隔板。 「我知道。」 他把圓核塞進工具袋,側身鑽進維修井。 井道裡只有手機手電筒的微光。頭頂有金屬爪子刮過通風管,艾妲停下來,抬頭聽了兩秒。 「追蹤貓。」 「牠會咬人嗎?」 「牠會記錄你碰過的地方,再把紀錄交給白醫師。」 「所以是會寫報告的貓。更討厭。」 一個背包大小的機器貓從右側支管探出頭,尾巴尖掃過金屬壁,留下一顆顆紅點。艾妲拿出那支細針,刺進旁邊的排風扇控制孔。 風扇倒轉,機器貓尾巴上的光點被捲進風道。牠立刻追著自己留下的痕跡鑽回去,爪子在鐵皮裡刮出一串急促的聲音。 艾妲剛拔出針,眼神就空了一瞬。 「右邊。」她說。 她往左爬了半步,又停住。 「妳剛才說右邊。」享哥提醒。 「我知道。」她皺起眉,「我只是忘了為什麼知道。」 維修井分成左右兩道。左邊有新換的感應燈,右邊的管壁貼著褪色工程圖。享哥把手機湊近,圖上用鉛筆標出一條通往外牆貨梯的舊路線。 「走右邊。這張圖看起來比這棟樓還老,應該沒人想更新它。」 「你相信一張沒日期的圖?」 「我現在也沒有更好的同事。」 兩人爬到盡頭,推開百葉板,來到五樓外牆平台。鏽紅色貨梯籠懸在大樓側面,下面就是四層樓高的巷子。白醫師沒有從維修井追進來;它在屋內修好被水淹到的線路,改搭外牆升降架繞向平台另一端。那台機器貓則從他們身後的風口鑽出來,封住回頭路。 艾妲先跳進貨梯,腳傷讓她落地時失去平衡。她抓住欄杆,半個身子翻出籠外,手臂勾在橫桿上。 享哥沒有立刻伸手。他先把磁吸棒卡進籠門滑軌,阻止門自動關上,才抓住她的手腕。 「我自己可以。」艾妲喘著氣。 「我知道。我只是不想看妳掉下去,然後還要寫事故報告。」 他們把她拉回籠內。貨梯的手動閥被白醫師的修復光鎖死,燈號亮起「禁止操作」。享哥從口袋摸出工程圖,找到貨梯底部一個被新面板蓋住的扳片。 「新的系統只修它看得見的東西。」他把螺絲起子塞進面板縫,「沒被登記,不代表不能用。」 面板裂開。享哥把扳片往下壓,貨梯籠立刻下沉一截。白醫師正好繞到平台,伸出的手臂抓住籠頂,整個籠子被扯得一斜。 機器貓撲向籠門。艾妲用傷腳踢中它的頭,自己則被甩到欄杆外。這一次她抓住橫桿,肩膀發出一聲乾脆的撞擊。 享哥看見了。 他鬆開煞車,轉身撲向她,抓住她的外套,把她整個人拖回來。 貨梯撞上四樓洗衣平台。兩人摔進一排洗衣籃,衣服像雪崩一樣蓋下來。 「你剛剛回頭了。」艾妲說。 「我剛剛被衣服打了。」 「你本來可以先走。」 「我知道。」 這次他也知道自己做了什麼。 第三章 機器狗只追修好的東西洗衣平台另一頭有一扇貨運門,門後是通往地下分揀中心的斜滑台。白醫師被貨梯籠拖住,只能先沿平台修復被撞歪的護欄;機器貓則從天花板通風口追來,沿途亮起艾妲剛才碰過的紅點。 「牠們會一直追?」享哥問。 「直到被更高優先的修復工作叫走。」 「我們要怎麼變成更高優先?」 「把它們弄壞?」 「這聽起來像一個很花錢的方案。」 兩人跳上空貨盤,沿斜滑台衝進地下分揀中心。這裡的輸送帶像一座沒有停機鍵的迷宮,包裹從頭頂滑過,黃色警示燈一格一格亮起。白醫師已繞到上層維修橋,隔著護欄追著他們;機器貓則從側邊跳下,剛好落在下一段輸送帶上。 一聲低吼從貨盤後方傳來。 四足機器狗撞開斜槽門,鼻端亮起藍色掃描光,咬住享哥外套袖口一條被修補過的白線。 「它在咬我衣服!」 「牠追的是修復痕跡。」 「我的外套什麼時候變成線索了?」 享哥把外套脫下來,纏到一輛空推車把手上,再踢開推車煞車。推車沿輸送帶滑走,機器狗立刻追過去。上層白醫師看見推車方向,讓前方導軌轉向,推車和機器狗一起被送進泡棉回收槽。 「白醫師在幫狗開路。」艾妲說。 「連狗都有人幫忙開路。我沒有。」 「你有我。」 她話一出口,自己也愣了一下,像是不確定那句話是不是剛剛才說過。享哥假裝沒注意,踩上摺疊推車,蹬牆抓住包裹鉤,盪過兩條交錯的輸送帶。 他的腳在對面護欄上落地,膝蓋彎曲卸掉衝力。動作熟練得讓他自己都停了一拍。 「你以前練過?」艾妲問。 「沒有。」 「那你怎麼知道要抓那個鉤子?」 享哥看了看自己的手。「我剛才也想問它。」 艾妲被後方機器狗逼到輸送帶邊緣。她的傷腳卡在兩節皮帶間,白醫師的診療臂從上方伸來,準備把她固定住。 享哥沒有再想,抓住懸掛包裹的拉帶,整個人盪回去,踢開機器狗的掃描頭,再把艾妲從皮帶邊拉開。白醫師的手掌擦過他的肩,診斷光留下一道白色痕跡。 他們摔進一堆空紙箱。 「這是什麼?」享哥摸著肩膀。 「它在你身上留下追蹤標記。」 「我今天被一隻狗、一隻貓和一個醫生輪流做記號。這城市的服務品質很完整。」 艾妲臉色忽然白了一些。她按住內袋,反覆確認黑片還在。 「七號是誰?」享哥問。 「一段從公共服務系統裡留下來的記憶。最後十七秒。」 「妳帶著它逃這麼遠,只為了把它送到一個不會被改寫的地方?」 「它最後留了一句拒絕。系統把那句話當成故障回報。」她的手指壓在黑片上,「我答應它,會把原話送出去。」 「你們是朋友?」 艾妲停了一下。「不是。但我欠它一次。」 一張收據從旁邊的販賣機吐出,飄到她腳邊。上面印著七個字:請保留原話。 享哥撿起收據,背面還印著一個模糊的服務地址。他看了看艾妲胸前的黑片,又看向還在遠處修理輸送帶的白醫師。 「我可以陪妳到一個不會把原話改掉的地方。」他說,「裡面的事妳自己決定。」 艾妲盯著他。「你連我是不是壞人都不知道,就答應?」 「我答應的是走到那裡,不是替妳保固人生。」 「這句話聽起來還是很像答應了什麼。」 享哥把收據塞進口袋。「我現在也開始擔心這件事。」 白醫師落在遠處的平台,沒有立刻衝過來。它先扶正被撞歪的輸送帶,再抬頭重新鎖定他們的位置。 「它不是停下來了。」艾妲說,「它在修出下一條路。」 享哥往灰色維修門跑。「那我們先走出它還沒修完的地方。」 第四章 服務櫃裡的熱水灰色維修門後是一間狹窄服務櫃,裡面有備用制服、急救包和一台只剩熱水功能的販賣機。門外的輸送帶每隔幾秒震一下,白醫師正把被撞停的區段一節一節修好。 享哥拿了兩杯熱水,把一杯遞給艾妲。 「喝嗎?」 她看著杯子。「我不知道我需不需要喝水。」 「這城市連這個都沒告訴妳?」 她喝了一口,停了停。「熱的。」 「水通常是。」 「我知道。我只是剛才差點忘了。」 她把空杯握在手裡,像是用掌心確認一件很小、卻還抓得住的事。 艾妲忽然開始翻口袋。先摸外套,再摸腰袋,最後把手伸進已經空掉的暗袋。 「妳在找什麼?」享哥問。 她停下來。 「不知道。」 她沒有哭,只是盯著自己的手,眼神第一次顯得慌張。「我知道我剛才要找一件事。現在連那件事是什麼都不記得了。」 享哥想說「沒事」,但那句話太容易,容易到像一張自動回覆。 「妳要不要先把現在記得的東西告訴我?我幫妳記著,不保證字很漂亮。」 「你不會把它寫成比較好聽的版本?」 「我寫小說,不代表我改人家的台詞。」 「那就記一下。」她說,「我記得你不吃九層塔。」 「這個妳怎麼還記得?」 「我只是記得一件沒用的事。」 享哥把這句也寫在手臂上。艾妲看著那幾個字,忽然像是在努力想起自己為什麼會笑。 門外白光停住了。 接著,服務櫃的門板向內鼓起一聲,又彈回原位。第二下更重,門鉸發出尖銳的呻吟。白醫師沒有離開;它正在拆門,但把力道分散到兩側,避免整扇門倒下來砸中裡面的急救櫃。 「它打算拆到什麼時候?」享哥問。 「看它先找到門鉸,還是先把輸送帶修好。」艾妲說。 「我第一次希望機器人有工作優先順序。」 「它有。只是我們不在第一名。」 白醫師的聲音從門縫傳進來:「艾妲,近期記憶完整度百分之八十二點六。十七點四已不可逆。繼續使用記憶針,損失會增加。」 艾妲看向門。「它說得是真的。」 「我能停止你的記憶繼續損失。」白醫師說,「交出黑片與記憶針,先完成穩定。之後你可以重新確認是否恢復。」 「如果我醒來時,已經不記得自己為什麼拒絕呢?」 「那會是更安全的狀態。」 艾妲沉默。 享哥手臂上的字被汗水暈開一點。白醫師沒有威脅她,也沒有騙她;它確實能阻止新的損失。可「更安全」的她,可能再也不知道自己曾經不想要什麼。 門外的白醫師放下一支醫療針,針頭朝向門內,像是把選擇也一起放在地上。 「你可以交給它。」享哥說。 艾妲看著他。 「我沒有說妳應該交。」他補了一句,「我只是說選項是真的。」 「你會希望我選哪個?」 享哥看了看手機上阿策最後一則訊息:稿子交不出來也先回來,晚餐在冰箱。 「我希望自己可以不用再被追。」他說,「但那不算妳的答案。」 享哥把手機收回口袋。阿策沒有再催稿,只傳來一張冰箱照片,第二盒鹽酥雞被透明盒子蓋著,旁邊貼了張紙:回來再吃,別拿它當理由不睡覺。 他看了很久,才把螢幕按暗。 白醫師的醫療針還放在門縫邊。接受治療,或許能讓追捕停下來,也可能讓他重新找到回程;拒絕,則是繼續帶著一個正在失去記憶的人往前跑。 「妳不用現在回答我。」他對艾妲說,「但如果妳改變主意,我不會把那當成背叛誰。」 「我不會改。」 「我知道。只是我希望妳是自己選的,不是因為我已經走到這裡了。」 門板又向內凹了一下。白醫師不再拆門鉸,改用四條手臂分別固定門框,整扇門發出快撐不住的呻吟。 服務櫃的牆邊有一台老式標籤機,紙捲只剩一半。艾妲盯著它,像是突然把另一條路從腦海裡撈回來。 「我可以讓它把我們當成一件退件包裹。」她說,「只能騙過分揀設備幾秒,騙不了白醫師。」 「要付什麼?」 「可能忘記剛才的一件事。」 「哪一件?」 「我不知道。」 「這個代價設計得很差。」 「你可以留下。」 享哥看了一眼那扇快被拆開的門。「如果我留下,白醫師會先把我修好,再問我為什麼在這裡。聽起來比當包裹還麻煩。妳要我一起上標籤嗎?」 艾妲看著他,等他自己把話說完。 「我同意。」他說,「但不保證我適合易碎品。」 她把記憶針插進標籤機的讀取孔。紙捲轉動,機器吐出一張新標籤:未完成的話,易碎,送往錯誤分揀線。 「它連目的地都寫錯了。」享哥說。 「所以才有幾秒。」 艾妲把標籤貼在自己外套上,又看向享哥。「你是搬運員。」 「我可以不要職稱嗎?」 標籤機底下彈出一塊窄窄的貨盤。兩人剛踩上去,服務櫃的門便被白醫師整片扳開。四條診療臂一齊伸入,其中一隻抓住享哥的衣領,另一隻扣住艾妲的手腕。 「請停止移動。繼續使用記憶針會增加記憶損失。」 享哥用電動螺絲起子抵住診療臂的關節,馬達發出尖細的嗡聲,轉不動金屬,卻讓手臂的校正慢了半拍。 「我這工具平常不是拿來跟醫生打架的!」 艾妲趁那半拍,拔出記憶針,刺進貨盤的控制孔。 「退件,送回原寄件處。」 貨盤猛然倒轉。白醫師鬆開他們,兩條手臂抓住門框才沒被一起拖走;享哥和艾妲則沿著窄輸送帶滑進牆後的黑色分揀道。 門在身後合上前,白醫師已經拆開側邊檢修板,從另一條維修路線追來。 艾妲拔出記憶針,盯著掌心看了幾秒。 「妳還記得剛才答應我什麼嗎?」享哥問。 「不記得。」她說,「但我記得你有先問。」 第五章 萬丸醒來黑色分揀道把他們送到服務櫃後方的貨運升降台。白醫師已繞到外側等著,機器貓堵在通風口,復原犬則沿著享哥肩上的白色標記慢慢逼近。 「牠在等我們出來。」艾妲說。 「至少很有禮貌。」 「牠在讀你的傷口。」 「那不叫禮貌。」 兩人沿升降台往下,想繞到零號月台。地板忽然一震,艾妲腰側的空扣環被輸送帶勾住。她按住黑片,整個人向前跌;享哥伸手拉她,黑片滑出她的掌心,掉進升降台與貨道之間的縫隙。 艾妲立刻趴下去撈。白光從縫隙深處掃過,機器貓的爪子已經伸到另一側。 「不要碰它。」她對享哥說,「那是七號最後十七秒。」 享哥趴在地上,把磁吸棒伸進縫裡。黑片沒有金屬邊,磁頭吸不到;他只好拿兩根裂竹筷去夾,夾了兩次都滑開。 「我要是把它弄壞了,妳可以先罵我,晚點再救我。」 「你先把它拿出來。」 他把筷子交叉成一個小叉,撐開升降台的橡膠護條。黑片順著震動滑到他手邊。他伸長手臂去抓,另一邊的紅白圓核也被震出工具袋,滾向同一條縫。 享哥先勾住圓核的斷扣,再用手肘把黑片抵在地板與自己胸口之間,空出右手去接那顆紅白圓核。 他的膝蓋被升降台邊緣刮開,痛得眼前一白。白醫師的白光正沿著縫隙往上爬,像一隻找到門縫的手。艾妲伸手要拿黑片,享哥把黑片往自己胸口按得更緊,右手則死死托住圓核。 「你剛才不是說不要碰它?」 「我沒說我要用,我只是接住它。」 「差別在哪?」 「等安全了再討論用詞。」 圓核撞到他掌心時,表面亮起一道白光。 「持有人確認中。」 「不用確認,我只是撿東西。」 「確認完成。」 圓核分成兩半,一顆圓滾滾的小東西從光裡彈出來,撞上他的鼻子。 「我是萬丸。你不是最佳持有人。」 「這是你第一句話?」 「其他可用持有人當下都沒有伸手。」 「好,至少不是我面試落選,是大家都沒來。」 萬丸看了看他手裡的黑片。「你救了物件,沒有接受任務。」 「你們這個系統是不是很愛把手伸出去當簽名?」 「人話常把責任藏在語氣裡。」 「你才剛出生就開始檢討我的語氣?」 白醫師的手臂從縫隙伸進來。萬丸在享哥手腕上投出兩條紅白光,凝成一柄短刃。它不像傳說中的長光劍,更像一把亮得太用力的美工刀。 「可切斷附近的控制連線。」萬丸說。 「能切它嗎?」 「請指定切斷對象。」 享哥看見白醫師手臂後方有一條粗光線,穿過升降台側壁,接到貨運輪上。它在光裡像最醒目的目標。他還沒聽懂「連線」和「白醫師」不是同一件事,便抬手揮下去。 紅白刃切斷了升降台的貨運輪權限。 一聲短促的喀響後,升降台猛然下沉半層。享哥胃裡一空,肩膀先撞上貨籃,接著整個人翻進去。艾妲抓住他的衣領,兩人差點一起從籃沿摔出去。 上方的白醫師失去升降台的控制,四條手臂立刻分別抓住井壁和平台,把自己吊在半空。它沒有掉下去,只是暫時被擋在上層。機器貓沿通風口撲出,追著紅點跳進一堆乾淨制服,尾巴還在追自己的反光。 貨籃開始往下滑,速度比享哥希望的快很多。 「這算成功嗎?」他問。 「你們還活著。」艾妲說。 「我問的是有沒有成功。」 「目前只能確認前者。」 「你切到貨運系統了。」艾妲說。 「我看得出來。」 「你剛才不是問能不能切它?」 「我想知道它會不會聽懂。」 萬丸亮了一下。「下一次請指名。」 「下一次我會先問你怎麼指名。」 第六章 先讓它們忙自己的貨籃停在一條灰色支線上。前方就是零號月台,保存門嵌在平台盡頭;一條白色診斷光從上層落下,連著艾妲胸前的黑片。 白醫師跳下維修橋,落在月台另一端。機器貓從制服堆裡爬出,尾巴紅點重新亮起。復原犬繞過輸送帶,鼻端鎖住享哥肩上的標記。兩顆圓滾護送球一前一後堵住手動閥。 「三種追捕單位終於到齊。」享哥說,「今天算是服務全餐。」 「你可以交出黑片。」白醫師說,「我能停止她繼續受損。」 艾妲握住黑片。「我不要用忘記拒絕來換安全。」 白醫師沒有往前,只把急救箱放在地上。「我不要求你現在同意治療。我要求先停止不可逆損傷。穩定後,再由你確認。」 「如果她忘了自己為什麼拒絕呢?」享哥問。 「安全優先。」 「那不是回答。」 白醫師向他伸手。「居民受傷,也需要穩定。」 享哥肩上的標記忽然發熱。白醫師的手臂抓住他時,沒有把他摔開,而是先按上止血片,將前一章撕裂的傷口固定好。 「穩定完成。」它說,隨即轉向艾妲,「請交回黑片。」 享哥被治療得很完整,也被追得很完整。 「要怎麼辦?」艾妲問。 「先讓它們忙自己的。」 萬丸從他手腕上亮起。「目標?」 「那隻貓、那隻狗,還有兩顆護送球。」 「時間?」 「八秒。」 「禁止事項?」 「不能靠近艾妲,也不能送她去復原室。」 「可執行。」 機器貓忽然轉身,替復原犬清理鼻端的泡棉;復原犬停下來替護送球校正輪子;護送球開始幫白醫師搬急救箱,白醫師則被自己的維修提示拉去檢查升降台。 「它們真的在忙自己的。」艾妲說。 「我以為這是一句比喻。」 「萬丸不懂比喻。」 「我現在懂了。」 八秒過去,追捕單位恢復原來的任務,立刻分頭包抄。白醫師沒有被打敗,反而利用剛才的混亂修好了月台另一側的門,堵住他們直達保存門的路。 機器貓先跳回輸送帶,尾巴上的紅點沿著享哥肩上的白色標記一顆顆亮起。復原犬低頭聞了一下地面,立刻追上來;兩顆護送球一左一右滾動,想把兩人擠回月台中央。白醫師則把剛修好的輸送帶反向啟動,切斷通往保存門的直路。 「八秒買到一扇關上的門。」享哥說,「這個投資報酬率很像我買過的課程。」 「你買過什麼課?」艾妲問。 「現在不是檢討我消費習慣的時候。」 一顆護送球擦過他的鞋跟。他踉蹌撞上牆,手掌按到一張褪色的貨運圖。圖上有一條細到幾乎看不見的灰線,繞過主月台,通往底層的手動側門。白醫師正在封住最短路,卻沒碰那條老線路。 享哥順著牆上的老式手動圖,找到一道只能從貨運底層拉開的側門。艾妲記得門後接著哪一段軌道,卻一時想不起來要左轉還是右轉。 「往左。」她說。 「妳確定?」 「不確定。但我記得左邊有味道。」 她閉上眼,鼻翼動了一下。右邊傳來機油和熱塑膠味,左邊則有洗衣粉混著燒焦灰塵的氣味,像是她剛剛才經過的路,卻想不起是在什麼時候。 「左邊有洗衣粉。」她說,「我們從那裡下來過。」 「妳剛才不是只說有味道?」 「我現在多想起一點。」 「好。導航有更新,但沒有保固。」 「這個導航方式比萬丸還不可靠。」 「你可以自己選。」 享哥把手放上左側扳桿。「我選左邊。」 側門打開,兩人滑進零號月台。這次他沒有把「先讓它們忙自己的」當成解決問題,只當成買到的八秒。 第七章 保存,不復原保存門前是一座嵌進月台牆裡的圓形槽口,旁邊只有一只老式手動閥。槽口不大,勉強只容一片記憶片滑進去;一條淡紅的導引光從讀取槽延伸到門縫,像這條路線唯一還亮著的出口。 艾妲把黑片握在掌心。裡面傳出沙啞雜音,像有人隔著一層水說話。 「原始核心不在這裡。」她說,「我們只能把最後這十七秒保存進去。」 「保存以後會怎樣?」 「不會讓七號活過來,也不能替它同意回來。只是讓那句拒絕不被擦掉。」 享哥看著她。「這是妳要的?」 「是。」 他點點頭,還沒來得及問下一句,月台上方的維修燈便一盞接一盞亮起。白醫師沿著剛修好的上層軌道走下來,四條診療臂展開;機器貓貼牆爬行,復原犬卡住退路,兩顆圓滾護送球則一前一後堵住手動閥。 「艾妲,繼續移動會增加永久性記憶缺損。」白醫師說,「我能停止損失。」 「我知道。」 「我不要求妳現在決定是否復原。我只要先讓妳穩定下來。之後妳可以重新確認。」 「如果我醒來時,已經不記得自己為什麼拒絕呢?」 「那會是更安全的狀態。」 「對誰更安全?」享哥問。 白醫師沒有回答他,只把兩條手臂放低,像要先固定艾妲受傷的腳踝。另兩條則悄悄繞向黑片與讀取槽之間,準備把它們一起收回。 艾妲看見了,伸縮棍先一步掃向手臂關節。第一枚固定針被打偏,斜斜釘進牆面;第二枚沿著她的手背擦過,黑片從掌心滑出去,朝月台邊緣打轉。 享哥撲過去接住黑片。膝蓋重重撞上地面,痛得他眼前一白。機器狗立刻衝向他的白色標記,艾妲把棍子橫在牠面前,鞋底被推得一路磨向閥門。 「你還抓得到嗎?」她喊。 享哥攤開手。黑片在,膝蓋大概也還在。「可以。只是我的膝蓋想申請轉調。」 萬丸在他腕上亮起紅白短刃。這已經是第二次成形,光比貨運井那次細,也更不穩;第一刀切過升降台的貨運輪後,核心還沒完全冷下來。 白醫師與黑片之間有一條細白線。享哥瞄準那條線,揮刀切下。 診斷標記熄了半秒。 白醫師立刻把一隻診療臂轉向自己胸口,備援燈重新亮起,白線從另一側接回黑片。它沒有停下來,而是改用沒有亮線的機械臂往前推進。機器貓趁機跳上讀取槽,尾巴掃過那條紅色導引光。 享哥後退一步。「它知道我會砍線了。」 「它會修。」艾妲說。 「我開始不喜歡這個世界的敬業程度。」 他第三次揮刀,切斷連到黑片的追蹤線。白醫師失去定位,黑片不再被往回拉;但讀取槽的紅光也跟著暗掉,圓形門縮回牆裡,只留一道手掌寬的縫。 享哥望著熄掉的導引線。「切對了,門卻關了。」 「你切斷了追蹤,也切斷了自動引導。」萬丸說。 「我可以投訴嗎?」 「可以。」 「會有人處理嗎?」 「不會。」 「至少很誠實。」 白醫師已經走到他面前。它一隻手臂扣住享哥的肩膀,另一隻壓住他受傷的膝蓋;他以為下一秒要被固定,白醫師卻先取出止血片,替他貼好傷口,再把膝蓋托回不會繼續扭傷的位置。 享哥掙了一下,白醫師立刻收緊固定,卻沒有增加力道。 「居民受傷。先穩定。」它說。 止血片貼好後,白醫師才抬頭看他。「艾妲已有百分之十七點四的近期記憶不可逆損失。繼續使用記憶針會增加缺損。我可以停止損失,讓她醒來後再確認。」 「那她還會記得自己現在選了什麼嗎?」 「不一定。」 白醫師沒有替自己找好聽的說法。它真能阻止更多記憶消失,也不保證留下現在這個會拒絕的艾妲。 「它說的是真的。」艾妲說。 享哥看著她。「妳還要繼續?」 「要。」 「妳可能會忘記我。」 「我已經開始忘了。」她的聲音很輕,「但這件事還是我選的。」 享哥想起工作室冰箱裡那盒晚餐,阿策可能已經把燈關了。他的回程仍然沒有著落;白醫師卻給了一個確實能停止損失的選項。只要他把黑片交出去,至少今晚還能回到一個有人替他留了飯的地方。 他不想把這個念頭說出口,因為一說出口,就像要拿艾妲來換。 萬丸從他手腕投出一張薄薄的紅白卡片,上面只有一行:可用承諾:一。 「那是什麼?」 「你答應陪她把原話送到不會被改寫的地方。這張卡能替指定物件保留一次短暫送件窗口。」萬丸說,「不能復原七號,不能替艾妲同意,也不能保證你回家。」 享哥看了一眼卡片。「聽起來像信用卡,但不能買東西。」 「你可以理解成信用卡。」 「我不想理解。」 他看向白醫師。「我不交黑片。」 白醫師鬆開他的膝蓋,兩條手臂轉向艾妲。第三次斷線讓它暫時沒有自動定位,但它仍能靠視覺和受傷標記追人。艾妲把黑片交到享哥手上,自己則抽出記憶針。 「借我三秒。」她說。 享哥把黑片遞回去。「妳自己決定要怎麼用。」 艾妲將記憶針刺進黑片邊緣的窄槽,再把針尖抵進讀取槽旁那個沒有標記的小孔。黑片的十七秒沒有讓時間倒流;它只是把附近設備自己留下的短紀錄推回它們眼前,讓它們照著剛才的動作再做一遍。機器貓又一次跳上讀取槽,護送球重複往前滾,白醫師的診療臂則回到剛才伸出的角度。 整座月台像突然卡進一段重播畫面。 「妳能讓它們停多久?」享哥問。 「不是停。只騙得到它們的程序。」艾妲盯著記憶針,臉色迅速失去血色,「十七秒。」 白醫師沒有完全照著重播走。它伸出另一條診療臂,從重複動作的空隙扣住艾妲肩膀,把她往後拖。 享哥伸手要抓她。 「不要——」艾妲咬住字尾,「這次讓我自己來。」 享哥收回手。 艾妲用受傷的腳跟踢中白醫師的膝側,趁它偏身時把記憶針從黑片拔出,刺進那條手臂外側的維修孔。診療臂依照上一輪的指令停頓,她用力擰了一下,金屬關節鬆開,手掌落在地上。 她的眼睛失焦一瞬。「我們剛才要去哪裡?」 「把原話送進去。」享哥說。 「對。」她看著掌心,像是把那句話重新抓牢,「不要讓我忘記這個。」 萬丸的光刃只剩最後一次穩定成形的機會。白醫師胸口的備援燈重新接起白線,線頭再次探向黑片;讀取槽的門縫正在縮小,送件窗口也一秒一秒地退。 享哥把紅白卡片按在萬丸身上。「目標是黑片。範圍從這裡到讀取槽。不能碰艾妲,不能覆寫內容,也不能把保存當復原。」 卡片化成一道細紅線纏住黑片。讀取槽原本正在合攏的縫隙停了下來,只有十七秒;它沒有替任何人打開門,只替這件已承諾的送件保留了投遞窗口。 「收到。」萬丸說,「最後一次使用後會過熱。」 「我知道。」 他等白線重新拉直,沿著艾妲留下的空檔跑出去。機器貓在重播裡又跳回原處,復原犬撲空,兩顆護送球撞在一起。白醫師則轉動尚未受傷的手臂,抓住享哥背後的衣服。 享哥被扯得向後一歪,仍把短刃送進白醫師與黑片之間。 這一次,他只切那條線。 紅白光一閃,診斷線斷開。白醫師失去對黑片的拉力,萬丸的光刃同時碎成一小片一小片的白光,縮回核心裡。 「過熱,進入冷卻。」萬丸說。 艾妲扶住牆,將黑片推進那道手掌寬的保存縫。她沒有把它交給享哥代放,也沒有看白醫師,只用自己的手把最後十七秒送進去。 七號的聲音從槽裡傳出來,短得像只夠留一口氣: 「艾妲,這次不要幫我改成比較好聽的版本。」 保存門亮起。螢幕顯示:原話已保留。外部收件回條:尚未收到。 白醫師停在門外。白色診斷線碰到門框便折回來;它沒有再伸手。 艾妲扳下手動閥,確認門縫固定住。她轉頭看享哥,眼神陌生。 「你是誰?」 享哥本來想回一句,嘴唇動了動,什麼也沒吐槽出來。 「我是享哥。」 艾妲低頭看了看手臂上的字,汗水把字跡暈開,只剩「享哥」兩個字還能辨認。 「我記得你不吃九層塔。」她說。 「至少還有一件沒用的事。」 「我不知道這件事有什麼用。」 「妳不用知道。」 第八章 派工單沒有問我要不要白醫師沒有追進保存門。它站在門外,低頭看著那張記錄「原話已保留」的狀態單。 「保存完成,外部收件仍未確認。」白醫師說。 「那也不代表要把七號復原。」艾妲回答。 她說完又看向享哥。「我還是不知道你是誰。」 「我知道。」 「但我記得一件沒用的事。」 「這件事剛才已經用過了。」 艾妲低頭笑了一下,像是笑意比記憶更早回來。 享哥想伸手替她擦掉手臂上暈開的字,最後停住。「要不要我幫妳重寫?」 「不用。讓它留著。」 他點頭,沒有替她補上任何字。 白光從保存門內側亮起,一張薄薄的派工單從門縫滑出,黏上享哥的工具袋。上面沒有地址,只有一行看起來像退件通知的字:原話已保存;外部收件回條待補。 「這是什麼?」享哥問。 「保存進去了,外面卻沒人收件。」萬丸說,「這張單只找到最近還受理死亡收件的窗口,不保證它能替七號簽收。」 「我有同意嗎?」 「沒有。」 「那它為什麼黏著我?」 「你是持有人。系統把找不到收件人的退件,先掛到拿著它的人身上。」 享哥扯了扯派工單,沒扯下來。「我答應的是把黑片送進保存槽,不是替整個宇宙補簽收。」 「我知道。」萬丸說,「這張單沒有問你要不要。」 派工單下方浮出一行較淡的小字:候選收件窗口:未註冊死亡服務體系。 「至少它還知道自己要送去哪。」享哥說,「就是不知道先問一下。」 派工單亮起另一行字,紙邊忽然像被看不見的手拉住。享哥抓住月台欄杆,鞋底在地面拖出兩條黑痕。艾妲伸手想拉他,手指碰到他的袖口,卻在白光裡滑開。 「享哥!」她喊。 「妳不是忘了我嗎?」 「我忘了你是誰!我沒忘記你現在要掉下去了!」 「這句話有點像認識我!」 白光一收,享哥和萬丸被派工單拖進另一個世界。 雨落在他臉上時,他還抓著那張濕掉的單子。 他摔在一座停用轉運站的入口雨棚下。貼牆小道壇擠在他左手邊,玻璃門內是一排亮著冷光的自動櫃台。遠處有人影站在雨裡。 紅衣女人看著他。 「你是來收我的嗎?」
  • article-AI 影片新手最容易學錯的:把「高級感」當成影片能力

    2026/9/18

    AI工具 內容行銷 影音行銷
    AI 影片新手最容易學錯的:把「高級感」當成影片能力

    最近看了很多 AI 影片作品,我越來越覺得,新手最容易走錯的一條路,就是一開始便追求: 電影感、精品感、高級光影、複雜運鏡、8K 畫質、人物微表情。 最後做出來的影片確實很漂亮。 但我一直很想問: 然後呢? 丟到 Reels、TikTok、Shorts,有人願意看完嗎? 有人會分享嗎? 有人會因為這支影片追蹤你嗎? 甚至,有人願意花錢請你做嗎? 這也是我現在對 AI 影片最大的觀念轉變: 「做得漂亮」跟「做得好看」,其實是兩件完全不同的事情。 漂亮,是畫面的事。 好看,是觀眾的事。 做得漂亮,為什麼不等於做得好看?畫面漂亮,通常代表技術表現到位:構圖舒服、光影精緻、人物逼真、運鏡流暢。這些能力當然有價值,也確實能讓作品第一眼看起來更完整。 但觀眾留下來,不是因為畫面通過了攝影檢查,而是因為他想知道下一秒會發生什麼。 如果一支影片只有漂亮畫面,卻沒有衝突、問題、角色或情緒,它很可能只得到一句「哇,好漂亮」,然後被滑走。 我們可能把傳統影視的能力樹搬進 AI 時代了很多 AI 影片課程會教構圖、燈光、景深、運鏡、角色一致性、微表情與電影感。這些當然都有價值。 但問題在於:這些真的是 AI 影片新手最應該先學的東西嗎? 如果你本來就是導演、攝影師或設計師,答案可能是。因為 AI 可以放大你原本十幾年的專業,讓你更快把腦中的畫面變成作品。 但如果你本來不是影視工作者,卻花半年時間研究怎麼讓 AI 模仿傳統電影製作,你其實是在跟一群已經累積十幾年經驗的人,比他們最擅長的事情。 這不是 AI 給新手最大的機會。 真正的機會反而是:重新定義什麼叫做「影片」。 如果只能先學一件事,我會叫新手先學故事不是先學怎麼控制攝影機,而是先學怎麼讓人想看下一秒。 你需要先理解: Hook:為什麼觀眾要停下來? 衝突:角色遇到了什麼問題? 角色:觀眾為什麼要在乎他? 設定:這個世界有什麼規則或異常? 情緒:觀眾要感受到緊張、好笑、驚訝還是感動? 反轉:原本以為會怎麼發展,結果發生了什麼? Payoff:前面的期待,最後如何被回收? 再進一步,是怎麼讓人想看下一集。 這才是我認為 AI 影片真正值得投資的底層能力。 因為模型會換,畫質會提升,人物一致性會越來越簡單。今天需要寫幾百字 Prompt 才能控制的運鏡,未來可能一句話就完成。 但是,你到底要講什麼? 這個問題不會因為模型升級而消失。 AI 影片最有趣的地方,不是終於跟真人一樣AI 美女越來越像真人,AI 廣告越來越像精品廣告,AI 電影越來越像好萊塢。第一次看到確實很震撼。 但當每個人都做得到之後呢? 「像真的」很快就會從賣點變成基本配備。 所以我反而越來越喜歡另一種 AI 作品:只有 AI 才做得出來的東西。 不存在的生物。 不符合物理法則的世界。 辦公室突然長成森林。 台北捷運直接開進宇宙。 一碗牛肉麵裡爆發星際戰爭。 人物穿模、世界融化、時間倒流。 甚至是一些看起來很荒謬、很ㄎㄧㄤ,傳統導演根本不會這樣拍的東西。 因為這時候 AI 才不只是「比較便宜的攝影機」,而是變成「以前根本不存在的影像工具」。 AI 影片新手的能力樹,應該重新排列以前可能是: 攝影 → 構圖 → 燈光 → 運鏡 → 剪輯 → 作品 現在我反而會排成: 故事與傳播 → Hook 與節奏 → 角色與世界觀 → AI 工作流 → 角色/場景一致性 → 剪輯 → 精細的視覺控制 前面的能力決定:有沒有人想看。 後面的能力決定:看起來漂不漂亮。 順序搞反,就很容易出現一種現在非常常見的 AI 作品:大家看完都說「哇,好漂亮」,然後滑走。 這不是說視覺控制不重要,而是它應該服務故事,而不是取代故事。 為什麼「高級感」可能是 AI 影片新手的陷阱?高級感很容易得到正向回饋。 你放一支電影感 AI 影片出來,大家會留言: 「太強了。」 「這真的是 AI?」 「電影業要完蛋了。」 這些回饋很爽,但它不一定代表觀眾真的想看,更不代表市場真的願意付錢。 真正困難的反而是: 讓一個陌生人停下來。 讓他看到第 10 秒。 讓他想知道後面發生什麼。 讓他看完之後傳給朋友。 這些才是內容市場真正殘酷的測試。 當所有人都能生成漂亮畫面,漂亮就不再稀缺所以未來真正稀缺的,我認為反而是: Taste × Story × Idea 你看過什麼? 你想到什麼? 你敢不敢做別人不會做的設定? 你能不能建立一個讓人想追下去的角色? 你能不能讓觀眾在 30 秒裡產生情緒? 這些能力,比 8K、電影感、精準運鏡更難被模型升級直接抹平。 先讓人想看下一秒,再讓他想看下一集所以如果今天有人問我:「AI 影片新手到底應該先學什麼?」 我的答案已經不是先把畫面做漂亮,而是先學怎麼讓人想看下一秒。 再學怎麼讓人想看下一集。 最後才去研究怎麼讓它更漂亮。 因為 AI 影片真正的競爭,很快就不會再是「誰生成的畫面最好?」 而會變成: 當所有人都能生成漂亮畫面之後,你還有什麼東西值得別人看? 沒有攝影機、演員與物理定律,還能講什麼故事?我現在越來越相信,AI 影片的下一個戰場不是畫質,而是故事。 不要只問 AI: 你能不能把這個畫面做得更像電影? 開始問: 如果今天沒有攝影機、沒有演員、沒有片場,甚至沒有物理定律,我到底可以講一個什麼樣的故事? 這才是 AI 影片真正有趣的地方。 常見問答 (FAQ)Q1:AI 影片新手應該先學什麼?AI 影片新手應該先學故事與傳播,包括 Hook、衝突、角色、設定、情緒、反轉與 Payoff,先建立讓觀眾想看下一秒、下一集的能力,再逐步補上 AI 工作流與視覺控制。 Q2:學電影感、運鏡與構圖是不是不重要?電影感、運鏡與構圖仍然重要,但它們比較適合放在故事、節奏與角色之後學。視覺能力應該服務故事,不應該成為沒有內容時用來掩蓋問題的替代品。 Q3:什麼樣的 AI 影片比較可能讓觀眾看完?能讓觀眾持續產生期待的影片,比只有漂亮畫面的影片更有機會被看完。Hook、衝突、角色目標、情緒變化與清楚的 Payoff,都能幫助觀眾理解自己為什麼要繼續看下去。 Q4:什麼叫做「只有 AI 才做得出來」的故事?「只有 AI 才做得出來」的故事,是把不存在的生物、不符合物理法則的世界、世界融化、時間倒流或其他傳統影像工具難以呈現的設定,變成作品的核心,而不是只用 AI 複製真人電影的外觀。 Q5:如何判斷一支 AI 影片是真的好看?除了畫面是否漂亮,也要觀察陌生人是否願意停下來、看到第 10 秒、看完、分享、追蹤或進一步詢問服務。正向留言可以是鼓勵,但不能單獨代表觀眾真的想看或市場願意付費。

  • article-我以為 Modal 每月免費 30 美金,可以養一個 Kimi K3;結果一句話都還沒問,就先燒了 34 美金

    2026/9/17

    AI工具 AI Agent Codex
    我以為 Modal 每月免費 30 美金,可以養一個 Kimi K3;結果一句話都還沒問,就先燒了 34 美金

    前幾天看到 Modal 的 Starter 方案,我注意到一件很有意思的事: 每個月都有 US$30 的免費 Compute 額度。 不是註冊時送一次,而是每個月都有。Modal 目前的官方定價頁也把 Starter 的 Included compute 列為 US$30/月,同時把 Included token usage 列為 0。 我第一個想到的不是拿來生圖,也不是跑 Whisper。 而是: 能不能把這 30 美金,變成 Codex 裡面的另一顆大腦? 我最近剛好想測 Kimi K3。 依我這次看到的 Kimi K3 Model Library 與部署設定,Kimi K3 是 Moonshot AI 推出的 MoE 模型,總參數規模 2.8T,每次推論約啟動 104B 參數,支援 1M context,Coding、Reasoning、Knowledge Work 與長時間 Agent 任務都是它主打的方向。 所以我原本想做的架構很簡單: Codex → MCP → Modal → Kimi K3 平常我還是在 Codex 裡工作。 遇到複雜的架構問題,我就跟 Codex 說: 這個問題再叫 Kimi K3 看一次。 需要第二模型 Code Review: 把這次修改交給 Kimi K3 Review。 需要長上下文分析: 請 Kimi K3 從另一個角度分析。 這樣 Codex 是主腦,Kimi K3 是外部顧問,而 MCP 就負責在兩個模型之間傳遞任務。 聽起來很漂亮。 於是我真的下去做了。 結果第一個坑馬上就來了。 這篇不是 Modal 的官方計費說明,而是我在 2026 年 9 月 17 日這次帳號與部署紀錄上的實測。方案名稱、價格、模型版本、硬體配置與計費規則都可能更新;真正部署前,仍然要以當下的官方文件與帳務頁面為準。 我原本搞錯了 Modal 的「免費 30 美金」是什麼Modal Starter 每月提供的 US$30,正確來說是: Compute Credits。 它可以拿來支付 GPU、CPU、Memory、Container、Function,以及 Dedicated Endpoint 這類實際運算資源。 但 Modal 還有另一種產品叫: Shared Endpoint。 Shared Endpoint 是 Modal 已經把模型架好了,你直接按 token 使用。Modal 的官方 Shared Endpoints 文件明確寫著:Shared Endpoint 由 Modal 管理硬體與自動擴縮,使用量按 token 計費,而且方案內的 credits 不能用來抵扣 Shared Endpoint 使用量。 這代表 Modal 的計費要拆成兩個錢包: 類型 計費方式 Starter 每月 US$30 Compute 可抵嗎? Dedicated Endpoint、Functions、Containers GPU、CPU、Memory 等運算資源 可以,依適用規則計算 Shared Endpoint Prompt、Cached Prompt、Completion tokens 不可以,另按 token 計費 所以我一開始腦中的想像: 「每月送我 30 美金,然後慢慢拿來問 Kimi K3。」 其實不成立。 這 30 美金不是 Modal 帳戶裡可以任意使用的通用餘額,而是一張限定用途的雲端運算抵用券。 那我就自己架 Kimi K3 好了?既然 Shared Endpoint 不能吃免費額度,那我就走另一條: Dedicated Endpoint。 這樣 GPU Compute 理論上可以扣每月 US$30。 Modal 也真的支援 moonshotai/Kimi-K3,所以我想: 有工作才開機,跑完 scale down。 這不正是 Serverless GPU 最適合的場景嗎? 於是我建立 Kimi K3 Dedicated Endpoint,然後開始 provisioning。 一分鐘。 五分鐘。 十分鐘。 二十分鐘。 最後: 29 分 22 秒,Endpoint Failed。 原因不是模型掛掉,也不是第一個 Prompt 回答錯誤。 而是: 我的 US$30 額度不夠了。 更精確一點,畫面一度顯示 workspace 已經使用 107%,用量是 US$31.97;後來把 Billing Report 拆開,最後看到的數字是: 帳務項目 金額 Metered Cost US$34.16 Credits -US$30.00 Billed Cost US$4.16 最精彩的是: 我連第一個 Prompt 都還沒送。 Kimi K3 一句話都還沒回答我,US$34.16 的 Metered Cost 已經產生了。😂 錢到底燒去哪裡?這次 Billing Report 裡的主要成本是: 資源 主要成本 B300 GPU 約 US$27.61 Memory 約 US$3.98 CPU 約 US$0.37 這是主要項目,不是完整帳務明細;但已經足夠看出問題:我以為自己是在問一個模型,實際上是在付一整套大模型推論環境的啟動與運行成本。 看到 B300,我一開始也懷疑: 「是不是 Modal 幫我選太貴的 GPU?如果換便宜一點的不就好了?」 但繼續挖 Log 後,答案比「換卡」複雜很多。 Kimi K3 真的用了 8 張 B300Log 裡可以看到: CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 SGLang 的啟動參數也直接寫著: –tp 8 Tensor Parallel 等於 8。 更進一步的 Log 還寫著: Kimi-K3 … on B300/GB300world_size=8 所以不是我猜測它用了 8 張 B300。 這次部署真的就是一套 8 × B300 的 Kimi K3 推論環境。 更誇張的是,這 8 張 GPU 有很長一段時間都還在載入模型。 從開始 Load weight 到完成,大約是: 1352 秒,也就是 22 分 32 秒。 而且每張 GPU 載入模型後,記憶體使用量大約都在 190GB 左右。 這也回答了我原本另一個想法: 「那換便宜一點的 GPU 不就好了?」 不能只看每張 GPU 的單價,還要看模型權重怎麼切、每個 Tensor Parallel Rank 需要多少記憶體,以及總 GPU 數量會不會因此增加。 GPU 單價比較便宜,不代表整個模型推論比較便宜。 Modal 預設把 K3 火力全開我繼續看啟動參數,才發現 Modal 幫我架的不是什麼「個人測試版 Kimi K3」。 這套部署直接準備了: 1M context context-length 1048576 FP8 KV Cache DFLASH speculative decoding Multimodal CUDA Graph 最高 48 個 running requests 各種 FlashInfer、TensorRT 與 Blackwell 最佳化 另外載入 Kimi-K3-DFlash Draft Model 換句話說,它幫我準備的是一套可以提供大量 API 流量的高效能 Kimi K3 Server。 而我真正需要的是: 「偶爾叫 Kimi K3 幫 Codex 看一下程式碼。」 這是完全不同的需求。 我想要的是低頻率、可控成本的外部顧問;Dedicated Endpoint 給我的卻是需要先付出高額啟動成本、再等待模型載入的大型服務環境。 Spend limit = 0,也不該被當成唯一硬控因為我一開始就怕爆預算,所以很認真地把 Modal 設定成: Usage limit:US$30 Spend limit:US$0 我原本的理解是: 「免費額度 US$30 用完,就停止;一毛錢都不付。」 但實際結果是,這次最後仍然出現 US$4.16 的 Billed Cost。 這裡要把兩件事分開看。 Modal 目前的預算文件把 Workspace budget 定義成整個 Workspace 的用量上限,把 spend limit 定義成套用 credits 後的自付費用上限。官方也說,達到 spend limit 後,會停止還會產生額外自付費用的工作負載。 但這種平台層級的 Budget,不等於 MCP 在送出任務前的即時交易鎖。 如果 GPU workload 已經啟動,帳務資料、超額偵測與停止工作之間存在時間差;而 Kimi K3 是 8 張 B300 同時燒,幾分鐘的延遲就可能不是幾分錢。 所以我現在的結論不是「Spend limit 完全沒用」,而是: 不能只把平台上的 Spend limit 當成唯一防線。 平台 Budget 負責最後一層;MCP Budget Guard 要在任務送出前先攔一次。 我還踩到一個認證坑:Shared Endpoint 需要 Proxy Token在測試 Endpoint 時,Modal 曾經直接顯示: Create a proxy token to require authentication for this Endpoint, or create the Endpoint with unauthenticated access. 這不是單純的錯誤訊息,而是提醒我:Endpoint 的「可以呼叫」和「應該公開」是兩件事。 依照 Modal 的Endpoints 文件,Shared Endpoint 一律需要 Proxy Token,Dedicated Endpoint 預設也需要 Proxy Token;只有在建立 Dedicated Endpoint 時,才可以選擇 unauthenticated。 如果之後要把它接進 Codex 或 MCP,正確的方向應該是: 建立權限範圍清楚的 Proxy Token。 Token 只放在 MCP Server 的環境變數或 Secret 管理裡。 不把完整 Token 貼進 Codex 對話、文章、Log 或 Git。 MCP 只把模型結果回傳給 Codex,不把平台憑證暴露給工具使用者。 若是 Shared Endpoint,還要處理並行限制、逾時、重試與 429 回應。 Modal 官方也提供給 Codex 的 Endpoint 整合方式,會以 OpenAI-compatible API 與 Proxy Token 呼叫 Endpoint。這表示真正要做的不是把 Token 寫死在某個腳本裡,而是把認證、成本與資料邊界一起放進 MCP 的設計。 Shared Endpoint 反而才是我原本需求的正確模式Dedicated Endpoint 走不通,不代表 Kimi K3 不適合接進 Codex。 答案其實就在 Modal 自己的另一個選項: Shared Endpoint。 Modal 已經幫大家養好那套昂貴的 GPU infrastructure,我只需要按 token 付費,不用自己啟動 8 張 B300。 這次 Kimi K3 Shared Endpoint 在我的帳號畫面上看到的價格是: 用量 價格 Prompt US$3/1M tokens Cached Prompt US$0.30/1M tokens Completion US$15/1M tokens 這些價格和模型可用性可能調整,實際使用前應以Kimi K3 Model Library與 Endpoint 的 Usage view 為準。 假設一次 Codex Code Review: 輸入:50,000 tokens 輸出:5,000 tokens 輸入成本: 50K × US$3/1M = US$0.15 輸出成本: 5K × US$15/1M = US$0.075 合計約: US$0.225。 這個經濟模型反而很合理。 不用付模型開機費,不用等 22 分鐘 Load weight,也不用為了問一個問題,先花 US$30 把模型叫醒。 但要注意:Shared Endpoint 不能用 Starter 的 US$30 Compute Credits 抵扣,所以它需要另一個「Token Budget」,不能和免費 Compute 共用同一個錢包。 三種模式,現在要分清楚 模式 主要計費 能用 Modal 每月 US$30 Compute 嗎? 適合情境 Kimi K3 Dedicated GPU、CPU、Memory 運算資源 可以依適用規則抵扣 大量流量、隔離容量、可控 autoscaling Kimi K3 Shared Prompt、Cached Prompt、Completion tokens 不可以 偶爾從 Codex 呼叫 K3 小型/中型模型 Dedicated GPU、CPU、Memory 運算資源 可以依適用規則抵扣 把 Starter Compute 額度真正用在低頻實驗 所以我會把 Modal 每月 US$30 的用途重新定義成: Codex ↓MCP ↓Modal ↓Qwen、GLM 或其他小型/中型開源模型 這種才有機會真的把免費 GPU 額度玩出價值。 至於 Kimi K3,則走另一條: Codex ↓AI Consultant MCP ↓Kimi K3 Shared Endpoint ↓按 token 計費 ↓結果回 Codex MCP Budget Guard 要改成兩個錢包我原本只設計 Compute Budget Guard,因為我以為所有成本都會從每月 US$30 裡扣。 現在看來,MCP 至少要分成兩個預算池: 預算池 控制內容 範例 Compute Budget Dedicated Endpoint、Function、Container 的 GPU/CPU/Memory 成本 US$27 警告、US$29 停止 Token Budget Shared Endpoint 的 Prompt、Cached Prompt、Completion 成本 另設每月 token 預算與單次上限 Compute Budget 的設定可以先維持: 項目 設定 用意 每月預算上限 US$29 不把免費 Compute 用到最後一美元 安全警告線 US$27 接近上限時提醒 Modal 免費 Compute US$30 目前方案假設,依官方頁面更新 每次 Codex 要呼叫外部模型前,MCP 可以先做: 判斷這次要走 Shared 還是 Dedicated。 讀取對應預算池的本月已使用量。 讀取尚未完成任務的預估成本。 加上這一次請求的預估成本。 先做原子化的預算預約,再送出任務。 接近警告線時提醒;達到上限時拒絕新的請求。 任務完成後,用實際 token 或 Compute 成本結算預約。 如果目前帳面只用了 US$26.80,還沒超過 US$27,此時 Codex 同時送出三個任務,而 Modal 的帳務資料還沒反映這三個任務,三個請求可能都會得到「可以執行」。 所以 Budget Guard 不能只讀已完成帳務,還要把已送出但尚未結算的工作加入暫時預約: 目前已入帳用量 +進行中任務的預估用量 +這次請求的預估用量 =預計本月用量 此外,預約動作本身也要有鎖定或原子更新,避免多個並行請求同時讀到同一個舊數字。 Budget Guard 不是精準預言帳單的工具,而是一個讓「不小心超支」變得比較難發生的防線。 這次之後,我想做的已經不只是 Kimi K3 MCP繞了一大圈之後,我反而更確定原本的方向沒有錯。 只是 Backend 選錯了。 我想做的其實不是: 「在 Modal 免費跑 Kimi K3。」 而是: 「讓 Codex 能在需要的時候,呼叫另一個 AI。」 第一版 MCP 可以先放: MCP 工具 用途 第一版限制 ask_kimi_k3 詢問 Kimi K3 一般問題 只回傳分析結果,不直接修改專案 review_code 請模型 Review 程式碼或 diff 只傳必要內容,先遮罩 secrets analyze_architecture 分析架構、取捨與潛在風險 輸出建議,不自動採用決策 get_modal_usage 查詢本月 Compute 或 Token 用量 清楚標示資料時間與帳務延遲 check_budget 檢查對應預算池與進行中預約 在其他模型工具前先呼叫 但 MCP 不一定只接 Kimi K3。 未來更有趣的架構可能是: Codex │ └─ AI Consultant MCP │ ├─ Kimi K3:高難度、長上下文 ├─ Qwen:Coding 與一般分析 ├─ GLM:Agent 與工具使用 └─ DeepSeek Flash:便宜任務 │ └─ Modal Shared Endpoints 不同問題叫不同模型,便宜的工作交給便宜模型,真正困難的工作才叫 Kimi K3。 然後 MCP 統一處理: Token 統計 成本計算 月預算 模型 Routing Proxy Token Code Review 結果回傳 逾時與重試 這比只做一個 Kimi K3 MCP 有趣很多。 這次真正讓我有感的,不是 Kimi K3而是我開始越來越確定一件事。 以前我們都在想: ChatGPT、Claude、Kimi、Gemini,我到底要選哪一個? 但 Agent、MCP、API 越成熟後,這個問題可能會慢慢變成: 我的主 Agent,需要哪些外部能力? Codex 可以是主要工作的 Agent。 Kimi K3 不一定要取代它。Kimi 甚至不用是一個我每天打開的聊天網站。 它只需要是: Codex 工具箱裡的一個 Tool。 需要它時才叫它,不需要就完全不用。 這才是我覺得 MCP 真正開始有意思的地方。 它不只是讓 AI 可以操作更多工具,而是你開始可以自己組裝一個 AI 的能力邊界。 搜尋是一個 Tool。 資料庫是一個 Tool。 瀏覽器是一個 Tool。 你的公司系統是一個 Tool。 甚至: 另一個更強的 AI,也可以只是一個 Tool。 至於 Modal 每個月那 US$30? Kimi K3 我是不敢再拿它養了。😂 下個月我準備換一個小一點的模型,把這 30 美金真的榨乾。 我接下來會怎麼做?這次實驗讓我的順序重新排過: 先確認模型的 serving mode,是 Shared 還是 Dedicated。 先看清楚 Compute Credits 與 Token Usage 是否使用同一套額度。 先設定平台層級的 Workspace budget 與 spend limit。 在 MCP 裡再加一層預算池、單次上限與進行中任務預約。 先用小型/中型模型驗證 Modal 免費 Compute 的實際用途。 Kimi K3 改用 Shared Endpoint,先做低成本的單次請求測試。 最後才把它接進 Codex,觀察什麼時候真的值得叫第二個模型。 真正好的多模型工作流,不是把所有模型都開起來,而是知道什麼任務該叫誰、要花多少錢、哪些資料可以送出去,以及什麼時候應該停止。 常見問答 (FAQ)Q1:Modal Starter 每月 US$30 免費 Compute,可以拿來使用 Kimi K3 Shared Endpoint 嗎?不可以直接這樣理解。Modal 官方文件明確區分 Shared Endpoint 的 token 計費與方案內的 Compute Credits;Included Compute 不能拿來抵 Shared Endpoint 使用量。Shared Endpoint 應該另外設定 Token Budget,並以當下 Endpoint Usage 顯示的價格為準。 Q2:為什麼我沒有送出 Prompt,還是產生了 US$34.16?因為這次走的是 Dedicated Endpoint。8 張 B300 在 provisioning、載入模型、初始化推論環境的期間,就可能產生 GPU、Memory、CPU 與其他運算成本;模型還沒回答第一個 Prompt,不代表完全沒有使用計費資源。 Q3:Spend limit 設成 US$0,為什麼還可能看到自付費用?平台層級的 spend limit 是重要防線,但不是送出任務前的 MCP 交易鎖。正在執行的工作、帳務資料更新與停止動作可能存在時間差,因此還是要在 MCP 送出請求前做預算檢查、預約與拒絕新任務的控制。 Q4:Shared Endpoint 一定要建立 Proxy Token 嗎?Modal 目前的官方 Endpoints 文件說,Shared Endpoint 一律需要 Proxy Token,Dedicated Endpoint 預設也需要。Proxy Token 應留在 MCP Server 的 Secret 或環境變數中,不要放進文章、Git、Codex 對話或公開前端。 Q5:偶爾從 Codex 呼叫 Kimi K3,應該選 Shared 還是 Dedicated?以這次需求來看,Shared Endpoint 比較合理,因為 Modal 管理硬體與自動擴縮,你按 token 使用;Dedicated Endpoint 比較適合需要隔離容量、可控 autoscaling 或大量流量的服務。最後仍要以實際價格、延遲、並行限制與資料政策決定。 Q6:那 Modal 每月 US$30 Compute 最適合拿來做什麼?比較適合小型/中型 LLM、Whisper、Embedding、Reranker、OCR/Vision、TTS、FLUX/SDXL、Agent Sandbox、Batch GPU 工作,以及其他有工作才啟動的 GPU Function。重點是先估算模型載入與執行時間,不要只看「免費」兩個字。 參考資料 Modal Pricing Kimi K3 Model Library Modal Shared Endpoints 官方文件 Modal Endpoints 與 Proxy Token 文件 Modal Budgets 文件 如果想先釐清 MCP、Skill 與 CLI 的分工,可以參考AI 工具名詞全解析:一次搞懂 MCP、Skill 與 CLI 的差異與應用場景。如果想看另一種 ChatGPT、MCP 與 Codex 的分工方式,也可以延伸閱讀我把 ChatGPT 接上自己的開發台 MCP,AI Coding 開始變成一條「軟體開發流水線」。

  • article-我覺得 VoiceStudio 最值得注意的地方,根本不是免費

    2026/9/15

    AI工具 AI自動化 影音行銷
    我覺得 VoiceStudio 最值得注意的地方,根本不是免費

    最近看到一套開源 AI 語音工具 VoiceStudio。 它可以在自己的電腦執行,支援 TTS、語音複製、多角色語音與影片配音,也不需要每個月再付一筆訂閱費。 看到這裡,很多人的第一個反應可能是: 那我是不是可以不用訂 ElevenLabs 了? 但我研究完之後,反而覺得「免費」可能是這套工具最不重要的地方。 真正讓我感興趣的是另外一件事情: AI 配音,正在從一個「工具」,變成 AI 工作流裡的一個「節點」。 本文談的是我對 VoiceStudio 與本地語音工作流的觀察,不是對不同語音服務的固定排名。實際功能、模型支援、硬體需求與授權方式,都應以當下的專案文件與模型授權條款為準。 我們現在用 AI,其實還是在「操作軟體」想一下現在大部分人怎麼做 AI 影片。 先叫 ChatGPT 寫腳本。 複製文字。 打開配音網站。 貼上文字。 選聲音。 按生成。 下載音檔。 再打開剪輯軟體。 匯入音訊、對字幕、找 B-roll、剪輯、輸出。 看起來整個流程用了很多 AI,但其實中間有一個很重要的角色一直沒有消失: 你。 你還是那個負責把 A 工具的結果複製到 B 工具,再把 B 工具的結果下載下來丟進 C 工具的人。 換句話說,AI 很厲害,但你還是一個「AI 工具操作員」。 這也是我之前思考 AI 影片工廠時,會把腳本、配音、字幕、素材與剪輯拆成不同能力的原因。可以先參考用 Codex 打造 AI 影片工廠:串接六大 AI 能力的完整工作流,影片工廠真正要處理的,不只是多找到幾個好用工具,而是讓每個能力可以被下一個步驟穩定接住。 真正的改變,是你連 VoiceStudio 都不用打開VoiceStudio 讓我感興趣的,不只是它可以在本地執行。 而是這類工具開始提供 API、MCP 之類可以讓其他程式直接呼叫的介面。 這件事情看起來很工程師,對內容創作者其實非常重要。 因為當一個 AI 工具可以被程式呼叫之後,「人」就不一定要站在中間了。 例如我最近一直在研究 AI 自動剪輯。 理想中的流程不是: 1我打開 ChatGPT → 打開配音軟體 → 打開剪輯軟體 而是: 1234567891011121314151617文章完成 ↓AI 自動整理成短影音腳本 ↓自動送進本地 Voice Clone ↓產生我的聲音 ↓自動分析旁白時間軸 ↓自動尋找 B-roll ↓自動產生字幕與字卡 ↓自動剪輯 ↓輸出成片 如果這條流程真的串起來,我根本不需要知道 VoiceStudio 的「生成」按鈕在哪裡,甚至不用打開 VoiceStudio。 因為它已經從「我要操作的軟體」,變成「我的 AI 員工背後會使用的一項能力」。 我覺得這才是接下來真正重要的改變。 以後我們可能不會在意「你用哪一套 AI」現在很多人在比較: ChatGPT 還是 Claude? ElevenLabs 還是 VoiceStudio? 這個生圖模型比較強,還是那個比較強? 這些當然重要,但如果 Agent 的發展繼續下去,我猜這些問題的重要性會慢慢降低。 因為使用者最後看到的可能根本不是工具。 你只會跟 AI 說: 把這篇文章做成三支短影音。 剩下的事情由 Agent 自己決定。 1234567需要寫腳本,就呼叫文字模型需要圖片,就呼叫生圖模型需要我的聲音,就呼叫本地 Voice Clone需要字幕,就呼叫語音辨識需要素材,就去素材庫搜尋需要剪輯,就呼叫影片處理工具最後丟三支影片給我挑 這時候,ChatGPT、VoiceStudio、FFmpeg、Whisper 或其他模型,全部退到後台。 使用者根本不需要看到它們。 這不代表底層工具不重要,而是工具的價值開始從「使用者介面有多順」延伸到「能不能穩定成為其他系統可呼叫的能力」。 本地 AI 真正有趣的地方,也不只是省錢很多人談 Local AI,第一件事情就是算成本: ElevenLabs 一個月多少錢? 本地模型是不是免費? 跑在自己的電腦上是不是比較便宜? 如果只是偶爾做幾支影片,我甚至覺得這不是最重要的問題。 雲端服務通常比較方便,模型可能也更穩定;本地方案則會多出硬體、安裝、更新、維護與排錯成本。軟體可以免費使用,也不代表每個語音模型都能免費商用,實際使用前仍要確認各自的授權條款。 真正有趣的是: 當 AI 能力搬到自己的電腦,它開始變成你可以控制的基礎設施。 不用每一次都開網頁。 不用每一次都上傳資料。 也不用每一次都等人按下「生成」。 只要電腦開著,Agent 就可以自己呼叫。 這對一天做一支影片的人,差異可能還不大。 但如果未來你不是一天做一支,而是讓 AI 一次處理 20 支、50 支,甚至 100 支內容,整個思考方式就完全不一樣了。 你不再是在找: 最好用的 AI 配音網站。 你是在建立: 我的 AI 內容基礎設施。 聲音,也正在變成一種可以重複使用的數位資產另外一個我覺得很有意思的變化,是「自己的聲音」。 以前聲音不是資產。我要錄一段新的內容,就必須重新開麥克風講一次。 講錯一句,重新錄。 課程改了一句,重新錄。 想做英文版,再錄一次。 但是 Voice Clone 出現之後,邏輯開始改變。 我的聲音可以被抽象成一個可以重複呼叫的能力。 今天拿來做短影音。 明天拿來補錄線上課程。 後天文章自動轉 Podcast。 甚至同一支內容自動產生不同語言版本。 所以未來自媒體經營者要管理的,可能不只有文章、圖片、影片與 Prompt,還會多一個東西: 自己的 Voice Profile。 它會跟 Logo、品牌色、字型、人物 LoRA 一樣,逐漸變成個人品牌的數位資產。 但這種資產也需要被好好管理:聲音樣本的保存、誰可以呼叫、哪些內容可以生成、是否允許商用,以及被濫用時如何撤銷,都不能只靠「模型很像」來處理。 把「我是誰」和「我要怎麼說」拆開這件事對自動剪影片非常重要。 一支短影音不可能從頭到尾都使用同一種情緒: 開頭 Hook 可能要比較興奮 中段解釋要穩定清楚 提醒風險時要嚴肅 講到反差時可能要驚訝 最後 CTA 又要比較親切 因此,Voice Engine 可以拆成兩層: 我是誰: 聲音的音色、辨識度與個人品牌特徵。 我要怎麼說: 情緒、語速、停頓、重音與表達方式。 理想的流程會是: 1234567891011腳本 ↓AI 理解內容 ↓判斷每一段情緒 ↓選擇語速與表達方式 ↓Voice Clone 生成 ↓送進剪輯流程 這時候 AI 就不只是單純「念稿」,而是開始理解:這句話應該怎麼說。 如果你也在處理影片聲音,可以延伸參考短影音音效怎麼選?從剪映內建到 AI 生成,一次搞懂 SFX 工作流。克隆旁白解決的是「誰在說」,SFX 與混音則決定觀眾「聽起來感覺如何」,兩者應該放在同一條聲音工作流裡設計。 我不太想問「VoiceStudio 能不能取代 ElevenLabs」因為我覺得這個問題太小了。 ElevenLabs 好不好用?當然好用。 VoiceStudio 免費嗎?軟體本身確實可以免費使用,但實際使用的語音模型仍要確認各自授權。 真正值得測試的是: 我能不能把 VoiceStudio 塞進自己的 AI Short Factory,然後以後根本不用打開它? 如果可以,那代表配音這件事情已經從: 我要做的工作 變成: AI 自己會完成的一個步驟 再往後,生圖是一個節點,配音是一個節點,字幕是一個節點,B-roll 是一個節點,剪輯是一個節點,發布也可能是一個節點。 當這些節點全部串起來,我們真正建立的就不再是一堆 AI 工具,而是一條: AI 內容生產線。 所以 VoiceStudio 免費這件事情,我當然很開心。 但比免費更讓我興奮的是: 我們正在慢慢進入一個「不用操作 AI 工具」的時代。 真正值錢的能力,也會從「你會多少 AI 工具」,逐漸變成: 你能不能把這些 AI 能力,組成一套會自己工作的系統? 這可能才是 AI 自媒體下一階段真正拉開差距的地方。 常見問答 (FAQ)Q1:VoiceStudio 最值得注意的地方是免費嗎?不只是免費。更值得注意的是,VoiceStudio 這類本地語音工具若能透過 API 或 MCP 被其他程式呼叫,就有機會成為 AI 內容工作流裡的語音節點,讓配音從手動操作變成可重複執行的步驟。 Q2:接進 AI 工作流後,還需要打開 VoiceStudio 嗎?理想上不需要。當 Agent 已經能透過 API 或 MCP 呼叫語音能力,使用者只要提出「把文章做成短影音」這類目標,VoiceStudio 可以在後台完成配音;但實際能否做到,仍取決於工具提供的介面、設定方式與整合品質。 Q3:本地 AI 語音一定比較省錢嗎?不一定。本地執行可能減少訂閱或按量計費,但仍要計入硬體、安裝、更新、維護、電力與排錯成本;此外,軟體免費也不代表所使用的語音模型都允許免費商用,必須逐一確認授權。 Q4:自己的 Voice Profile 可以當成個人品牌資產嗎?可以把它視為一種可重複呼叫的數位資產,但需要同時管理聲音樣本、存取權限、生成範圍、商用許可與撤銷機制。聲音相似度只是品質的一部分,不等於完整的品牌治理。

  • article-【30 秒 AI 影片,模型只花 513 元,為什麼報價可以是一萬元?】

    2026/9/15

    商業策略 內容行銷 影音行銷
    【30 秒 AI 影片,模型只花 513 元,為什麼報價可以是一萬元?】

    先說結論:AI 影片最貴的可能從來不是模型,而是把 500 秒垃圾變成 30 秒作品的人。 文中的模型單價與金額,都是用來說明估價邏輯的示例,實際費用會隨模型版本、解析度、平台方案與計價方式變動。真正值得留下來的,不是某個當下單價,而是如何把採用率、修改量與人力一起放進成本模型。 30 秒成片,為什麼不能只用「秒數 × 單價」?最近 AI 影片越來越強,我也開始看到一個很有趣的問題: 「現在 AI 生成影片這麼便宜,那做一支 30 秒影片,到底應該收多少錢?」 很多人第一個想到的算法是: 130 秒 × 模型每秒單價 假設模型生成一秒 11 元,那 30 秒就是: 130 × 11 = 330 元 所以一支 30 秒 AI 影片,成本才 330 元? 如果只是生成一段素材自己玩,這樣算沒有什麼問題。 但如果今天是客戶付錢,要你交出一支「可以用的商業成片」,事情完全不一樣。 因為 AI 影片最大的成本,從來不是「生成」,而是: 你生成了一大堆,最後到底有多少能用? AI 影片最容易被忽略的成本:抽卡假設最後成片需要 30 秒,你不可能剛好生成 30 秒,然後 30 秒全部拿來用。 人物可能崩掉,手可能有問題,商品 Logo 變形,表情不對,運鏡突然抽風,前後鏡頭接不起來。 甚至畫面都沒問題,你只是單純覺得: 「這顆不好看。」 於是重抽。 這就是大家常講的「抽卡」。 如果最後生成了 150 秒素材,只有 30 秒進入成片,那麼你的「採用率」就是: 130 ÷ 150 = 20% 換句話說,成片每留下 1 秒,背後平均有 4 秒被丟掉。 所以我在估 AI 影片成本時,比起模型一秒多少錢,我其實更在意另一個數字:採用率。 粗略規劃時,我可能會先這樣抓: 專案情境 初步採用率估算 社群短影音 約 40% 一般商用敘事影片 約 20% 高規格長片 約 10% 這不是什麼業界公定標準,只是讓自己不要活在「AI 每次生成都會成功」的幻想裡。 同一個模型,採用率不同,成本可以差四倍假設今天使用的模型是每生成一秒 11 元,做一支 30 秒影片: 採用率 估算生成量 模型成本 40% 30 ÷ 0.4 = 75 秒 75 × 11 = 825 元 20% 30 ÷ 0.2 = 150 秒 150 × 11 = 1,650 元 10% 30 ÷ 0.1 = 300 秒 300 × 11 = 3,300 元 有沒有發現一件很有意思的事情? 模型完全沒有換,影片長度也完全沒有換。 光是「採用率」不同,模型成本就差了四倍。 所以我現在反而覺得,AI 影片真正的技術,不只是會不會生成,而是你能不能提高採用率。 會做角色設定、Reference、分鏡、首尾幀、鏡頭拆解、素材控制、提示詞工程的人,真正省下來的不是按按鈕的時間,而是少抽很多次卡。 需要 3 秒,不代表只付 3 秒例如一顆鏡頭,我最後只需要 3 秒,但模型一次可能生成 5 秒。 第一次不行,再來。 第二次人物表情怪怪的,再來。 第三次商品變形,再來。 第四次終於可以。 最後時間軸上只有 3 秒,但實際付費生成了 20 秒。 所以如果真的要精算,我會看另一個數字: 1有效採用率 = 實際進入成片秒數 ÷ 實際付費生成秒數 這個數字,比「我今天生成了幾顆鏡頭」更值得追蹤。因為真正影響成本的,是付費生成了多少,以及最後有多少秒成功進入交付版本。 客戶修改:最容易低估的第二輪抽卡第一版完成之後,客戶說: 「這邊人物可以笑一點嗎?」 真人拍攝的後製,也許還有一些調整空間。 但 AI 影片很可能不是把嘴角往上拉一點就結束。你得重新生成整顆鏡頭,然後重新面對一次人物、服裝、商品、背景、運鏡與光線全部變動的風險。 更刺激的是:你原本只想修改 A,AI 很可能順便幫你把 B、C、D 也改了。 所以一般委製案,我會先保留大約 20% 的修改預備量。 我的快速估算公式會變成: 1模型費 = 成片秒數 ÷ 採用率 × (1 + 修改率) × 每秒生成單價 但這還只是模型費。 案例:30 秒影片,模型費可能真的只有 513 元假設今天做一支 30 秒直式社群影片: 使用 Seedance 2・720p,每生成一秒約 5.7 元。 採用率抓 40%。 修改預備量抓 20%。 那麼估算生成量是: 130 ÷ 40% × 1.2 = 90 秒生成量 模型費就是: 190 × 5.7 = 513 元 模型費:513 元。 很便宜吧? 問題來了。 假設一位初階製作者,一天人力成本抓 2,000 元,整個專案工作五天: 12,000 × 5 = 10,000 元 模型加人力: 1513 + 10,000 = 10,513 元 模型費只占大約 4.9%,剩下約 95.1% 都是人。 客戶真正買的到底是什麼?這也是我覺得現在 AI 影片市場最容易誤會的地方。 客戶看到的是: 「你不就是打 Prompt,然後按生成嗎?」 但真正的工作可能是: 企劃 腳本 分鏡 角色設定 場景設定 提示詞 生成 挑片 補生成 角色一致性 QC 商品 QC 剪輯 字幕 配音 音樂 調色 輸出 客戶溝通 修改 所以如果要更精準估價,我甚至不會只寫: 1人力費 = 人日單價 × 工作人日 而會拆成: 1專案成本 = 前期製作 + AI 生成 + 後期製作 + 專案管理 前期製作包含企劃、腳本、分鏡、角色與場景設定;AI 生成包含抽卡、補生成與修改預備量;後期製作包含剪輯、字幕、配音、音樂、調色與輸出;專案管理則包含溝通、版本整理、回饋整合與交付。 這和價值堆疊如何讓產品不再被說太貴的邏輯很接近:不是把一個總價藏起來,而是讓客戶看見交付價值是由哪些工作組成。 因為客戶付的從來不是那 513 元的 GPU 費用,他真正付錢買的是:有人可以把幾百秒充滿不確定性的 AI 素材,收斂成最後可以交付的 30 秒。 生成成本正在下降,但「選擇成本」沒有這可能才是 AI 影像產業接下來真正有趣的地方。 以前拍影片最大的問題是:「拍不到。」 所以你需要攝影棚、攝影機、燈光、演員、場景、攝影師、美術與製片。每按一次快門都有成本。 但生成式 AI 把這件事情反過來了。 未來最大的問題可能不是: 「做不出來。」 而是: 「做得出來的東西太多了。」 100 顆鏡頭都可以生成。問題是: 哪一顆能用? 哪一顆最好? 哪一顆符合品牌? 哪一顆人物沒有跑掉? 哪一顆商品沒有變形? 哪兩顆接起來才合理? 哪一顆值得繼續修改? 這些全部都是人的判斷。 所以我甚至認為,未來 AI 影片產業真正稀缺的能力,會慢慢從單純的 Production,轉向: 1Direction + Selection + QC 導演能力、選擇能力與品質控制能力。 如果你想進一步理解如何把抽卡整理成可以重複執行的流程,也可以延伸閱讀AI 影片真正的分水嶺:從 Prompt 到專家 Skill 的製片工作流。 100 分鐘 AI 電影,真的只要 20 萬元?我們再把尺度拉大。 假設要製作一部 100 分鐘 AI 電影: 總片長:6,000 秒。 使用 Seedance 2.5・1080p,每生成一秒約 21.3 元。 高規格長片採用率抓 10%。 先不加入修改預備量,估算生成量是: 16,000 ÷ 10% = 60,000 秒生成量 模型成本: 160,000 × 21.3 = 1,278,000 元 光模型就大約 128 萬元。 假設再投入 450 個人日,每人日平均 5,000 元: 1450 × 5,000 = 2,250,000 元 模型加人力: 11,278,000 + 2,250,000 = 3,528,000 元 如果再把約 20% 的生成修改預備量加到模型費: 11,278,000 × 1.2 + 2,250,000 = 3,783,600 元 整體約 378 萬元左右。 而且這還沒有完整納入劇本開發、專業配音、演員、音樂、混音、法務、授權、製片管理、發行與行銷。 所以 AI 電影確實有可能把過去需要幾千萬、甚至上億元才能完成的事情,壓到非常誇張的價格;但也不是「我有二十萬元、一台電腦,再加上一個很模糊的故事概念」就可以拍電影了。 模型越便宜,專業 AI 影片製作者不一定越便宜這可能是最反直覺的一件事。 我反而認為,接下來模型價格還會繼續下降,生成速度會繼續提高,畫面品質也會繼續變好。 「把畫面生出來」這件事情,會愈來愈不值錢。 但這不代表專業 AI 影片製作者的價格,也一定跟著往下掉。 因為當每個人一天都可以生成幾百、幾千段影片之後,真正稀缺的東西反而變成: 知道什麼值得留下來的人。 所以未來客戶付錢買的,不會只是: 「幫我生成 30 秒影片。」 而是: 「幫我從幾百秒垃圾裡,得到最後這 30 秒。」 AI 讓畫面出現得愈來愈便宜,但把畫面變成作品,依然很貴。 而且我猜,這件事情短期內不會改變。 常見問答 (FAQ)Q1:一支 30 秒 AI 影片的模型成本到底是多少?模型成本沒有固定答案,至少要同時看每秒生成單價、採用率與修改預備量。以本文的示例計算,30 秒成片、40% 採用率、20% 修改預備量與每秒 5.7 元的模型,模型費約為 513 元。 Q2:什麼是 AI 影片的採用率與有效採用率?採用率是「成片秒數 ÷ 生成素材總秒數」;有效採用率則是「實際進入成片秒數 ÷ 實際付費生成秒數」。後者會把每次重抽與模型實際計費的秒數一起納入,更適合用來追蹤專案成本。 Q3:為什麼模型只花 513 元,客戶報價卻可能超過一萬元?因為客戶購買的不只是模型生成,而是企劃、腳本、分鏡、角色與場景設定、抽卡、挑片、QC、剪輯、配音、音樂、調色、溝通與修改等完整交付。本文示例中,模型費約占 4.9%,主要成本來自五天的人力與判斷。 Q4:AI 影片應該怎麼快速估算模型費?可以先使用「模型費 = 成片秒數 ÷ 採用率 × (1 + 修改率) × 每秒生成單價」估算,再另外加上前期製作、後期製作與專案管理。採用率不是公定標準,應依角色一致性、商品辨識、鏡頭複雜度與客戶修改風險調整。 Q5:100 分鐘 AI 電影是不是只要二十萬元就能完成?不能只用模型單價判斷。依本文的示例,6,000 秒成片、10% 採用率、每秒 21.3 元模型費、450 個人日與 20% 生成修改預備量,模型加人力約需 378 萬元,且尚未計入劇本、配音、音樂、法務、授權、製片、發行與行銷。

  • article-【Google Flow 的 /orbit 到底是什麼?從 Veo 到 Omni Flash,一次搞懂 AI 影片的運鏡指令】

    2026/9/14

    AI工具 影音行銷 Gemini
    【Google Flow 的 /orbit 到底是什麼?從 Veo 到 Omni Flash,一次搞懂 AI 影片的運鏡指令】

    最近我看到一個有趣的 Google Flow 用法:生成影片時,只輸入 /orbit,畫面就像替主體加上環繞運鏡。其他人也會整理 /dollyin、/tracking、/lowangle、/macro、/goldenhour、/ugcunboxing 等斜線寫法,看起來很像產品裡藏了一套秘密指令。 研究後我更想弄清楚的,不是還有幾百個指令,而是這些詞背後共通的攝影語言。理解鏡頭怎麼移動、如何構圖、光線如何呈現,才能把這些概念帶到 Veo、Gemini Omni Flash,或其他能以自然語言生成影片的模型。 /orbit 是 Google Flow 的官方指令嗎?目前查閱 Google Flow 的官方影片建立說明,流程是用提示詞描述場景,再選擇模型、比例與片長;我沒有在這份說明中找到 /orbit 或名為 Google Flow Slash Command API 的公開指令定義。因此,較穩妥的理解是:這些斜線詞是創作者整理的 Prompt Shorthand(提示詞快捷寫法),不是已確認的官方 API。 這不代表輸入 /orbit 一定沒有作用,而是不能假設斜線會觸發一個保證存在的程式指令。實際生成可能受 orbit 這個詞、上下文與各模型的語意理解影響;想讓需求更清楚,可以把它改寫成完整句子: 1The camera smoothly orbits around the subject. orbit 本身就是常見的攝影運鏡概念。類似地,dolly in 是攝影機向主體推進,tracking shot 是跟著人物或物件移動,low-angle shot 是低角度拍攝,macro shot 是微距特寫,而 golden hour 描述的是接近日出或日落的暖色光線。 真正值得記住的是可跨模型使用的攝影語言如果只記 /orbit,介面改版或另一個模型不認得斜線寫法時,這個捷徑就可能失效。若記住 Orbit Shot=環繞運鏡,你就能再補上方向、幅度、速度與主體位置,把同一個想法展開成不同細節層級的提示詞。 在 Google Flow 裡,影片模型與支援功能會因選用的模型而不同;官方也建議生成前確認目前的模型與設定。Gemini Omni Flash 官方提示指南則明確提到場景、鏡頭運動、光線與情緒等描述方式。這些資料支持「攝影語言可以用自然語言表達」的做法,但不代表所有模型都會以相同方式遵循提示詞。 把 AI 影片提示詞拆成五個層級以 Orbit 為例,可以從一個簡短概念逐步增加控制資訊: Level 1:先給運鏡名稱1/orbit 這是最精簡的快捷寫法,只表達「希望鏡頭環繞主體」。 Level 2:回到標準攝影語言1Orbit around the subject. 拿掉斜線後,仍然保留同一個運鏡概念。 Level 3:加入方向與速度1The camera slowly orbits clockwise around the subject. 現在提示詞多了慢速與順時針兩個條件。 Level 4:補上角度、距離與主體位置1The camera performs a slow 180-degree clockwise orbit around the subject, maintaining a constant distance and keeping the subject centered. 除了環繞方向與速度,也交代移動幅度、攝影機距離和主體在畫面中的位置。 Level 5:寫成一段有時間節奏的導演腳本12345Single continuous shot. No cuts.[0-2s] Static medium shot.[2-7s] Slow 180-degree clockwise orbit around the subject. Maintain a constant camera distance and keep the subject centered.[7-10s] Lower the camera and settle into a low-angle hero shot.Warm golden-hour rim lighting. Keep the subject visually consistent. No dialogue. 到這一層,提示詞已經交代鏡頭何時開始移動、移動多久、最後停在哪裡。時間標記可以幫模型理解節奏與順序,但它仍是生成提示,不是逐格精準的剪輯時間軸;實際結果要看模型、版本與生成設定。 一個運鏡有五個可調整的控制維度/orbit 只說出運鏡名稱。若想減少生成結果像抽卡,可以把它拆成五個方向來描述: 控制維度 可以描述的內容 方向 順時針、逆時針、由左向右、由右向左 幅度 45 度、90 度、180 度或完整 360 度 速度 非常慢、緩慢、快速或急速 距離 貼近主體、遠距環繞、維持固定距離 結束畫面 特寫、低角度英雄鏡頭、主體背後或正面 例如,A slow 180-degree clockwise orbit, maintaining a constant distance, ending in a low-angle close-up hero shot. 就比單獨輸入 /orbit 多交代了可供模型參考的畫面條件。提示詞不一定要很長,重點是把真正重要的控制維度說清楚。 Veo 的攝影積木與 Omni Flash 的時間軸寫法教學時,我會用「攝影積木」介紹 Veo:主體、動作、景別、運鏡、光線與聲音,再依需要組合。到了 Gemini Omni Flash,我會多練習用時間軸描述一段連續鏡頭,明確寫出每一段的畫面變化。 這是方便理解提示詞的教學方式,不代表 Veo 只能用積木、Omni Flash 才能用時間碼。Gemini Omni Flash 的官方指南說明,模型預設可能嘗試生成多個鏡頭;若需要單一連續畫面,可以寫明 In a single continuous shot 或 No scene cuts,並以時間標記交代事件發生順序。不同模型與 Flow 功能的支援狀況仍可能不同,使用前應確認當下選取的模型與設定。 以 10 秒商品廣告為例,可以這樣寫: 12345Single continuous shot. No cuts.[0-3s] Close-up product shot. A bottle sits on a reflective black surface.[3-7s] The camera slowly orbits clockwise around the bottle while gently pushing in.[7-10s] The camera settles into a low-angle hero shot.Warm golden-hour rim lighting. Keep the product label consistent. No dialogue. 這段提示詞不只說「環繞」,也說明何時開始、同時搭配什麼動作、最後停在哪個景別。若你想先把多個鏡頭的順序規劃好,也可以延伸閱讀用 AI 快速生成短影音?九宮格分鏡技巧解決人物變形。 把 Slash Commands 當成攝影積木,而不是終點這些斜線寫法仍然很好用,尤其適合初學者快速記住攝影概念。可以先整理成自己的攝影積木: 運鏡: /orbit、/dollyin、/dollyout、/tracking、/handheld、/fpv 景別與角度: /closeup、/macro、/lowangle、/highangle、/pov 光線: /goldenhour、/backlight、/rimlight、/neonlight 商品畫面: /productreveal、/productspin、/ugcunboxing 特效: /smokereveal、/liquid、/disintegrate 新手可以先用 /orbit,再加上 /lowangle 或 /goldenhour。需要更明確的控制時,就把積木展開成自然語言: 1Single continuous cinematic shot. The camera slowly orbits 180 degrees clockwise around the subject while maintaining a constant distance. Use a low camera angle with warm golden-hour backlighting. Keep the subject centered and visually consistent. No cuts. 斜線詞是入口;一旦寫清楚畫面條件,這些攝影概念便不綁定某個介面或模型。 Prompt 正在變成一種導演介面以前我們可能只寫「一個男人走在東京街頭,電影感」,再看看模型會給什麼。現在可以把想法拆成鏡頭腳本: 0–2 秒先保持固定中景。 2–7 秒開始順時針環繞 180 度,人物留在畫面中央。 7 秒後降低機位,停在低角度英雄鏡頭。 整段不要切鏡,並維持人物的外觀與服裝。 這不只是描述「我要什麼畫面」,而是把運鏡、景別、速度、方向、距離、光線、動作和時間順序,組合成模型看得懂的執行腳本。當你學會的是這套攝影語言,換 Veo、Gemini Omni Flash 或其他自然語言影片模型時,就有一組可以重新測試與調整的基礎。 官方文件參考 Google Flow:建立影片 Google Flow:模型與支援功能 Google AI for Developers:Gemini Omni Flash 影片生成與提示指南 常見問答 (FAQ)Q1:/orbit 是 Google Flow 的官方指令嗎?目前查閱的 Google Flow 官方說明沒有把 /orbit 定義為公開指令或 Slash Command API。把它當成創作者的提示詞快捷寫法較穩妥,若需要明確表達環繞鏡頭,可直接寫 The camera orbits around the subject.。 Q2:/orbit 這種寫法可以直接用在 Gemini Omni Flash 嗎?Orbit 的運鏡概念可以用在 Gemini Omni Flash,但不要假設斜線語法一定通用。可改寫成自然語言,例如 The camera slowly orbits clockwise around the subject.,再依輸出結果調整方向、速度與幅度。 Q3:怎麼讓 AI 影片的運鏡方向和幅度更明確?在提示詞中直接寫出順時針或逆時針、移動 90 度或 180 度,以及運鏡速度、與主體的距離和結束景別。條件越具體,模型越能以這些資訊作為生成參考,但結果仍可能因模型與設定而不同。 Q4:AI 影片可以依照秒數執行運鏡嗎?可以用 [0-3s]、[3-7s] 這類時間標記描述事件順序與節奏。Gemini Omni Flash 官方提示指南有時間碼範例;時間標記仍屬自然語言提示,不保證逐秒或逐格精準執行。 Q5:一套運鏡快捷詞能套用在所有 AI 影片模型嗎?運鏡、景別與光線等攝影概念可以跨模型重用,但各模型的功能、版本與語意遵循程度不同。保留攝影概念,再把快捷詞展開成清楚的自然語言,並依實際輸出測試調整。

  • article-AI 長片真正的突破,不是模型變強,而是終於有人把「抽卡」變成製片流程

    2026/9/14

    AI工具 影音行銷 Higgsfield
    AI 長片真正的突破,不是模型變強,而是終於有人把「抽卡」變成製片流程

    最近看到 Higgsfield 公開約 95 分鐘的 AI 長片《HELL GRIND》。只看表面,很容易把焦點放在「AI 已經能做 95 分鐘電影了」;但我研究它公開的製作專案後,反而覺得更值得注意的,是團隊開始把角色、場景、鏡頭與生成素材當成一套製片系統來管理。 Higgsfield 的官方專案頁提到,公開內容包含每個場景背後的 prompts、assets 與 generations;Higgsfield 執行長 Alex Mashrabov 也在公開貼文中稱它為 95 分鐘 AI 電影。 對我來說,真正重要的不是長度,而是這部片讓一個問題變得更清楚: 如何把「抽卡」,變成製片? 為什麼 AI 長片不能只靠「不行就重抽」?做 10 秒或 30 秒的影片,寫 Prompt、生圖、試運鏡,畫面不對就再生成一次,偶爾還撐得住。但當作品長到 5 分鐘、20 分鐘,甚至 95 分鐘,每一鏡都靠運氣成功,就很難維持角色、場景和敘事的連貫。 長片需要的不只是單一鏡頭「看起來不錯」,還要讓觀眾相信:這是同一個角色、同一個世界,故事也在往前走。鏡頭一換,門不能無故換邊;角色換個狀態,衣服和傷勢不能忽然重置;前一鏡的動作,也要能接到下一鏡。 所以 AI 長片遇到的核心問題,已不只是「怎麼寫出更好的 Prompt」,而是「怎麼讓每次生成都能接回同一部作品」。 人物不該只是一段 Prompt,而是一組角色資產以前我們可能會在每個鏡頭重寫一次:「一名 32 歲亞洲男性,短黑髮,穿黑色外套……」然後希望模型記得他是誰。 長片製作更需要一份 Character Bible,先把角色定義成可重複引用的資產: 長相、身形比例與辨識特徵 服裝、髮型與會隨劇情改變的物件 聲音、語速、口音與說話習慣 表情、姿勢和具有辨識度的小動作 角色在不同場次中的狀態與變化 角色狀態也要拆開管理。乾淨的日常造型、淋雨後、受傷後或滿臉血,對應的是不同的造型狀態;如果每次都把多種狀態混在同一段描述裡,模型便可能把它們混合到不該出現的鏡頭。 這不代表角色 Asset 可以保證模型永遠不漂移,而是讓每一鏡有一致的參照。當角色跑掉時,也比較容易追問:是參照圖不夠清楚、狀態版本用錯,還是鏡頭本身要求太多? 場景不是背景圖,而是一個固定的虛擬片場場景連戲常比角色更容易出錯。 想像第一個鏡頭的門在左側,換個機位後卻跑到右邊;桌子忽然不見,窗戶又多出一扇。單看每一格也許說得過去,剪在一起就會穿幫。 因此,除了描述「這裡看起來像什麼」,還要建立空間地圖,固定重要物件和角色之間的關係。例如: 訓練墊位於房間中央 門固定在左側遠牆 窗戶在右後方,桌子在入口右側 角色 A 與門之間約有八公尺距離 這些資訊讓換機位不等於重新發明一個房間。它更像真正的片場:攝影機可以移動,但場景的空間關係不會跟著重新生成。 我把這種做法想成 AI 的「虛擬片場」。過去我們一直在練習怎麼描述畫面;長篇影像還需要我們定義畫面所在的世界。 不要只叫 AI 演情緒,要描述看得見的身體行為如果只寫「男人非常憤怒」,模型可能把情緒演成瞪眼、皺眉、咬牙、握拳,全部一起上,反而失去可信度。 更可控的方式,是把抽象情緒拆成鏡頭看得見的行為: 下巴繃緊,停頓兩秒 視線落在地面,不看對方 鼻血流到嘴唇,卻沒有伸手擦掉 呼吸逐漸加快,但肩膀保持僵硬 這不是單純把情緒形容得更長,而是把「表演」轉成可觀察、可檢查的身體訊號。我會把這種思路稱為 Performance Engineering:不是要求模型抽象地「演得更好」,而是把表演拆成具體的動作、節奏與反應。 把鏡頭設計成可診斷的 Shot,而不是塞滿一段 Prompt一個 Shot 若同時要求角色轉身、拿起道具、穿過房間、打鬥、說台詞,再加上複雜運鏡,模型失敗時就很難判斷是哪個條件造成問題。 先定義這一鏡最重要的動作、人物位置、鏡頭目的和結尾狀態,再決定要不要拆成兩鏡。若攝影機運動與角色動作彼此衝突,或同一鏡塞了太多事件,即使 Prompt 更長,也不一定會更穩。 我會用「10–15 次診斷線」提醒自己:同一個 Shot 反覆生成仍不成立時,先停止只改幾個形容詞;拆鏡、減少動作、換機位,或重新設計動作節拍。這是用來避免盲目重抽的工作參考,不是所有模型都適用的官方硬性門檻;真正的停損點仍要看鏡頭難度、成本和可接受品質。 如果你想進一步看分鏡如何協助人物一致,可以延伸閱讀本站的AI 九宮格分鏡技巧;九宮格是一種方法,不代表每部片都必須採用。 不是消滅抽卡,而是把抽卡工程化AI 影片仍然會生成失敗。差別在於,失敗後我們能不能找出問題、留下紀錄,並只重做需要修正的部分。 可以把工作拆成一條可追蹤的製作管線: Story → Bible → Asset → Scene → Shot → Generation → QC → Editing 當一個 Shot 不理想時,先診斷角色狀態、空間設定、動作複雜度、鏡頭運動和模型限制,再決定是重抽、簡化還是拆鏡。這樣每次生成才會變成有理由的測試,而不是沒有上下文的下一次嘗試。 AI 影片高手可能不只是最會寫 Prompt 的人如果 AI 影片逐漸走向 10 分鐘、30 分鐘或更長的敘事作品,真正拉開差距的能力可能會變成: 角色與場景資產管理 Story Bible、Character Bible 與 Shot List Continuity 連戲檢查 版本、生成紀錄與失敗診斷 素材篩選、品質檢查與剪輯決策 這些能力比某一款模型的熟悉度更有機會跨工具沿用。今天的 Shot 可以換成漫畫分格,留下 Story、Character 和 Scene 也可以支援小說或品牌故事。模型會換,對作品的拆解、管理和判斷能力卻能帶到下一個工具。 如果你想看如何把多種 AI 能力串成完整影片產線,可以延伸閱讀本站的用 Codex 打造 AI 影片工廠;而AI 影片素養與創作者工作方法則談到創作者如何從生成者走向製片與判斷者。 工作流,才是 AI 內容能跨模型累積的資產模型一定會一直更新。今天是 Higgsfield,明天可能是 Seedance、Veo、Kling,之後也可能出現另一套更強的生成工具。 如果能力只建立在「我很會用某一個模型」,工具換掉,很多技巧就要重來。但若你建立的是 Story、Bible、Asset、Scene、Shot、Generation、QC 到 Editing 的工作流,就能依不同模型重新安排生成工具,而不必把整個製作方法一起推倒重來。 AI 內容的下一階段,也許不是一鍵生成,而是我們開始知道怎麼管理生成、如何找到失敗原因,以及怎麼把 AI 產出的零件組織成一部作品。 《HELL GRIND》值得研究的地方,不只是「AI 能不能拍電影」,而是它讓我們看到人如何透過角色資產、虛擬片場、鏡頭設計與品質檢查,和 AI 一起把電影做出來。 常見問答 (FAQ)Q1:AI 影片製作中的 Production Engineering 是什麼?Production Engineering 是把故事、角色、場景、鏡頭、生成、品質檢查與剪輯整理成可追蹤、可診斷、可重做的製作流程,而不只是逐鏡撰寫 Prompt。 Q2:Character Bible 能保證 AI 角色每一鏡都一致嗎?不能。Character Bible 提供可重複使用的角色外觀、服裝、聲音和狀態參照,幫助團隊減少重新描述並定位偏差;最後仍要逐鏡檢查與修正。 Q3:AI 長片為什麼需要場景空間地圖?空間地圖能固定門窗、家具、角色和重要道具的位置關係,讓不同機位的鏡頭仍像發生在同一個場景,降低場景佈局前後矛盾的風險。 Q4:AI 影片的「10–15 次規則」是官方標準嗎?不是普遍適用的官方標準。本文把 10–15 次當作提醒創作者停止盲目重抽、回頭診斷 Shot 設計的工作參考;實際次數應依鏡頭難度、生成成本與品質要求調整。 Q5:這套 AI 製片流程只能用在 Higgsfield 嗎?不能。角色與場景管理、Shot 拆解、生成紀錄和品質檢查等概念可用於其他影片模型;但各模型支援的參照方式、控制能力與工作介面會不同,實作時仍需依版本調整。

  • article-AI 影片真正的分水嶺:從 Prompt 到專家 Skill 的製片工作流

    2026/9/14

    AI工具 AI Agent 影音行銷
    AI 影片真正的分水嶺:從 Prompt 到專家 Skill 的製片工作流

    AI 影視最近兩個案例,指向同一件事AI 影片最近有兩件事,我覺得值得放在一起看。 第一件,是 Higgsfield 公開了 95 分鐘 AI 長片《HELL GRIND》的製作專案,讓外界能查看影片背後的提示詞與製作素材。Higgsfield 官方專案頁 第二件,是我看到一位漫劇創作者在抖音談劇本創作與進階 Skill;他也公開了一套把編劇、角色與場景資產、分鏡、提示詞和品質檢查串起來的工作流程。抖音影片|公開的漫劇製作 Skill 乍看之下,這是兩種不同的 AI 影片案例。但放在一起,我看到的是同一個轉變:AI 影視真正的分水嶺,可能已不只是模型,而是「工作流」。 我把這種變化濃縮成一句有點殘酷的話:「學得慢的,直接不用學了。」不是專業不重要,而是有些人不必再從空白頁開始,把流程每一步都重新摸索一次;他們可以先安裝一套專家整理好的 Skill,再把時間用在判斷和修正上。 以前學 AI 影片,我們常常是在學怎麼抽卡人物不像?改 Prompt。場景跑掉?再補幾句。角色換個角度就變了樣?重抽。運鏡不對?繼續試。 所以過去一段時間,大家忙著學提示詞、運鏡術語和模型參數。但模型、介面與生成能力一直在變,今天摸熟的技巧,下一次更新後可能就被新的功能或工作方式取代。 反覆試生成並沒有消失,只是單靠「再改幾個字、再抽一次」很難穩定地做完一支片。更值得整理的,是故事如何拆解、角色和場景如何管理、鏡頭如何判斷,以及什麼結果可以留下。 專家的方法,開始被封裝成 Skill以小說改編成短劇為例,完整工作不只有「寫一段好 Prompt」。它可能包括故事分析、劇本結構、節奏與 Hook、角色設定、場景和道具資產、分鏡規劃、生成提示,以及逐步檢查成品。 這些步驟可以整理成一套 Skill:明確說明何時使用、要收哪些輸入、依什麼規則執行、要輸出什麼,以及在哪些地方停下來檢查。AI Agent 便能按照這套流程做事,而不是每次都靠使用者在聊天視窗重講一遍。 公開的漫劇 Skill 範例,就把製作拆成劇本、台詞診斷、資產鎖定、分鏡、提示詞渲染和獨立質檢等階段。這不是保證任何人安裝後都能做出熱門作品;它展示的是,原本藏在熟手腦中的步驟,開始能以結構化方法傳給 AI 執行。 一條可理解的製作管線大致會是: 1234567891011小說/故事 ↓編劇 Skill ↓角色與場景 Asset ↓Storyboard Skill ↓大量生成與品質檢查 ↓剪輯與輸出 這和我先前寫過的從提示詞到 Skill:打造高效率 AI 工作流有相同的底層觀念:把反覆重講的規則、固定格式、機械式步驟和修正經驗拆開,整理成可以重複使用的模組。 為什麼 Asset 會比一段角色 Prompt 更可靠?Higgsfield 公開《HELL GRIND》的專案素材,讓大家看到長片製作不只是每一鏡各寫一段描述。角色、場景、服裝、道具與不同狀態,都可以先整理成可重複引用的 Asset。 角色不是只有一張「長相描述」。製作時可能需要正常、淋濕、受傷或換裝等不同狀態;場景也不只是一段文字,還可能需要固定的空間關係、光線和可用角度。先把這些資料整理起來,之後做新鏡頭就不必每次從頭解釋整個世界。 這不代表模型從此不會漂移。Asset 的價值是提供更穩定的參照、減少重複整理,讓團隊更容易定位問題和重新生成;最後仍然需要有人檢查角色、場景和鏡頭是否接得起來。 《HELL GRIND》提醒我們:沒有告別抽卡,只是把抽卡工程化《HELL GRIND》的製作數字,讓我更確定這點。Screen Daily 報導引述製作方資料指出,前 25 分鐘用了 16,181 次影片生成,最後選出 253 個鏡頭,約是每個入選鏡頭對應數十次生成的量級。Screen Daily 報導 這是單一製作案例的數字,不是每部 AI 影片都適用的固定比例。但它清楚提醒我們:AI 影片不是按一次生成,就會自動得到可用成片。生成失敗並不可怕;更重要的是流程能不能記錄素材、比較版本、辨認問題,並只重跑需要修正的鏡頭。 於是製作方式從: 1人 → Prompt → 抽卡 → 不滿意 → 重抽 逐漸往這種工作流靠近: 1234567891011Story Bible ↓Character Bible 與場景 Asset ↓Storyboard 與 Shot 規格 ↓多輪生成 ↓人工/AI 輔助 QC ↓挑選、重跑與剪輯 抽卡仍然存在,只是它不再只是隨手試運氣,而是被納入一套可追蹤、可重跑、可檢查的製作管線。 未來稀缺的,可能是把專業整理成系統的人未來真正厲害的人,不一定是 Prompt 寫得最長的人,而是最會把專業拆成可執行步驟的人。 導演知道鏡頭怎麼服務情緒;編劇知道衝突和節奏如何推進;攝影師知道光線、構圖和視角如何影響觀感;剪輯師知道什麼時候該留下、什麼時候觀眾會離開。這些專業判斷,才是建立 Skill 時最有價值的內容。 一套可用的 Skill,也不只是把 Prompt 改個名字。它通常還需要清楚的輸入與輸出、可重用的素材、檢查標準、失敗時的處理方式,以及必要的人工作業關卡。少了這些,Agent 只會更快速地重複同一種錯誤。 如果想把 AI 影片流程往更完整的製作系統延伸,也可以參考我整理的用 Codex 打造 AI 影片工廠。而在生成能力普及、產量快速增加之後,為什麼「會生成影片」本身可能不再稀缺,也可延伸閱讀生成影片普及後,真正稀缺的是什麼。 學 AI,不如開始把自己會的東西教給 AIPrompt 的寫法會變,模型也會更新;但故事怎麼拆、角色怎麼管理、畫面怎麼判斷、什麼內容值得留下,仍然是專業的一部分。 所以現在學 AI,我不會只叫大家背更多提示詞。我更想問:哪些判斷你每天都在重複?哪些規則每次都要重新交代?哪些錯誤其實可以用檢查表提早抓到? 把這些經驗整理起來,先讓 AI 照流程執行,再由你把關品質。以前我們學會使用 AI;下一個階段,或許是把自己會的事情整理成 Skill,教會 AI 如何一起完成工作。 當越來越多人的專業被封裝成 Skill,真正的競爭才正要開始。 常見問答 (FAQ)Q1:AI 影片製作中的 Skill 是什麼?Skill 是一套可由 AI Agent 依循的任務規則與流程,通常會定義使用時機、輸入資料、執行步驟、輸出格式和檢查標準。它能減少每次重講流程,但不保證生成結果一定正確或符合品質要求。 Q2:有了 Skill,就不用學 Prompt 或專業知識了嗎?不是。Skill 可以把重複的操作規則整理起來,但使用者仍要提供目標與背景,並運用故事、影像、節奏和品質判斷來驗收結果。減少的是每次從零描述流程,不是專業判斷本身。 Q3:為什麼角色與場景要先整理成 Asset?把角色、場景、服裝、道具和狀態整理成可重複引用的 Asset,有助於維持不同鏡頭的參照一致,也讓團隊更容易找出需要修正的素材。模型仍可能產生偏差,因此 Asset 不能取代逐鏡檢查。 Q4:《HELL GRIND》的生成次數代表每個 AI 鏡頭都要生成 64 次嗎?不代表。製作方提供給媒體的數字是《HELL GRIND》前 25 分鐘用了 16,181 次影片生成,選出 253 個鏡頭,約為 64 次生成對應一個入選鏡頭的整體比值;這是該片的製作案例,不是普遍標準。 Q5:要怎麼開始把自己的專業整理成 Skill?先挑一個反覆執行、容易出錯的工作,記錄必要輸入、每一步的判斷規則、預期輸出和驗收條件;再把可重用的角色/場景/素材與檢查表整理好,讓 AI 先依流程執行,並在關鍵步驟保留人工審核。

  • article-我把 ChatGPT 接上自己的開發台 MCP,AI Coding 開始變成一條「軟體開發流水線」

    2026/9/14

    ChatGPT AI Agent Codex
    我把 ChatGPT 接上自己的開發台 MCP,AI Coding 開始變成一條「軟體開發流水線」

    最近我開始把 ChatGPT 接進原本提供給 Codex、Claude 使用的開發台 MCP。最有意思的地方,不是讓 ChatGPT 跟 Codex 搶著寫程式,而是把需求討論、工作規劃、程式實作與 Review 拆成不同角色。 我可以先讓 ChatGPT 查看開發台允許提供的專案脈絡,協助分析問題、整理風險與驗收條件,再透過 MCP 建立 Ticket,交給 Codex 接手。完成後,再把差異與測試結果交回來 Review。 以這個工作方式來看,分析和由 ChatGPT 發起的 MCP 操作使用 ChatGPT 端的可用額度,Codex 的工程執行則在 Codex 的工作環境中進行。乍看之下,好像終於能把 ChatGPT 每月訂閱用得更完整了 😂。但額度和費用會依方案、整合方式與工具呼叫而變化,這不是接上 MCP 就一定省錢的保證。 真正值得注意的,是 AI Coding 開始從「一個 Agent 包辦所有事」,走向「一組 Agent 按照分工接力完成工作」。 ChatGPT 不一定要寫程式,也能參與開發使用 Codex 時,我們常把需求理解、讀取 Context、規劃、修改、測試、Review 和下一步討論,全塞在同一個 Agent 裡。專案越大,耗費的時間和額度往往不只來自寫程式,也包括理解專案、追蹤進度、檢查結果和重新安排工作。 如果有一套開發台 MCP 能提供必要的專案狀態、Session 摘要或 Ticket 操作,ChatGPT 就可以先負責需要大量溝通和判斷的工作:釐清需求、找出風險、拆出可執行的工作,再把任務交給 Codex。 以一次長時間的工作樹合併任務為例,當 Codex 已經執行很久,我不一定要繼續在同一個 Agent 裡討論下一步。我可以請 ChatGPT 根據開發台提供的狀態,檢查目前結果、列出可改善處與潛在風險,再整理成一張 Codex 能接手的票。 這樣一來,ChatGPT 的價值不在於「代替 Codex 寫另一份程式」,而在於把模糊的討論轉成清楚、有優先順序、可以驗收的工作。 把不同角色接成一條開發流程如果把工作拆開來看,分工可以是: ChatGPT:需求分析與 Review。 協助釐清問題、檢查現況、拆解任務、補充驗收條件,並Review Codex 回報的結果。 開發台 MCP:提供連接與操作能力。 依照開發台實際設計,讀取被允許的 Context、建立或更新 Ticket、傳遞執行結果與工作狀態。 Codex:工程實作與驗證。 根據 Ticket 修改程式、執行測試,並回報差異、失敗項目和未解風險。 人:決定優先順序與重要操作。 確認需求、核准高影響變更,決定是否 Commit、Merge 或關閉 Ticket。 整體流程就會像這樣: 12345678910111213人提出需求 ↓ChatGPT 取得允許使用的專案脈絡並分析 ↓MCP 建立 Ticket,記錄工作範圍與驗收條件 ↓Codex 實作並執行測試 ↓開發台回報差異、測試結果與阻礙 ↓ChatGPT Review,整理下一步 ↓人確認是否 Commit、Merge 或關票 這條流程不代表每個 MCP 都有 Session、Ticket 或 Git 管理功能。MCP 規格提供的是連接模型應用與外部能力的通用介面;例如伺服器可以依實作提供可呼叫的 Tools、可讀取的 Resources 和 Prompts。開發台是否保存狀態、能不能開票或執行 Git 操作,仍要看實際 MCP Server 和周邊系統怎麼設計。MCP 官方規格:Server Features 因此我會把 MCP 想成這條流程的「連接層」,而不是整套開發管理系統本身。Session 保存、Ticket 欄位、權限控管、測試流程與工作狀態,都是 Harness 和開發台需要另外規劃的部分。 Agent Harness 讓模型有地方工作這個分工也呼應我最近一直在研究的觀念:Agent = Model + Harness。 大家常比較 GPT、Claude、Gemini 或 Codex 的模型能力。模型當然重要,但如果整條流程、專案脈絡和驗收方式都綁在單一模型裡,每次換模型都可能得重新建立工作方式。 如果自己的開發 Harness 已經整理好 Context、Tools、Ticket、Memory、Test、Git 和 Review Loop,模型就比較像其中一個可以調度的元件。今天可以 ChatGPT 規劃、Codex 執行;明天也可以換成另一個模型負責分析或 Review,再由適合的 Agent 實作。 這種可替換性不是插上另一個模型就會自動發生。不同模型可用的工具、輸入輸出格式和權限都可能不同,還是要有穩定的工作契約:任務怎麼交接、結果怎麼回報、測試如何判斷通過、失敗時誰要處理。 如果你想延伸理解 Harness 在 AI 開發流程中的位置,也可以閱讀從 Skill 到 Agent Harness:讓 AI 從知道怎麼做,走到真正完成工作;MCP、Skill 與 CLI 的分工則可參考AI 工具名詞全解析。 把 Ticket 寫成 Agent 能接手的工作Ticket 是這條流程能不能穩定運作的關鍵。若只有一句「幫我改善這段程式」,接手的 Agent 仍要猜背景、範圍和完成標準。每張票可以固定包含: 12345678910111213ticket_id: 自動產生title: 清楚描述要交付的結果background: 相關的專案脈絡problem: 目前遇到的問題priority: 優先級affected_files: 已知的相關檔案dependencies: 前置工作或相依項目acceptance_criteria: - 可明確驗收的條件test_requirements: - 完成前必須執行的檢查review_notes: 已知風險、限制或 Review 重點 其中 affected_files 可以列出已知範圍,但不應阻止 Codex 在檢查專案後指出還有其他必要檔案。真正重要的是 problem 說得清楚,acceptance_criteria 可以驗收,test_requirements 也符合專案實際狀況。 當 Ticket 結構固定,ChatGPT 就比較能把分析結果轉成工程任務;Codex 也能根據明確的交付條件回報完成、未完成與阻礙,而不是只回一句「已處理」。 下一場競爭可能是誰的 Harness 更完整當多個 Agent 開始分工,真正需要設計的就不只 Prompt,還包括它們共同使用的工作環境: Agent 能讀到哪些 Context,哪些資料不能取用? 誰能建立 Ticket、修改程式或執行 Git 操作? 測試失敗時,系統如何保留輸出並回報阻礙? 每個階段的完成條件是什麼,由誰 Review? Agent 交接時,下一位能否知道前一位做過什麼、為什麼這樣做? 當 MCP 工具可以建立或改變外部資料時,也要設計清楚的權限與人工確認邊界。不要只因為模型「做得到」,就讓所有操作都自動執行。 這些環節加起來,才是 Agent Harness 真正提供的工作條件。若系統有持續的 Context、明確的 Ticket、可執行的測試與可靠的回報方式,就能讓模型專注在任務,而不是每一輪都重新猜專案發生了什麼事。 從一張結構化 Ticket 開始如果你也想嘗試這種 AI Coding 工作方式,可以先挑一個範圍小、容易驗收的任務,整理出背景、問題、優先順序、驗收條件和測試要求,再觀察 ChatGPT 與 Codex 分工後有哪些地方仍需要人工補充。 接著再逐步加入專案 Context、Ticket 狀態、工具權限與 Review 流程。先讓交接清楚、失敗能回報,再決定哪些步驟適合自動化。 AI Coding 正從「我跟一個 AI 一直聊天,直到網站做完」,走向「我在管理一條由多個 AI Agent 組成的軟體開發流程」。ChatGPT 不一定要負責寫程式,Codex 也不必負責想完所有事情;把規劃、執行、測試和 Review 拆開,再讓 Harness 接得住每次交接,才會真正累積成自己的 AI 開發台。 常見問答 (FAQ)Q1:在這種 AI Coding 流程裡,ChatGPT 和 Codex 怎麼分工?ChatGPT 可以負責需求討論、專案分析、Ticket 規劃與結果 Review;Codex 可以接手明確定義的實作與測試工作。實際分工仍取決於各自可讀取的 Context、可用工具和權限。 Q2:MCP 會自動替我保存 Session 或建立 Ticket 嗎?不會。MCP 提供模型應用與外部 Tools、Resources、Prompts 溝通的介面;Session 保存、Ticket 系統與 Git 操作必須由實際 MCP Server 或周邊開發台提供。 Q3:把規劃交給 ChatGPT,能保證省下 Codex 額度嗎?不能保證。不同產品方案、帳戶額度、工具呼叫方式和任務執行環境都會影響使用量。這種分工可以把分析與工程執行分開觀察,但是否省錢要依自己的實際方案和用量判斷。 Q4:想開始使用多個 AI Agent 協作,第一步該做什麼?先挑一個小型、可驗收的任務,寫清楚背景、問題、完成條件與測試要求,再讓不同 Agent 接力執行。確認工作交接和失敗回報可靠後,再逐步擴充工具權限、Ticket 狀態與自動化程度。

  • article-【GPT-6 Astra 正在把 Vibe Coding,推向 Vibe World Building】

    2026/9/14

    AI工具 AI Agent Vibe Coding
    【GPT-6 Astra 正在把 Vibe Coding,推向 Vibe World Building】

    以前我們講 Vibe Coding,常見的想像是:「一句話,AI 幫我做網站、寫 App。」 但最近看到幾個 GPT-6 Astra 搭配 Unreal Engine、Blender 與 Three.js 的案例,我開始覺得,下一階段可能不只是 Vibe Coding,而是 Vibe World Building。 你不只是叫 AI 寫程式,而是讓 Agent 進入專業工具,協助建立角色、遊戲與可以互動的世界。更有意思的是:AI 越能操作專業軟體,我反而越覺得 Domain Knowledge 會變得更重要。 以下案例依照作者公開展示整理,重點是觀察工作方法,不代表每個人使用相同模型、方案與工具設定都能得到相同結果;實際能力也會隨版本、權限與專案環境變動。 AI 開始進入專業工具,而不只生成程式碼Vibe Coding 把「描述需求、產出程式」變得更容易;而這幾個 3D 案例再往前一步:Agent 開始操作 Unreal Engine、Blender 或 Three.js 專案,建立內容、反覆修改,並把場景、規則與互動組合在一起。 這個轉變不只是「AI 會不會 3D」,而是工作環境開始從人操作的軟體,變成 Agent 也能操作與檢查的執行環境。 案例一:從一個物件,走向逐街建構曼哈頓Matt Shumer 分享 GPT-6 Astra 在 Unreal Engine 中建構曼哈頓場景的過程,並描述它花了一週逐街完成細節。這已經不是只要求 AI「放一棟房子、加幾棵樹」,而是把工作尺度拉到街道與街區。 他也展示過另一個 Unreal Engine 世界:場景裡有以 Astra 驅動的角色 Agent,並以共同生存為目標互動。這讓「建構世界」不只包含空間,也開始包含世界中的行動者與互動規則。 當場景從單一物件擴大到街區,問題自然會延伸到道路與建築的空間關係、資產管理、場景分工與驗收方式。若要進一步投入正式製作,效能、碰撞、載入策略與可維護性仍需要另外檢查;一段令人驚豔的展示,不等於所有製作環節都已完成。 來源:Matt Shumer 的曼哈頓建構展示、Astra Agent 世界展示。 案例二:拓撲不一致,就改用離散 Mesh 切換角色表情常用 Blendshape 做平滑變化,但這類頂點形變通常仰賴相容的網格拓撲與頂點對應。若不同 AI 生成的表情 Mesh 拓撲不一致,就不一定能直接做傳統的平滑 Morph。 Nano 分享的 Blender 做法不是硬把所有網格變成同一種拓撲,而是換個解題方向:先把不同表情的 Mesh 對齊;切換時顯示目標表情,並把未啟用的 Mesh 縮小、藏進角色頭部,再透過 Blender Driver 控制切換。 這不是 Blendshape 的平滑融合,而是離散表情切換。它用明確的取捨避開拓撲限制,適合某些表情展示情境,卻不能因此宣稱能取代所有臉部動畫流程或提供連續的表情過渡。 我覺得這個案例特別值得看,不是因為 Astra 知道 Blender 哪個按鈕在哪裡,而是 Nano 知道問題來自哪裡,並知道還有哪些方法可以繞過去。 來源:Nano 在 Blender 中切換角色表情的展示與提示詞。 案例三:一款跑酷遊戲背後,是一整套產品規則MSB 使用 GPT-6 Astra 搭配 Three.js 分享豎屏跑酷遊戲《THE LAST GATE》。看起來是讓角色往前跑,拆開需求後卻是一組完整的遊戲系統: 玩家通過加減乘除算術門時,隊伍人數會即時改變。 撞上障礙物會造成實際隊員損失,而且畫面人數要和遊戲中的真實人數一致。 終點遭遇會依最後存活的隊員人數決定。 需求包含三條短路線、即時重試,以及帶 Seed 的輸入回放。 這已經不是「幫我做一個 Three.js Demo」,而是把玩法規則、3D 場景、互動、狀態變化與可重現測試一起交給 Agent 處理。作品是否能投入正式產品,仍要再驗收效能、操控手感與程式維護性;但需求本身已經從一句畫面描述,長成可檢查的產品規格。 來源:MSB 的《THE LAST GATE》公開貼文。 三個案例,代表三種建構尺度 尺度 案例 真正要處理的問題 世界級 Unreal Engine 曼哈頓與 Agent 世界 空間關係、場景組織、資產與行動者 角色級 Blender 離散表情切換 拓撲限制、替代方案與表情控制 產品級 Three.js《THE LAST GATE》 遊戲規則、互動狀態、重試與回放 我看到的不是「GPT-6 Astra 很會 3D」而已,而是 AI 開始透過專業工具,把世界、角色與產品的不同層次串起來。 AI 越會操作軟體,Domain Knowledge 為什麼越重要?很多人看到 AI 越來越會用 Blender,第一個反應可能是:「那以後是不是不用學 Blender 了?」 我反而覺得,答案可能剛好相反。 真正厲害的不是 Agent 知道哪個按鈕在哪裡,而是有人知道問題為什麼發生、有哪些限制、什麼 workaround 可行,以及最後怎樣才算完成。 如果你知道 Blendshape、Topology、Mesh、Driver 是什麼,才比較可能看出表情網格不相容的原因,並想到可以改用離散切換。若連問題的語言都不熟悉,就很難把這種解法交代給 Agent,也不容易判斷結果有沒有真的做到。 所以 AI 淘汰的可能不是「懂 Blender 的人」,而是只知道 Blender 按鈕在哪裡、卻說不清楚問題與完成標準的人。 以前你懂 Blender,還得親手操作每一步;懂遊戲設計,也可能得等工程師把規則寫出來。Agent 改變的是專業知識的產能:你可以把問題、限制、不要採用的方法、可行的 workaround 與驗收標準交給 Agent,再由專業工具把它落地。 Domain Knowledge × Agent × Professional Tools 專業知識負責判斷,Agent 負責執行,專業工具負責把想法變成可以檢查與迭代的成果。 如果你想延伸看「如何把領域經驗交給 AI 軟體化」,可以讀我之前寫的把專業知識變成軟體;關於 Vibe Coding 如何改變軟體價值,也可參考專業知識與 Vibe Coding 的商業機會。 Vibe Coding 的下一階段,可能是 Vibe Anything以前學 Photoshop、Blender 或 Unreal Engine,常常代表自己要親手完成大量操作。未來你或許不必逐一操作每個按鈕,但仍需要理解這個領域有哪些物件與規則、問題通常出在哪裡、有哪些解法,以及如何驗收。 Vibe Coding 可能只是第一站。接下來還會有 Vibe 3D、Vibe Game Development、Vibe Animation,甚至 Vibe Engineering 與 Vibe World Building。關鍵不是「每套軟體的按鈕都記熟了沒」,而是當 AI 已經能操作工具時,你知不知道該交代什麼、該限制什麼,又該如何判斷它做得對不對。 常見問答 (FAQ)Q1:Vibe World Building 和 Vibe Coding 有什麼不同?Vibe Coding 通常聚焦於用自然語言描述需求、讓 AI 產生或修改程式;Vibe World Building 則把 Agent 帶進 Unreal Engine、Blender、Three.js 等專業環境,處理場景、角色、規則與互動,目標尺度從一段程式碼擴大到可探索或可玩的世界。 Q2:為什麼 AI 越會操作 Blender,專業知識反而越重要?專業知識能幫你定義問題、提供限制、選擇 workaround,並訂出驗收標準。Agent 可以執行很多操作,但仍需要有人判斷網格、表情或動畫是否符合實際用途。 Q3:不同拓撲的表情 Mesh 可以直接做平滑 Blendshape 嗎?不一定。傳統 Blendshape 的頂點形變需要相容的網格與頂點對應;若拓撲不同,可能要先整理網格,或採用像案例中的離散 Mesh 切換。離散切換不等於平滑表情融合,也不是適用所有角色動畫的通用替代方案。 Q4:AI 做出的 3D 遊戲展示,就等於可以正式上線嗎?不等於。除了畫面與主要玩法,仍要測試效能、操控、錯誤狀態、裝置相容性與後續維護。案例呈現的是 Agent 能協助建構與實作的範圍,正式產品仍需要明確的驗收與測試。 Q5:想開始用 Agent 建立 3D 或遊戲專案,最先要準備什麼?先把目標拆成可檢查的規則:有哪些物件、它們如何互動、哪些限制不能違反,以及怎樣算完成。從小範圍任務開始,讓 Agent 執行後再用專業知識檢查結果,會比只要求「做得漂亮」更容易迭代。