2026/9/22
AI Agent Codex MCP華為「天才少年」把 AI Agent 寫成一本開源教科書,這幾章最值得先啃
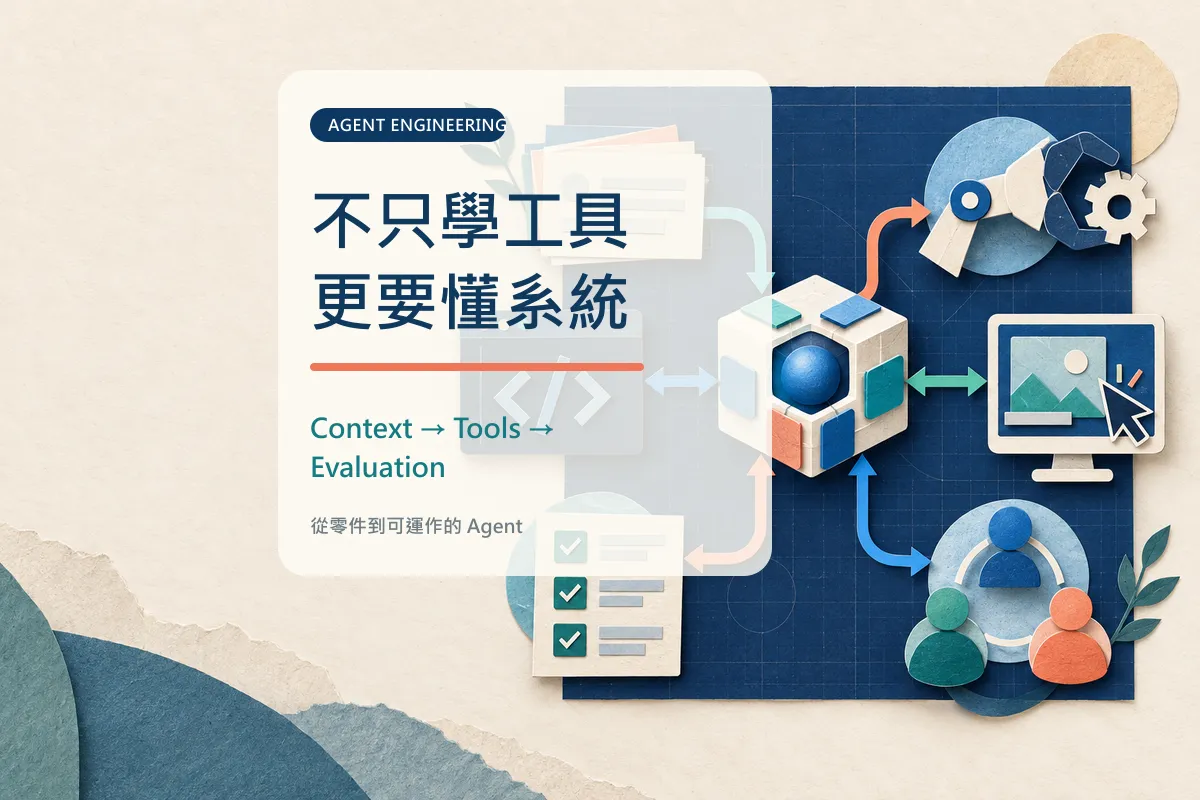
最近看到一個 GitHub 專案時,我原本以為又是一本 AI Agent 教學。 點進去之後才發現,規格有點誇張。 《深入理解 AI Agent:設計原理與工程實踐》不只免費開源,目前的 2.0 版還整理成:10 章正文、109 個配套實驗、PDF、EPUB、繁體中文版與 15 種語言版本,程式碼也一併公開。 我更在意的是,這不是把一堆工具名詞排在一起的入門書。它試圖回答一個更根本的問題:一個能在真實世界工作的 Agent 系統,到底要怎麼被設計出來? 作者李博杰的背景也讓這件事更有意思。公開資料顯示,他曾就讀中國科大少年班學院,完成中科大與微軟亞洲研究院聯合培養博士,並曾入選華為首批「天才少年」計畫;他的個人資料頁也列出系統、研究與工程相關經歷。中國科大資料與作者個人頁都可交叉參考。 所以我特別想看:一個實際做過系統、Infra、研究與工程的人,會怎麼拆解現在大家都在談的 AI Agent? 先記住這個公式:Agent = LLM + Context + Tools這本書一開始就把 Agent 壓成一個非常簡單的公式: Agent = LLM + Context + Tools LLM 是大腦:理解、推理、產生下一步。 Context 是它此刻知道什麼:任務、歷史、規則、檔案、記憶與工具描述。 Tools 是它做得到什麼:搜尋、查資料庫、改檔案、跑程式、操作瀏覽器或電腦。 看起來很簡單,但整本書就是沿著這三件事一路拆下去:Coding Agent、MCP、Computer Use、Memory、Multi-Agent,甚至 Agent 如何從執行紀錄持續進化。 這正是我覺得它值得讀的原因。 現在學 Agent,很容易學成「會 n8n、會串 API、會 MCP、會做 RAG、會用 Codex 或 Claude Code」。但這些其實比較像零件。 再往上一層,真正該問的是: 一個好的 Agent 系統,怎麼在正確的時候取得正確資訊、選對工具、完成任務,並且被驗證? 如果你已經開始用 Codex、Claude Code、MCP 或 Computer Use,我反而不建議一開始從第一章一路線性讀完。下面這幾章會更有感。 第一個最推薦:Context Engineering以前大家都在談 Prompt Engineering;但在 Agent 工作流裡,Prompt 往往只是 Context Engineering 的一小部分。 Agent 表現好不好,很大程度取決於: 它目前到底看到了哪些資訊? 哪些資料應該放進 Context,哪些要移出去? Skill 該在什麼時候載入? 對話與工作紀錄要如何壓縮? 工具說明要全部塞進去,還是動態發現? 工作做到一半 Context 撐不住時,系統要怎麼恢復? 書中的第二章直接談 KV Cache、提示工程、Agent Skills 與 Context Compression。對已經在使用 Coding Agent 的人來說,這一章的價值很高,因為你會開始理解:為什麼同一顆模型放在不同工作環境裡,結果可能差那麼多。 下一階段的競爭未必只是「哪個模型 IQ 更高」,而是: 誰能在正確的時候,把正確的 Context 給模型。 這也和我先前整理的從 Skill 到 Agent Harness很接近:模型能力只是其中一層,工作環境如何供應 Context、工具、規則與回饋,才決定它能不能把任務走完。 第二個必看:Tools 與 MCP第四章談工具,當然也包含 MCP;但我覺得比 MCP 名稱本身更重要的,是它背後的觀念: 工具就是 Agent 的手。 LLM 再聰明,如果只能產生文字,它仍然比較像聊天機器人。 接上搜尋,它能查資料;接上資料庫,它能查詢與寫入;接上 Gmail 或 ERP,它能處理企業流程;接上瀏覽器與 Computer Use,它甚至可以操作沒有 API 的網站與 GUI 軟體。 所以 MCP 不是終點,而是讓模型應用與外部能力更容易連接的介面。真正值得思考的是: Agent 怎麼知道現在需要哪一個工具? 工具描述是否足以讓它選對? 它沒有能力時,能不能發現並載入合適的 Skill、MCP 或 API? 任務結束後,怎麼把不必要的工具說明移出 Context? 這才是走向通用 Agent 的方向。若你還在釐清 MCP、Skill 與 CLI 的角色分工,可以先讀站內這篇:AI 工具名詞全解析。 第三個可以直接跳讀:Coding Agent這本書有一句我很喜歡: 程式碼,是「可以建立新工具的工具」。 這句話很能解釋,為什麼這一兩年 Coding Agent 會變得這麼重要。 以前的 Agent 遇到沒有工具的事情,可能只能停下來;現在的 Coding Agent 可以嘗試自己寫一個小工具、跑測試、修 bug,再拿這個程式完成原本的任務。 所以 Codex、Claude Code 真正值得注意的地方,不只是「幫你寫程式」,而是它們讓 Agent 開始具備擴充自己能力的能力。 當然,這不代表可以放任 Agent 任意執行。工具權限、Sandbox、測試、Review 與明確的完成條件,仍然是系統設計的一部分。會寫程式不等於任務一定完成;能測試、能回報、能被人驗收,才是可靠的工程流程。 第四個:從 Computer Use 看 Agent 的行動範圍過去自動化多半依賴 API、CLI、MCP 或 Browser Automation。但企業裡有大量系統根本沒有 API:ERP、MES、老舊 Windows 軟體、內部行政平台,甚至只能靠滑鼠點擊的工具。 這時候 Computer Use 的意義,就不只是「AI 會控制滑鼠」。書裡從兩個角度理解它: Observation Space:Agent 可以觀察到多少世界?文字、圖片、語音、螢幕,或實體環境。 Action Space:Agent 可以對世界做多少事?產生文字、呼叫工具、點擊 GUI,甚至控制機器人。 從這條線看,Agent 正在從聊天介面走向可以工作、可以觀察結果、也能根據結果再行動的代理人。 不過,Computer Use 也會把安全與可靠性問題放大:畫面改版、權限不足、不可逆操作、錯誤回饋不清楚,都需要在流程中設計 guardrail,而不是只追求「它能不能點」。 做企業 AI,一定要補:Agent Evaluation我覺得這是現在很多課程最容易略過、但企業最需要的一章。 我們常說 Claude 比較聰明、GPT 比較穩、Gemini 的 Context 比較大,或某個 Agent「感覺」比較好用。但當 Agent 要進入企業流程,不能只靠感覺。 更好的做法是建立自己的任務集,例如 100 個真實任務,然後觀察: 要測什麼 為什麼重要 成功率 任務是否真的被完成,而不只產生看似合理的回答 成本 Token、工具呼叫與人工覆核是否能負擔 延遲 工作流程是否能在可接受時間內交付 人工介入率 哪些步驟仍需要人,以及原因是什麼 重試次數 Agent 是否經常卡住、繞圈或選錯工具 錯誤類型 問題是 Context、工具、權限、模型還是流程設計 最後才有根據決定:哪個模型、哪個 Agent、哪種 Prompt、哪個 Harness,適合這一項工作。 Evaluation 不是最後才補的報表,而是用來推動系統改進的方向盤。 更接近「AI 員工」的關鍵:持續進化我自己也非常想看第九章的 Agent 持續進化。 現在很多所謂 AI 員工,本質上仍是: 固定 Prompt + 固定 Workflow + 幾個工具 它可以每天重複執行,但不一定會從結果學到東西。 更有意思的問題是:Agent 完成一個任務後,能不能留下可分析的執行軌跡(trajectory)?這次為什麼成功?失敗在哪裡?下一次要更新 Knowledge、Prompt、Skill、工具選擇,還是程式碼? 1234567891011任務 ↓執行 ↓留下 Trajectory ↓分析成功與失敗 ↓更新 Knowledge / Prompt / Skill / Code ↓下一次做得更好 這時候才開始接近「會成長的 AI 員工」,而不只是換了皮的 Chatbot。 前提是,你必須先有明確的成功標準與可觀測紀錄;否則 Agent 留下的只是一大串 log,沒有辦法轉成真正的改善訊號。 Multi-Agent 不是畫一張公司組織圖Multi-Agent 也很容易被玩成「行銷 Agent、PM Agent、工程 Agent、財務 Agent」排成一張組織圖。 但真正困難的工程問題反而是: Agent 之間應該分享多少 Context?哪些資訊必須隔離? 誰負責拆任務?誰擁有最後決策權? 交接資料如何結構化,才不會在對話中流失? Agent 意見衝突時怎麼處理? 怎麼避免它們彼此聊天、消耗 Token,卻沒有推進結果? 這些都是協作系統設計問題,不是多開幾個聊天視窗就會自然解決。 如果你已經會用 Agent,我建議這樣讀如果你已經在玩 Codex、Claude Code、MCP 或 Computer Use,我會建議先走這條路: 1234567Context Engineering → Tools / MCP → Coding Agent → Computer Use → Agent Evaluation → Agent 持續進化 → Multi-Agent 再回頭補 Memory / RAG、模型後訓練、SFT / RL,通常會更有感。因為你已經知道這些零件要被放進什麼樣的工作系統裡。 而且這套內容最棒的地方,不是只讓你讀。專案目前提供 109 個配套實驗,很多概念可以直接跑、直接觀察、直接改。比起再追 20 個剛推出的 AI 工具,我更想從中挑出大約 20 個最值得玩的實驗,再拿 Codex、Claude Code、MCP 與 Computer Use 重新實作一次。 工具會換,模型也會換;但 Context 如何設計、工具如何選擇、Memory 如何管理、Agent 如何評估、任務如何拆解、執行紀錄如何轉成改善,才是更能留下來的能力。 如果你最近也覺得 AI 工具已經多到追不完,或許現在正是回頭把「Agent 到底怎麼運作」真正弄懂一次的好時間。 資料來源與延伸閱讀 bojieli/ai-agent-book:深入理解 AI Agent:設計原理與工程實踐 作者李博杰公開個人資料 中國科大:李博杰獲 2017 年微軟學者獎學金 從 Skill 到 Agent Harness:讓 AI 從知道怎麼做,走到真正完成工作 常見問答 (FAQ)Q1:這本《深入理解 AI Agent》適合完全沒有程式背景的人嗎?可以先讀第一章建立全貌,但書內不少實驗需要讀懂並修改中等複雜度的 Python,並熟悉命令列、Git、JSON 與 REST API。若你的目標是實作,建議先從自己最常用的工具與一個小任務開始,再回頭閱讀對應章節。 Q2:為什麼已經會寫 Prompt,還要學 Context Engineering?Prompt 是一次交代模型怎麼回應的指令;Context Engineering 則處理整個工作過程中,哪些任務資料、歷史、規則、工具描述與記憶應該在何時被提供或移除。長任務與工具型 Agent 的品質,通常更受後者影響。 Q3:MCP 就是讓 AI Agent 變強的關鍵嗎?MCP 能讓模型應用以較一致的方式連接外部 Tools、Resources 與 Prompts,但它不是完整的 Agent 系統。工具選擇、權限、Context、錯誤處理、驗證與工作流程,仍需要由 Agent Harness 與產品設計處理。 Q4:企業要怎麼評估 Agent 是否真的可用?先建立由真實工作組成的任務集,為每個任務設定成功條件與不可接受的錯誤,再追蹤成功率、成本、延遲、人工介入率、重試次數與錯誤類型。不要只用單次展示或主觀體感選模型與工具。 Q5:Multi-Agent 一定比單一 Agent 好嗎?不一定。只有在任務能清楚分工、交接格式明確、資訊隔離與最終決策權都設計好時,多個 Agent 才可能帶來效益。若問題本來可由一個 Agent 穩定完成,多 Agent 反而可能增加成本、延遲與溝通失誤。