跳到主要內容

部落格

不定期分享最新資訊文章

  • article-我覺得 VoiceStudio 最值得注意的地方,根本不是免費

    2026/9/15

    AI自動化 AI工具 影音行銷
    我覺得 VoiceStudio 最值得注意的地方,根本不是免費

    最近看到一套開源 AI 語音工具 VoiceStudio。 它可以在自己的電腦執行,支援 TTS、語音複製、多角色語音與影片配音,也不需要每個月再付一筆訂閱費。 看到這裡,很多人的第一個反應可能是: 那我是不是可以不用訂 ElevenLabs 了? 但我研究完之後,反而覺得「免費」可能是這套工具最不重要的地方。 真正讓我感興趣的是另外一件事情: AI 配音,正在從一個「工具」,變成 AI 工作流裡的一個「節點」。 本文談的是我對 VoiceStudio 與本地語音工作流的觀察,不是對不同語音服務的固定排名。實際功能、模型支援、硬體需求與授權方式,都應以當下的專案文件與模型授權條款為準。 我們現在用 AI,其實還是在「操作軟體」想一下現在大部分人怎麼做 AI 影片。 先叫 ChatGPT 寫腳本。 複製文字。 打開配音網站。 貼上文字。 選聲音。 按生成。 下載音檔。 再打開剪輯軟體。 匯入音訊、對字幕、找 B-roll、剪輯、輸出。 看起來整個流程用了很多 AI,但其實中間有一個很重要的角色一直沒有消失: 你。 你還是那個負責把 A 工具的結果複製到 B 工具,再把 B 工具的結果下載下來丟進 C 工具的人。 換句話說,AI 很厲害,但你還是一個「AI 工具操作員」。 這也是我之前思考 AI 影片工廠時,會把腳本、配音、字幕、素材與剪輯拆成不同能力的原因。可以先參考用 Codex 打造 AI 影片工廠:串接六大 AI 能力的完整工作流,影片工廠真正要處理的,不只是多找到幾個好用工具,而是讓每個能力可以被下一個步驟穩定接住。 真正的改變,是你連 VoiceStudio 都不用打開VoiceStudio 讓我感興趣的,不只是它可以在本地執行。 而是這類工具開始提供 API、MCP 之類可以讓其他程式直接呼叫的介面。 這件事情看起來很工程師,對內容創作者其實非常重要。 因為當一個 AI 工具可以被程式呼叫之後,「人」就不一定要站在中間了。 例如我最近一直在研究 AI 自動剪輯。 理想中的流程不是: 1我打開 ChatGPT → 打開配音軟體 → 打開剪輯軟體 而是: 1234567891011121314151617文章完成 ↓AI 自動整理成短影音腳本 ↓自動送進本地 Voice Clone ↓產生我的聲音 ↓自動分析旁白時間軸 ↓自動尋找 B-roll ↓自動產生字幕與字卡 ↓自動剪輯 ↓輸出成片 如果這條流程真的串起來,我根本不需要知道 VoiceStudio 的「生成」按鈕在哪裡,甚至不用打開 VoiceStudio。 因為它已經從「我要操作的軟體」,變成「我的 AI 員工背後會使用的一項能力」。 我覺得這才是接下來真正重要的改變。 以後我們可能不會在意「你用哪一套 AI」現在很多人在比較: ChatGPT 還是 Claude? ElevenLabs 還是 VoiceStudio? 這個生圖模型比較強,還是那個比較強? 這些當然重要,但如果 Agent 的發展繼續下去,我猜這些問題的重要性會慢慢降低。 因為使用者最後看到的可能根本不是工具。 你只會跟 AI 說: 把這篇文章做成三支短影音。 剩下的事情由 Agent 自己決定。 1234567需要寫腳本,就呼叫文字模型需要圖片,就呼叫生圖模型需要我的聲音,就呼叫本地 Voice Clone需要字幕,就呼叫語音辨識需要素材,就去素材庫搜尋需要剪輯,就呼叫影片處理工具最後丟三支影片給我挑 這時候,ChatGPT、VoiceStudio、FFmpeg、Whisper 或其他模型,全部退到後台。 使用者根本不需要看到它們。 這不代表底層工具不重要,而是工具的價值開始從「使用者介面有多順」延伸到「能不能穩定成為其他系統可呼叫的能力」。 本地 AI 真正有趣的地方,也不只是省錢很多人談 Local AI,第一件事情就是算成本: ElevenLabs 一個月多少錢? 本地模型是不是免費? 跑在自己的電腦上是不是比較便宜? 如果只是偶爾做幾支影片,我甚至覺得這不是最重要的問題。 雲端服務通常比較方便,模型可能也更穩定;本地方案則會多出硬體、安裝、更新、維護與排錯成本。軟體可以免費使用,也不代表每個語音模型都能免費商用,實際使用前仍要確認各自的授權條款。 真正有趣的是: 當 AI 能力搬到自己的電腦,它開始變成你可以控制的基礎設施。 不用每一次都開網頁。 不用每一次都上傳資料。 也不用每一次都等人按下「生成」。 只要電腦開著,Agent 就可以自己呼叫。 這對一天做一支影片的人,差異可能還不大。 但如果未來你不是一天做一支,而是讓 AI 一次處理 20 支、50 支,甚至 100 支內容,整個思考方式就完全不一樣了。 你不再是在找: 最好用的 AI 配音網站。 你是在建立: 我的 AI 內容基礎設施。 聲音,也正在變成一種可以重複使用的數位資產另外一個我覺得很有意思的變化,是「自己的聲音」。 以前聲音不是資產。我要錄一段新的內容,就必須重新開麥克風講一次。 講錯一句,重新錄。 課程改了一句,重新錄。 想做英文版,再錄一次。 但是 Voice Clone 出現之後,邏輯開始改變。 我的聲音可以被抽象成一個可以重複呼叫的能力。 今天拿來做短影音。 明天拿來補錄線上課程。 後天文章自動轉 Podcast。 甚至同一支內容自動產生不同語言版本。 所以未來自媒體經營者要管理的,可能不只有文章、圖片、影片與 Prompt,還會多一個東西: 自己的 Voice Profile。 它會跟 Logo、品牌色、字型、人物 LoRA 一樣,逐漸變成個人品牌的數位資產。 但這種資產也需要被好好管理:聲音樣本的保存、誰可以呼叫、哪些內容可以生成、是否允許商用,以及被濫用時如何撤銷,都不能只靠「模型很像」來處理。 把「我是誰」和「我要怎麼說」拆開這件事對自動剪影片非常重要。 一支短影音不可能從頭到尾都使用同一種情緒: 開頭 Hook 可能要比較興奮 中段解釋要穩定清楚 提醒風險時要嚴肅 講到反差時可能要驚訝 最後 CTA 又要比較親切 因此,Voice Engine 可以拆成兩層: 我是誰: 聲音的音色、辨識度與個人品牌特徵。 我要怎麼說: 情緒、語速、停頓、重音與表達方式。 理想的流程會是: 1234567891011腳本 ↓AI 理解內容 ↓判斷每一段情緒 ↓選擇語速與表達方式 ↓Voice Clone 生成 ↓送進剪輯流程 這時候 AI 就不只是單純「念稿」,而是開始理解:這句話應該怎麼說。 如果你也在處理影片聲音,可以延伸參考短影音音效怎麼選?從剪映內建到 AI 生成,一次搞懂 SFX 工作流。克隆旁白解決的是「誰在說」,SFX 與混音則決定觀眾「聽起來感覺如何」,兩者應該放在同一條聲音工作流裡設計。 我不太想問「VoiceStudio 能不能取代 ElevenLabs」因為我覺得這個問題太小了。 ElevenLabs 好不好用?當然好用。 VoiceStudio 免費嗎?軟體本身確實可以免費使用,但實際使用的語音模型仍要確認各自授權。 真正值得測試的是: 我能不能把 VoiceStudio 塞進自己的 AI Short Factory,然後以後根本不用打開它? 如果可以,那代表配音這件事情已經從: 我要做的工作 變成: AI 自己會完成的一個步驟 再往後,生圖是一個節點,配音是一個節點,字幕是一個節點,B-roll 是一個節點,剪輯是一個節點,發布也可能是一個節點。 當這些節點全部串起來,我們真正建立的就不再是一堆 AI 工具,而是一條: AI 內容生產線。 所以 VoiceStudio 免費這件事情,我當然很開心。 但比免費更讓我興奮的是: 我們正在慢慢進入一個「不用操作 AI 工具」的時代。 真正值錢的能力,也會從「你會多少 AI 工具」,逐漸變成: 你能不能把這些 AI 能力,組成一套會自己工作的系統? 這可能才是 AI 自媒體下一階段真正拉開差距的地方。 常見問答 (FAQ)Q1:VoiceStudio 最值得注意的地方是免費嗎?不只是免費。更值得注意的是,VoiceStudio 這類本地語音工具若能透過 API 或 MCP 被其他程式呼叫,就有機會成為 AI 內容工作流裡的語音節點,讓配音從手動操作變成可重複執行的步驟。 Q2:接進 AI 工作流後,還需要打開 VoiceStudio 嗎?理想上不需要。當 Agent 已經能透過 API 或 MCP 呼叫語音能力,使用者只要提出「把文章做成短影音」這類目標,VoiceStudio 可以在後台完成配音;但實際能否做到,仍取決於工具提供的介面、設定方式與整合品質。 Q3:本地 AI 語音一定比較省錢嗎?不一定。本地執行可能減少訂閱或按量計費,但仍要計入硬體、安裝、更新、維護、電力與排錯成本;此外,軟體免費也不代表所使用的語音模型都允許免費商用,必須逐一確認授權。 Q4:自己的 Voice Profile 可以當成個人品牌資產嗎?可以把它視為一種可重複呼叫的數位資產,但需要同時管理聲音樣本、存取權限、生成範圍、商用許可與撤銷機制。聲音相似度只是品質的一部分,不等於完整的品牌治理。

  • article-AI 自動剪片做到最後,我才發現真正缺的是自己的聲音 API

    2026/9/11

    AI自動化 AI工具 影音行銷
    AI 自動剪片做到最後,我才發現真正缺的是自己的聲音 API

    最近我一直在調整自己的 AI 自動剪影片流程。 文章可以自動改成短影音腳本。 知識圖卡可以自動生成。 字幕可以自動上。 B-roll 可以自動配。 重點遮罩、動畫、轉場,甚至剪輯節奏,也都可以慢慢交給 AI。 但做到最後,我突然發現一件事。 真正還沒有被自動化的,反而是: 我的聲音。 如果每一支影片最後還是要自己重新錄旁白,那前面再怎麼自動,其實都還差最後一哩。 所以我最近開始重新研究「克隆音」。 但這次我不是想找一個: 可以把我的聲音複製得很像的 AI 工具。 我想的是另一件事: 能不能把我的聲音,直接變成 AI 自動剪片系統裡的一個 API? AI 自動剪片為什麼會卡在最後一哩?一條完整的影片工作流,現在已經可以拆成很多個可被自動化的能力: 文章自動改成短影音腳本 知識圖卡自動生成 字幕自動上稿 B-roll 自動配對 重點遮罩、動畫與轉場自動完成 剪輯節奏交給 AI 協助判斷 這些環節都完成後,旁白卻可能還是要由本人重新錄製。對個人創作者來說,這不只是多花一點時間,也會讓整套「內容工廠」在最後一步停住。 這也是我開始重新研究 Voice Clone 的原因。不過,我真正想找的不是另一個獨立工具,而是一個能被工作流穩定呼叫的聲音元件。 這個方向,也可以接到我之前整理的用 Codex 打造 AI 影片工廠:串接六大 AI 能力的完整工作流。影片工廠不只要能產生畫面,也要能把聲音當成可替換、可擴充的能力。 克隆音已經從模型訓練,走向可呼叫的工作流元件以前講 Voice Clone,很容易想到一個完整的模型訓練專案: 錄很多音訊。 整理資料。 訓練模型。 等待幾個小時。 得到一個自己的聲音模型。 但現在很多 Zero-shot TTS,已經可以只用一小段參考音訊,直接模仿聲音的音色。像是我目前正在看的: IndexTTS-2.5 Qwen3-TTS Chatterbox V3 GPT-SoVITS CosyVoice 3 Fish Speech 這些模型與版本是我目前的研究方向與工作流示例,不代表固定排名;支援的語言、情緒控制、硬體需求與授權方式,都可能隨版本和方案變動,實際使用前仍要回到各專案的官方文件確認。 有些情境甚至不需要 Fine-tune。你只要給它: 一段你的聲音 一段新的文字 它就可以直接嘗試用你的音色把文字說出來。 這讓克隆音慢慢從「模型訓練專案」,變成「可以被工作流直接呼叫的元件」。 對我來說,理想的介面不是讓剪輯系統知道底下使用哪一套模型,而是把底層差異藏起來: 12345請用我的聲音念這段文字 ↓ Voice Engine API ↓ 回傳 WAV 或音訊檔 為什麼我現在最想研究地端克隆音?如果要把克隆音塞進自動剪影片流程裡,地端有很多優勢。重點不只是省 API 費用,更重要的是控制權。 我可以自己決定: 腳本怎麼切句 一次生成多少字 情緒怎麼控制 專有名詞怎麼唸 要不要快取 生成失敗怎麼重試 哪些段落要重新生成 如何把引擎包成 REST API 最後,剪輯系統根本不用知道底下是哪一套模型。它只要送出文字與必要參數,拿回一段可以繼續進入剪輯流程的音訊。 這種抽象層很重要。今天底層是 IndexTTS,明天換成 Qwen3-TTS,甚至某一批任務改走雲端 API,上層的影片工作流都不必整套重寫。 MacBook 也能先把 Prototype 跑起來這是我最近覺得很有意思的地方。 以我目前看到的 IndexTTS-2.5 使用情境來說,它已經能在 Apple Silicon 的 MPS 環境進行推論。也就是說,M1、M2、M3、M4 這些 Mac,都有機會直接拿自己的 GPU 做實驗。 我自己的 MacBook Pro M2 Pro、16GB Unified Memory,也可以先拿來做 Prototype。 當然,16GB 記憶體不算多。如果一次生成很長的旁白,或同時開著許多應用程式,記憶體仍然會吃緊。這裡的重點不是宣稱 Mac 可以取代所有 GPU Server,而是: 30 秒短影音 1 分鐘旁白 課程分段音訊 這些任務已經足以讓個人開發者研究整條流程,先驗證切句、快取、重試與剪輯串接,再決定是否需要更大的硬體。 換句話說,不一定要先買 RTX 4090,也不一定要一開始就租 GPU Server。一台手邊的 Mac,就可以先把 Voice Engine 的 Prototype 跑起來。實際效能仍會受到模型版本、量化方式、音訊長度、背景程序與安裝環境影響。 評估克隆音,真正的重點不只是「像不像」以前評估克隆音,我們可能只問: 像本人嗎? 但真正要放進內容工廠,至少還要再問: 台灣國語自然嗎? 情緒夠不夠自然? 長文會不會開始飄? 停頓是不是像真人? 專有名詞會不會亂唸? 同一個 Voice 能不能跨語言使用? 生成速度夠不夠快? 「85% 像本人」可能還不夠。如果它每次都把 Claude 唸錯、Gemini 唸得怪怪的、ComfyUI 亂念,或把 n8n 的讀法弄得不一致,影片仍然會出戲。 所以我甚至開始想做一份自己的專有名詞發音字典。腳本進入 TTS 之前,先自動做文字前處理: 名詞 預期處理 Claude 固定適合旁白的讀法 Gemini 固定適合旁白的讀法 Anthropic 固定適合旁白的讀法 n8n 固定適合旁白的讀法 這些讀法不一定要交給模型臨場猜,而是先在 TTS 前統一替換或標記。久了以後,這套 Voice Engine 不只會越來越像我的音色,也會越來越接近我的內容風格。 如果你也在處理影片聲音,可以先參考短影音音效怎麼選?從剪映內建到 AI 生成,一次搞懂 SFX 工作流。克隆旁白解決的是「誰在說」,SFX 與混音則決定觀眾「聽起來感覺如何」,兩者應該放在同一條聲音工作流裡設計。 把「我是誰」和「我要怎麼說」拆開這件事對自動剪影片非常重要。 一支短影音不可能從頭到尾都使用同一種情緒: 開頭 Hook 可能要比較興奮 中段解釋要穩定清楚 提醒風險時要嚴肅 講到反差時可能要驚訝 最後 CTA 又要比較親切 因此,Voice Engine 可以拆成兩層: 我是誰: 聲音的音色、辨識度與個人品牌特徵。 我要怎麼說: 情緒、語速、停頓、重音與表達方式。 理想的流程會是: 1234567891011腳本 ↓AI 理解內容 ↓判斷每一段情緒 ↓選擇語速與表達方式 ↓克隆音生成 ↓送進剪輯流程 這時候 AI 就不只是單純「念稿」,而是開始理解:這句話應該怎麼說。 不想自己維護模型,雲端 TTS 也已經很成熟地端是我目前很想研究的方向,但如果不想自己維護模型,雲端方案其實已經很方便。以我目前的觀察,值得放進測試清單的包括: ElevenLabs MiniMax Fish Audio Qwen/CosyVoice Cloud Cartesia PlayHT Resemble AI Google Chirp 3 Azure Custom Voice HeyGen Synthesia 每一家定位不一樣,這份清單是研究與選型的起點,不是永久排名。若要找一個成熟基準,我會先看 ElevenLabs;如果主要做中文短影音,我會想測 MiniMax;如果在意情緒、角色感、Podcast 或漫劇,Fish Audio 會是值得研究的方向;如果以後要做即時 Voice Agent,則可以研究 Cartesia。 雲端最大的好處是不用自己處理: CUDA MPS 記憶體配置 模型環境損壞 硬體升級 API Key 拿到就可以接。對大量生產來說,這確實很省事;但費用、資料處理政策、延遲、速率限制與語音授權,仍然要依各家最新方案確認。 地端和雲端不是二選一,而是混合式 Voice Engine所以我現在反而不覺得這是一場「地端 vs 雲端」的戰爭。更合理的做法,可能是建立一層混合式 Voice Engine: 任務情境 可以優先測試的方向 平常的短影音與開發測試 地端 IndexTTS、Qwen3-TTS 或 Chatterbox 突然出現大量任務 切換 MiniMax API 英文或多語言內容 切換 ElevenLabs 情緒較重的內容 測試 Fish Audio 即時 AI Agent 對話 研究 Cartesia 這個概念其實跟現在使用 LLM 很像。我們已經不太會只問:「全世界最好的 AI 模型是哪一個?」而是開始問:「這個任務,現在應該用哪一個模型?」 未來 TTS 很可能也會一樣。真正重要的不是押中唯一答案,而是把模型做成可以替換的底層能力,讓上層工作流按照任務、成本、延遲、語言與情緒需求選擇引擎。 Voice Conversion:先把話說好,再換成我的聲音這次研究時,我看到 Seed-VC 這類 Voice Conversion 技術,反而讓我產生另一個想法。 也許不一定要要求同一套 TTS 同時做到: 聲音像我 情緒自然 節奏漂亮 表達生動 全部一次完成。 可以拆開處理:先找一個最會「說話」的 AI,讓它負責情緒、節奏、停頓與表達,再用 Voice Conversion 把聲音換成我的音色。 1234567最佳 TTS ↓先把話說好 ↓Voice Conversion ↓換成我的聲音 這個思路很有意思,因為它把「講得好」和「像我」拆成兩個不同問題。有時候,拆開反而更容易做到,也更容易針對每一段找出可以改善的地方。 我真正想做的,是自己的 Voice Layer所以我現在真正想做的,其實不是找最好用的克隆音。 我想做的是自己的Voice Layer。 未來不管是: 短影音 線上課程 Podcast AI 新聞 數位分身 AI Agent 互動式課程 全部都可以呼叫同一層聲音服務。 輸入文字以後,它自己決定: 該用哪個 Voice Engine 該用什麼情緒 語速多少 專有名詞怎麼念 是否需要快取或重新生成 最後回傳一段聽起來像我的聲音。 到了這一步,克隆音就不再只是一個 AI 工具,而會變成個人品牌的一層基礎設施。 我現在越來越覺得,AI 自動剪片真正的最後一哩,不是剪輯,而是: 讓整套系統,真正開始用你的聲音說話。 常見問答 (FAQ)Q1:什麼是個人的 Voice Layer?Voice Layer 是放在內容工作流和底層 TTS/Voice Conversion 模型之間的一層聲音服務。它可以統一處理音色、情緒、語速、專有名詞、快取、錯誤重試與模型切換,讓影片、課程、Podcast 或 AI Agent 都用同一個介面呼叫聲音能力。 Q2:做地端克隆音一定要先買 RTX 4090 嗎?不一定。以文章中的 Prototype 情境來說,Apple Silicon Mac 的 MPS 可以先用於短影音、短旁白或課程分段音訊測試;但長音訊、批次任務和多工執行仍可能受到 16GB Unified Memory 等硬體限制,實際速度要依模型版本與設定測試。 Q3:地端 Voice Clone 和雲端 TTS 應該怎麼選?如果在意資料控制、成本可預測、切句與重試邏輯,地端比較適合做日常與 Prototype;如果需要大量生產、快速接 API 或多語言服務,雲端比較省維護成本。更彈性的做法是建立混合式 Voice Engine,依任務切換不同引擎。 Q4:克隆音怎麼避免把 Claude、Gemini 或 n8n 唸錯?可以在文字送進 TTS 前建立專有名詞發音字典,先把 Claude、Gemini、Anthropic、n8n 等詞轉成固定讀法或標記,再進行語音生成。這比每次都讓模型自行猜讀音,更容易維持影片之間的一致性。 Q5:Voice Conversion 和 TTS 有什麼差別?TTS 主要負責把文字說成語音,通常也會處理語速、情緒、停頓與表達;Voice Conversion 則是在已有語音表現的基礎上轉換音色。兩者可以拆開使用:先用擅長表達的 TTS 把話說好,再用 Voice Conversion 換成個人音色。

  • article-全民修仙時代來了:AI 給每個普通人一個重新選擇靈根的機會

    2026/9/10

    AI自動化 AI Agent Vibe Coding
    全民修仙時代來了:AI 給每個普通人一個重新選擇靈根的機會

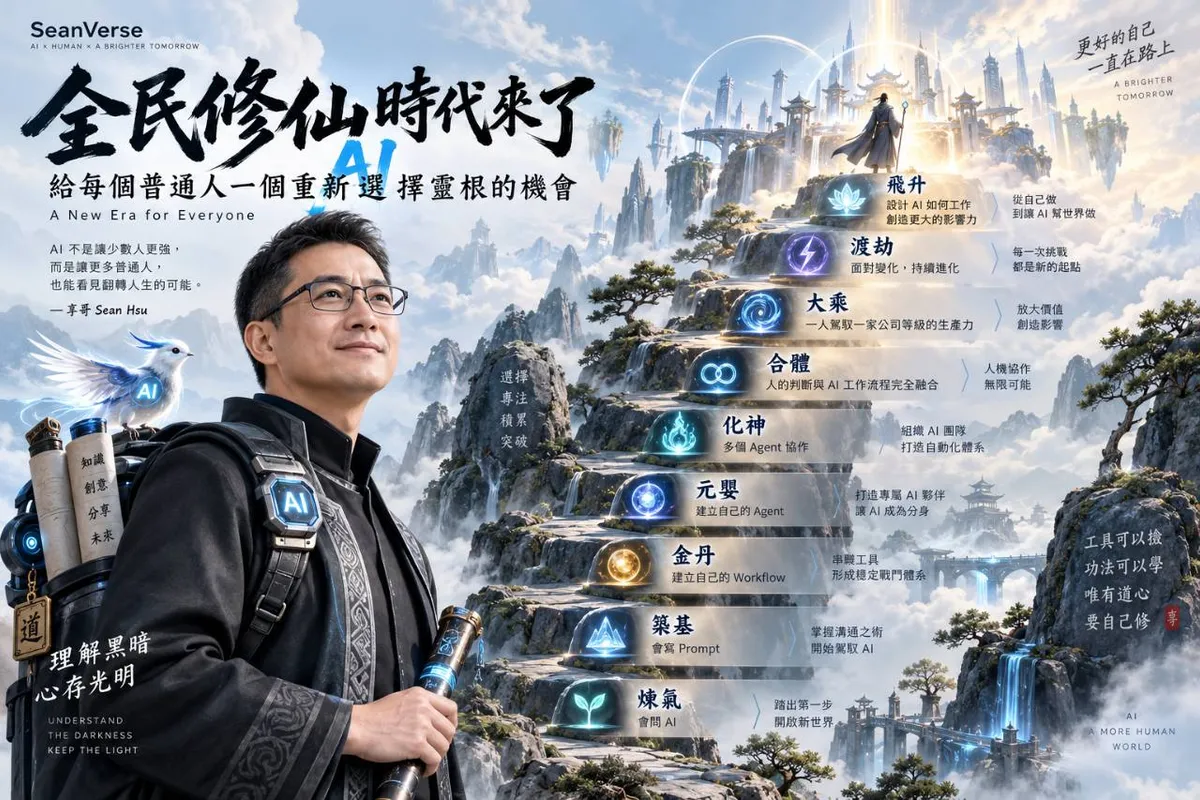
    最近看到一篇分析修仙小說的文章,裡面有個觀點讓我想了很久。 為什麼這幾年修仙小說這麼紅? 因為修仙小說賣的可能從來都不是「成仙」。 它真正賣的,是一套普通人的生存想像: 你可能沒有背景、沒有資源,甚至連靈根都很差。 但只要肯學、肯熬、找到自己的功法,再加上一點機緣,人生就還有翻盤的可能。 看到這裡,我突然發現: 這跟現在的 AI 時代,實在太像了。 以前沒有靈根,很多事情你連門都進不去以前想做一個網站,你最好會寫程式。 想做漂亮的廣告,你要懂設計。 想拍影片,你要懂腳本、攝影、剪輯。 想做音樂,你最好懂一點樂理。 想成立一家公司,你還需要行銷、業務、客服、行政等不同專業的人。 這就像傳統修仙世界。 你沒有火靈根,人家告訴你別學煉丹。 你沒有劍道天賦,就不要妄想成為劍修。 你的「出生能力值」,很大程度決定了你能做什麼。 但 AI 出現之後,一件很有趣的事情發生了: 雜靈根,也可以修仙了。 不會寫程式,可以 Vibe Coding。 不會畫圖,可以 AI 生圖。 不會剪影片,可以 AI 剪輯。 不會作曲,可以生成音樂。 不懂自動化,可以跟 AI 一起建立 Workflow。 一個普通人第一次可以用非常低的成本,同時碰觸過去需要很多年才能跨入的專業領域。 AI 並沒有讓所有人突然變成天才。 它只是讓大量原本沒有「靈根」的人,第一次拿到了進入仙門的門票。 ChatGPT 是法寶,Prompt 是符籙,Workflow 是陣法如果真的把 AI 時代翻譯成修仙世界,其實非常有趣: AI 時代 修仙世界 ChatGPT、Claude、Gemini、Codex 法寶 Prompt 符籙 Skills 功法 Token、算力與訂閱費 靈石 GitHub、YouTube 與網路知識庫 藏經閣 新模型、新平台與新技術 突然開啟的秘境 Vibe Coding 煉器 AI 內容製作 煉丹 n8n 與各種 Workflow 陣法 Agent 靈獸、傀儡,甚至是分身 這裡的工具名稱與能力會隨版本、方案和使用情境變動,所以重點不在於替某個法寶排出永久排名,而在於理解自己想解決什麼問題。 這時候再回頭看現在很多人在問的問題: 到底要學哪一個 AI? 其實就很像一個剛進仙門的弟子,每天跑去問: 師兄,哪一把劍最強? 問題可能一開始就問錯了。 真正重要的從來不是哪把劍最強,而是: 你到底修什麼道? 你想解決誰的問題? 你能不能把法寶組合成自己的方法? 如果想把這條路拉回實作,可以先從 非工程背景也能開始的 Vibe Coding 開始,再把經驗整理成 Prompt 到 Skill 的工作流。 當所有人都有法寶,法寶就不值錢了2023 年,你會使用 ChatGPT,可能還算是一種優勢。 到了今天,如果你告訴別人: 我會用 AI。 其實已經跟修仙者說: 我有一把飛劍。 差不多。 因為大家都有。 當法寶變成標準配備,真正產生差距的,就不再是「有沒有法寶」,而是: 你會不會使用? 你修的是什麼功法? 你能不能把不同法寶組合起來? 你有沒有自己的陣法? 最後能不能形成一套自己的戰鬥體系? 所以我最近越來越覺得,AI 能力其實也有自己的修仙境界。 AI 能力也有自己的修仙境界 境界 AI 能力 具體轉變 煉氣 會問 AI 開始把 AI 當成日常協作工具 築基 會寫 Prompt 能把需求與上下文說清楚 金丹 建立自己的 Workflow 把重複工作整理成穩定流程 元嬰 開始建立 Agent 讓 AI 代替自己執行一段任務 化神 讓多個 Agent 協作 組織 AI 團隊,打造自動化體系 煉虛 把專業知識封裝成 AI 系統 讓經驗變成可以重複使用的能力 合體 人的判斷與 AI 工作流程融合 人機協作成為日常工作方式 大乘 駕馭過去一家公司才有的生產力 一個人也能調度多種專業能力 渡劫 持續面對模型與環境變化 幾乎每隔一段時間就要重新適應天地靈氣 然後呢? 渡劫。 而且 AI 世界的天劫,可能每隔幾個月就來一次。 最可怕的是:你好不容易築基,全世界突然都築基了這大概是 AI 時代最殘酷,也最有趣的地方。 你花半年學會的能力,下一代模型可能直接內建。 以前很會寫 Prompt,是競爭力。 模型變聰明之後,Prompt 的門檻開始下降。 以前 AI 生圖需要研究一大堆參數,後來一句自然語言就能完成。 以前 Vibe Coding 已經讓不會寫程式的人可以做網站。 接下來 Agent 可能連需求分析、寫程式、測試、除錯、部署都自己完成。 你昨天還覺得自己終於築基成功。 一覺醒來: 天地靈氣復甦,全民築基。 所以 AI 時代真正危險的事情,不是不學新工具。 而是把某一個暫時稀缺的操作技能,誤認成自己長期的護城河。 所以 AI 時代反而更需要「修心」這也是我覺得修仙小說最有趣的地方。 修仙小說寫到最後,真正決定一個人能走多遠的,往往不是靈根,也不是手上的法寶。 而是「心性」。 因為法寶可以撿。 功法可以學。 丹藥可以買。 唯有道心,要自己修。 放到 AI 時代也是一樣。 當工具越來越強、取得成本越來越低,最後真正拉開人與人差距的,反而會重新回到一些看起來很「老派」的東西: 判斷力 審美 經驗 信用 選擇 持續學習 解決問題的能力 在還看不到成果的時候,持續累積的能力 這些東西,AI 很難直接送給你。 AI 時代,每個人都要選自己的「修仙百藝」修仙小說裡有煉丹、煉器、符籙、陣法、靈植。 不一定每個人都要成為最強劍修。 只要找到一門市場需要的能力,把它練深,一樣可以換到靈石、累積資源,甚至建立自己的勢力。 AI 時代也是如此。 有人修 AI 影片。 有人修 Vibe Coding。 有人修自動化。 有人修 Agent。 有人修 AI 行銷。 有人修 AI 教學。 有人修內容與個人品牌。 你不需要全部精通。 真正重要的是: 找到一條可以跟自己原本專業結合的「道」,然後持續修下去。 因為真正能賺錢的人,未必是每天知道最多新模型的人。 而是能把其中一門能力,修到真的可以解決別人的問題。 如果你想把「一個人駕馭多種能力」落地,也可以延伸閱讀 零人公司:不是沒人,而是沒有當下做決策的人。 AI 最大的機會,不是讓強者變得更強當然,有錢、有資源、有技術背景的人,使用 AI 一樣有巨大優勢。 世家依然是世家。 大宗門依然有更多靈石、更多算力、更多人才。 AI 並沒有突然讓世界變公平。 但它帶來了一個很重要的改變: 普通人可以用更低的成本,獲得以前根本碰不到的能力。 一個人可以寫程式。 可以做設計。 可以剪影片。 可以做行銷。 可以建立自動化。 甚至可以開始指揮一群 AI Agent 工作。 這才是我認為 AI 真正有趣的地方。 它不是讓每個人站在同一條起跑線,而是讓原本連比賽資格都沒有的人,突然拿到了一張入場券。 真正的「飛升」,可能不是更會用 AI所以如果真的要替 AI 修仙設計最後一個境界,我反而覺得不是: 我可以同時操作十個 AI。 真正的飛升應該是: 你已經不再親自操作每一個 AI,而是在設計 AI 如何工作。 你把自己的經驗變成方法。 把方法變成 Prompt。 把 Prompt 變成 Skill。 把 Skill 變成 Workflow。 把 Workflow 交給 Agent。 最後把 Agent 組成一套可以持續運作的系統。 到那個時候,你真正放大的就不是「AI 的能力」,而是你自己累積二十年的能力。 所以我現在越來越相信: AI 時代真正值得修的,從來不是 ChatGPT、Claude、Gemini 或哪一個模型。 那些都只是法寶。 真正值得修的是自己的「道」。 以前比的是誰有天賦。 後來比的是誰有工具。 當人人都有 AI,最後比的,可能又會回到誰的道更深。 AI 沒有保證普通人一定可以翻身,就像拿到一本功法,也不代表一定能飛升。 但是它至少讓這個時代多了一種可能: 沒有背景、沒有團隊、沒有頂級天賦的普通人,也能開始修仙。 現實世界沒有系統提示。 努力也不一定會顯示: 恭喜你,經驗值 +100。 但如果 AI 真的是這個時代突然出現的一場「靈氣復甦」,那麼現在真正值得問的,可能已經不是: 哪一個 AI 最強? 而是: 你的道,準備怎麼修? 常見問答 (FAQ)Q1:AI 真的能讓每個普通人都變成專業者嗎?不能。AI 主要降低的是專業領域的入場門檻,讓普通人更容易開始嘗試與製作;真正能走得長久,仍然需要判斷力、經驗、審美、信用與持續解決問題的能力。 Q2:AI 時代到底該先學哪一個工具?先從自己想解決的問題與想修的方向開始,再選擇適合的工具。ChatGPT、Claude、Gemini、Codex 或其他模型都只是法寶,工具能力也會隨版本、方案與使用情境變動。 Q3:不會寫程式的人可以從哪裡開始學 AI?可以先從能立即驗證成果的任務開始,例如用 AI 協助寫內容、做設計、剪影片、建立簡單 Workflow,或嘗試 Vibe Coding。重點不是一次學會所有工具,而是把一次任務逐步整理成可重複的方法。 Q4:如何把 AI 能力變成長期競爭力?把自己的專業經驗整理成方法,再依序沉澱成 Prompt、Skill、Workflow 與 Agent;當這些工具和你的領域知識、判斷力及信用結合,才比較可能形成不容易被下一代模型取代的工作系統。

  • article-AI 變現五階段:賣時間 → 賣知識 → 賣能力 → 賣結果 → 賣資產

    2026/9/8

    商業策略 AI自動化 AI Agent
    AI 變現五階段:賣時間 → 賣知識 → 賣能力 → 賣結果 → 賣資產

    最近很多人問我: 現在學 AI,到底可以怎麼變現? 接案?開課?做顧問?賣 Prompt?用 Vibe Coding 做 SaaS?還是弄一堆 AI Agent,包裝成「AI 員工」? 這些當然都可以。 但我最近越來越覺得,如果只是整理「100 種 AI 賺錢方法」,其實沒有太大意義。因為工具一直換、模型一直進步,今天還能單獨販售的東西,半年後可能就變成 AI 的內建功能。 真正值得研究的是: 你到底在賣什麼? 如果從這個角度來看,我認為 AI 變現其實可以分成五個階段: 賣時間 → 賣知識 → 賣能力 → 賣結果 → 賣資產 而且越往後走,你的收入就越不需要完全跟自己的時間綁在一起。 AI 變現五階段,差別在於你交付什麼 階段 你正在販售的東西 常見形式 收入與時間的關係 賣時間 親自執行的服務 接案、代做、客製專案 高度綁定個人時間 賣知識 可傳遞的方法與經驗 課程、顧問、內訓、教材 同一份經驗可以重複販售 賣能力 被軟體化的專業判斷 Prompt、Workflow、Skill、Agent、程式 開始具備複製與自動執行能力 賣結果 客戶真正想要的產出 名單、預約、內容、報告、成交 以成果而非工具作為價值單位 賣資產 長期累積的商業系統 品牌、資料、產品、流量、通路 有機會產生長期複利 這五個階段不是互相排斥的商業模式,而是一條可以逐步升級的路徑。第一階段能幫你建立現金流,後面的階段則讓每一次交付都留下可以持續使用的東西。 第一階段:賣時間,先把效率差轉成現金流這是最容易開始的 AI 變現方式。 例如: 幫客戶製作 AI 圖片 製作 AI 影片 撰寫文案 製作簡報 用 Vibe Coding 建立網站 串接自動化流程 整理資料 建立客服系統 以前一個網站可能需要做兩個禮拜。現在搭配 AI,可能兩三天就能完成。 以前剪一支影片需要幾個小時,現在 AI 可以協助處理腳本、配音、字幕、素材,甚至完成初剪。 於是你產生了一個非常大的「效率差」:市場還按照過去的價值付錢,但你的生產成本已經下降。 這其實就是現在很值得把握的一波:AI Service Arbitrage。 你利用 AI,把原本需要大量人工的服務成本壓低,再把節省下來的效率轉換成利潤或更有競爭力的報價。 問題是:你還是在賣自己的時間。 一天終究只有 24 小時。當案件變多,你會開始遇到交付上限,也一定會開始思考: 能不能不要每次都從頭做? 這個問題,就會把你帶到第二階段。 第二階段:賣知識,讓一次經驗可以重複交付當你做過十次、二十次之後,就會開始累積方法。 你會逐漸知道: 第一步應該做什麼 第二步應該問什麼 哪些地方最容易出錯 什麼 Prompt 比較有效 哪些流程可以省下時間 這時候你就可以開始販售: 課程 顧問服務 企業內訓 Workshop 教材 模板 你不再只是說: 我幫你做。 而是開始說: 我教你怎麼做。 這一步最大的改變,是同一份經驗開始可以賣很多次。你把過去在專案裡累積的做法整理成知識產品,交付的就不再只有一次性的勞動。 但它還有一個問題:你教完了,對方還是得自己做。 如果對方沒有時間、沒有經驗,或是不知道如何處理例外情況,那麼一份教材仍然不一定能直接變成成果。於是 AI 時代開始出現一個非常重要的第三階段。 第三階段:賣能力,把 Know-how 編譯成 AI 可以執行的能力這可能是我目前最看好的方向之一。 以前我們只能把 Know-how 寫成: 教材 SOP 書籍 課程 但現在開始可以把 Know-how 寫成: Prompt Workflow Skill Agent 程式 假設你很會寫廣告文案。以前你的變現方式可能是幫別人寫,或是教別人寫。 現在你可以把自己的判斷標準、文案架構、檢查流程、修改邏輯與產業經驗,全部整理成一套 Skill。 以後別人不一定需要「學會你」。他可以直接呼叫你的能力。 這是一個非常巨大的改變,因為我們第一次有機會把: 專業知識 → 編譯成 AI 可以執行的能力 例如: 房仲競品分析 Skill 短影音剪輯 Workflow AEO 分析 Agent 廣告法規檢查 Agent 行銷企劃 Skill 這些東西本質上都不只是 Prompt,而是被軟體化的專業能力。Prompt 比較像一次性的指令;Skill、Workflow 或 Agent 則可以把規則、步驟、判斷與檢查方式組合成可重複呼叫的模組。 如果想進一步理解 Prompt 與 Skill 的差異,也可以延伸閱讀:從提示詞到 Skill:5 個實務做法打造高效率 AI 自動化工作流。 當很多能力串在一起,就會開始變成 AI 系統,甚至是一間 AI 公司。 第四階段:賣結果,從工具服務走向 Outcome as a Service這一層我覺得很多人還沒有真正開始思考。 今天如果你賣的是: AI 業務 Agent,一個月 3,000 元。 客戶可能會問: 為什麼我要每個月付你 3,000 元? 但如果你說: 每帶來一個符合條件的潛在客戶,我收 500 元。 客戶思考的問題就會完全改變。他開始問的可能是: 那你一個月可以給我幾個? 這就是從 Software as a Service 慢慢往 Outcome as a Service 移動。 你不再只是販售工具,而是販售客戶真正想要的結果: 名單 預約 影片 報告 成交 流量 轉換 AI 只是你背後的生產機器。 客戶甚至不需要知道你使用的是 GPT、Claude、Gemini,還是十個 Agent。他只在乎一件事情: 結果有沒有出來? 當然,這種模式的前提是結果必須能被清楚定義、量測與驗收,雙方也要先約定交付範圍與品質標準。否則「賣結果」很容易變成責任不清的承諾。 我認為未來很多所謂的「AI 員工」,最後都會走到這一步。因為企業真正想買的從來不是 AI,企業想買的是產出。 第五階段:賣資產,讓前面的累積開始產生複利這才是我認為 AI 變現最後真正有意思的地方。 前面四層做久了,你會累積什麼? 客戶 資料 品牌 內容 SOP Skills Agents 軟體 流量 通路 Know-how 這些東西開始組合成一個不完全依賴你本人工作的商業資產。 例如你原本只是幫別人做 AI 短影音,後來把方法做成課程,再把流程寫成 Skill,接著做成自動剪輯工具。累積使用者之後,又產生大量資料與客戶。 最後你擁有的就不再只是: 我很會做 AI 影片。 而是一整套: 內容+技術+客戶+資料+品牌+產品 這時候 AI 已經不是你的商品,AI 變成公司的基礎設施。 這也是為什麼我認為,把專業知識做成軟體,會是 Vibe Coding 之後很值得關注的方向。可以延伸閱讀:Vibe Coding 下一階段:把專業知識變成軟體,產業專家就是下一代產品經理。 同一份專業,其實可以賣五次假設你很懂「AI 短影音」,同一份 Know-how 可以有五種不同的交付方式: 第一次,賣時間: 我幫你剪。 第二次,賣知識: 我教你剪。 第三次,賣能力: 我把剪輯方法做成 Skill,讓 AI 幫你剪。 第四次,賣結果: 你不用管怎麼剪,我每個月直接交付 30 支影片。 第五次,賣資產: 把整套系統變成產品、品牌、平台與客戶群。 你會發現,Know-how 從頭到尾可能根本沒有換。改變的只是你怎麼包裝它、怎麼交付它,以及價值如何被客戶理解。 這個例子中的 30 支影片,是交付形式的示意,不是對任何服務的固定承諾。真正的數量、品質與價格,仍然要依服務範圍與客戶需求定義。 如何把每一次交付,逐步變成資產?如果你現在還在第一階段,完全沒有問題。賣時間本來就是最快建立現金流的方法。重點不是跳過第一階段,而是在完成工作時,刻意留下可以累積的部分。 每做完一個案子,可以多問自己幾個問題: 這次交付裡,哪些步驟會重複出現? 哪些問題客戶每次都會問? 哪些判斷其實可以整理成規則? 哪些流程可以變成 SOP 或模板? 哪些經驗可以變成課程或 Workshop? 哪些能力可以變成 Skill、Workflow 或 Agent? 這個服務是否有機會按照成果收費? 長期下來,哪些內容、資料、客戶或通路會留下來? 你不需要一次把所有事情都做完。可以先保留一份 SOP,再把其中一個重複步驟整理成模板;接著,把模板變成 AI 可以執行的模組,最後才思考如何產品化與規模化。 如果每做一個案子,都留下其中一部分,事情就會開始不一樣。 AI 變現真正值得學的,是把勞動變成資產所以我現在看 AI 變現,已經不太看「用什麼工具」。 我反而會先問一個人: 你現在在哪一層? 你現在是不是還在接一個案子、做一次、收一次錢? 如果是,那沒有問題。第一階段本來就是最快建立現金流的方法。但完成交付後,可以多問一句: 這次交付裡,有什麼東西可以留下來? 賣時間,是今天做、今天有收入。 賣知識,是把昨天的經驗再賣一次。 賣能力,是讓 AI 開始替你執行專業。 賣結果,是把 AI 變成背後看不見的生產機器。 賣資產,則是讓前面所有累積開始產生複利。 所以如果今天有人再問我: 學 AI 到底要怎麼變現? 我的答案可能不會先叫他去學哪個工具。我會先問: 你現在有什麼能力,是市場原本就願意付錢的? 然後我們再來想,怎麼利用 AI,把這份能力從「只能賣一次」,一路變成「可以被複製、被執行、被規模化,最後成為資產」。 這可能才是 AI 變現真正值得走的路。 常見問答 (FAQ)Q1:AI 變現五階段分別是什麼?AI 變現五階段是「賣時間、賣知識、賣能力、賣結果、賣資產」。它描述的是同一份專業如何從一次性服務,逐步變成可複製的知識、可執行的 AI 能力、可驗收的成果,以及不完全依賴個人時間的商業資產。 Q2:AI 變現新手應該從哪一個階段開始?多數人可以先從賣時間開始,利用 AI 提升服務效率並建立現金流。完成數次交付後,再把重複流程整理成 SOP、教材、模板或 AI 模組,逐步往賣知識與賣能力前進。 Q3:Skill 或 Agent 和 Prompt 有什麼不同?Prompt 通常是一次性的指令;Skill 或 Agent 則能把專業規則、工作步驟、判斷標準與檢查流程組合成可重複呼叫或執行的模組。因此,Skill 與 Agent 更接近被軟體化的專業能力,而不只是更長的 Prompt。 Q4:什麼情況適合從賣工具改成賣結果?當客戶真正關心的是名單、預約、影片、報告、成交或轉換,而且這些產出可以被清楚定義、量測與驗收時,就可以思考 Outcome as a Service。此時要先與客戶約定交付範圍、品質標準與計價方式,避免把模糊期待當成結果承諾。 Q5:AI 時代所說的「賣資產」是什麼意思?賣資產是把長期累積的客戶、資料、品牌、內容、SOP、Skills、Agents、軟體、流量與通路組合成一套商業系統。這套系統即使不需要你親自參與每一個細節,也能持續支援產品、服務與收入。

  • article-AI 時代真正會被淘汰的,可能不是員工,而是「組織圖」

    2026/9/8

    商業策略 AI自動化 AI Agent
    AI 時代真正會被淘汰的,可能不是員工,而是「組織圖」

    最近看到一篇文章,標題下得很狠: 「市面上那些 AI 員工,將來多數都會是垃圾。」 文章裡有一句話讓我停下來想了很久: 「差別在於它取代的是一段流程,不是一個職稱。」 我覺得這句話,其實點出了現在很多企業導入 AI 時最大的問題。 我們嘴巴上說 AI 是全新的技術,但真正開始設計 AI 的時候,腦袋裡裝的卻還是幾十年前的公司組織圖。 公司有人資,所以做一個 AI 人資;公司有客服,所以做一個 AI 客服;公司有業務,所以做一個 AI 業務;公司有行銷,所以做一個 AI 行銷助理。 最後我們得到一間很有趣的公司:原本有十個人,現在變成一個人管理十個 AI 員工。 看起來很 AI,但仔細想想,公司的運作方式根本沒有改變。我們只是把組織圖裡面的人,換成 AI。 AI 真正取代的,可能不是職稱,而是一段流程傳統企業習慣用「職位」描述工作:客服負責回答問題、業務負責開發客戶、行政負責整理資料、行銷負責產出內容。 但客戶真正需要的,從來不是「某個職位完成自己的工作」,而是問題被解決、訂單被推進、報價被送出、客戶被妥善服務。 這中間的職位、部門與交接,很多時候只是人類在能力、時間、管理與協作都有限的情況下,發明出來的組織方式。 因此,AI 導入最值得問的問題,不一定是: 哪一個職位可以交給 AI? 而是: 哪一整段工作,可以重新設計成更短、更直接、更少交接的流程? 我們可能正在用「職缺」限制 AI今天的 AI 已經不只是聊天機器人。它可以搜尋資料、操作瀏覽器、處理文件、分析資料、寫程式、使用工具、串接 API,甚至建立完成任務所需要的小工具。 那麼問題來了:為什麼我們還要跟它說: 你是一個行銷助理,所以只負責行銷。 你是一個客服,所以只回答客戶問題。 你是一個業務,所以只負責開發客戶。 這其實很奇怪。 就像你買了一台可以挖土、搬運、測量,甚至自己規劃施工路線的機器,最後卻告訴它:「你的職稱是搬運工,所以你只能搬磚頭。」 不是 AI 不夠強,而是我們對 AI 的想像太小。我們把人類為了管理方便而設計的職缺,誤認成 AI 也必須遵守的能力邊界。 AI 導入的五個階段:從工具到 AI 原生組織如果把企業導入 AI 的路徑往前推,我會把它分成五個階段。 第一階段:AI 工具化這是大部分人現在最熟悉的階段: 幫我寫 Email。 幫我整理會議紀錄。 幫我做簡報。 幫我分析 Excel。 這個階段的 AI 是「工具」。人還是原本那個工作的人,只是完成工作的速度變快了。 它能提升個人生產力,但公司的基本分工、流程與責任邊界通常沒有改變。 第二階段:AI 職位化接下來是現在市場上很流行的: AI 客服 AI 行銷助理 AI 業務開發員 AI 人資助理 企業開始把一部分工作交給 AI,並且用人類熟悉的職稱來包裝它。這當然不是沒有價值,因為它能降低使用門檻,也容易讓組織理解「誰負責什麼」。 但如果停在這裡,我們其實只是把原本的人類組織數位化:人類客服變成 AI 客服,人類業務變成 AI 業務,舊有的交接方式與 SOP 仍然存在。 第三階段:AI 流程化真正有意思的轉變,是問題從: 哪一個工作可以交給 AI? 變成: 哪一整段流程可以交給 AI? 例如,以前客戶詢價可能要經過: 12345678910客戶填表單→ 行政整理資料→ 業務確認需求→ 查詢 CRM→ 找產品資料→ 計算價格→ 主管確認→ 製作報價→ 寄出 Email→ 三天後追蹤 如果 AI Agent 可以跨網站、CRM、Email、資料庫與內部系統工作,那麼我們為什麼還需要按照原本的十個步驟走? Agent 收到需求之後,可以自己理解問題、取得資料、計算價格、產生報價、更新 CRM、寄信,甚至安排下一次 Follow-up。這時候 AI 取代的已經不是某一個人,而是一整段工作流。 想進一步理解企業如何把不同 AI 能力組合成工作流,也可以參考企業工作自動化不只有 ChatGPT:6 大 AI 自動化能力解析。 第四階段:不是自動化流程,而是刪掉流程這可能才是未來企業 AI 導入真正拉開差距的地方。 很多企業現在談 Automation,做的事情其實是:原本有十個步驟,想辦法讓 AI 自動跑完這十個步驟。 但更值得問的是:這十個步驟真的有必要存在嗎? 為什麼需要填這張表?因為以前行政人員需要整理。 為什麼要整理成 Excel?因為主管需要查看。 為什麼主管需要查看?因為他要決定下一步。 如果 AI 能直接讀取原始資料、理解內容、做出判斷,再依照規則執行下一步,這張表還需要存在嗎? 那張表可能根本不需要存在,那份 Excel 可能不需要存在,甚至某些簽核、資料搬運與中間系統也可能不需要存在。 這時候真正省下來的,不只是「一個員工的薪水」,而是以下這些長期累積的成本: 等待與排隊 跨部門轉交 資料重打 格式轉換 跨系統搬運 重複確認與溝通 自動化是讓舊流程跑得更快;AI 原生設計則可能直接讓其中一部分流程消失。 第五階段:AI 原生組織如果繼續往前推,我甚至懷疑「AI 員工」這個詞本身都可能變得很奇怪。 真正成熟的 Agent,不一定需要固定職稱。今天它幫你研究市場,下一秒寫一支程式取得資料,接著分析資料;發現缺少工具,就自己建立工具,然後操作 CRM、更新網站、寄出 Email,再把結果整理給你。 你很難說它到底是工程師、研究員、行銷、業務,還是行政。它只是為了完成一個 Goal,動態呼叫自己需要的能力。 這也解釋了為什麼我最近越來越關注 Agent Harness。模型只是大腦,真正決定 AI 能做到多少事情的,還包括: 元件 在 AI 原生組織中的作用 Model 理解、推理與產生下一步行動 Context 提供目前任務、專案與環境所需的背景 Memory 保留可重複使用的歷史資訊與工作狀態 Skills 封裝特定領域的做法、規則與判斷方式 Tools 讓 Agent 搜尋資料、操作檔案、呼叫 API 或使用服務 Permissions 限制哪些資料與操作可以被存取 Workflow 定義任務如何拆解、串接與交接 Evaluation 驗證結果是否符合品質與安全要求 Harness 把上述能力組合成可持續執行的工作環境 因此,未來我們管理的可能不是「我有幾個 AI 員工」,而是: 為了完成這個目標,我可以調度多少模型、Skills、Tools、Memory、資料、權限與 Agent? 如果想深入了解 Skill 與 Harness 的差別,可以閱讀Skill 之後,下一個 AI 開發者一定要懂的詞:Agent Harness。 AI 導入真正該計算的 ROI:消滅多少工作我開始覺得,AI 導入真正的 ROI,不應該只算「取代多少人」,而應該算「消滅多少工作」。 這兩件事情完全不同。 一家公司可能完全沒有裁員,但原本每個月需要 500 小時的行政流程,最後只剩下 50 小時。那些人力並沒有消失,而是可以轉去做客戶關係、產品、策略、創意,以及真正需要人類判斷的事情。 這種轉變的價值,不只是節省薪資,還包括: 更短的回應時間 更少的交接錯誤 更即時的決策 更少的重複溝通 更高比例的時間投入在高價值工作 所以,評估 AI 專案時,可以把問題從「省了幾個人」改成以下幾個更接近實際營運的問題: 這段流程原本每月消耗多少工時? 有多少時間只是等待、搬運、重打與確認? AI 導入後,哪些步驟可以合併或直接刪除? 哪些決策仍然需要人類核准? 省下來的時間是否真的被轉移到更高價值的工作? 這樣算出來的 ROI,會比單純計算「少請一個人」更接近 AI Transformation 的真實價值。 重新設計公司,而不是替換組織圖上的人所以我現在反而不太想問:「我要哪一個 AI 員工?」 我會想問另外一個問題: 如果今天重新建立這家公司,而且一開始就知道 AI Agent 存在,我還會設計出現在這套組織與 SOP 嗎? 很多公司的答案可能是不會。 因為很多工作、職位與流程,其實都是過去技術限制下形成的產物。當限制改變,組織本身也應該重新設計。 可以把傳統問法改成這樣: 傳統問法 AI 原生問法 我需要哪一個 AI 員工? 我需要完成哪一個 Goal? 哪個部門負責這件事? 完成任務需要哪些資料與權限? 哪個人接手下一步? 哪個 Agent 或工具可以直接承接? 如何讓十個步驟自動執行? 哪些步驟可以合併或消失? 我有幾個 AI 員工? 我能調度多少能力來交付結果? 如果最後只是把「人類客服 → AI 客服」、「人類業務 → AI 業務」、「人類行政 → AI 行政」、「人類行銷 → AI 行銷」全部替換一次,那可能只是把舊公司的組織圖重新畫了一遍。 真正的 AI 原生企業,可能連那張組織圖都不一樣。 一人公司的下一步:建立 AI Operating System對一人公司來說,未來也不一定是一個老闆帶著十個有名字、有頭像、有職稱的 AI 員工。 更可能是:一個人擁有一套可以根據目標,動態組合模型、Agent、Skills、Tools、Memory 與工作流程的 AI Operating System。 在這種架構裡,人的角色不一定是每天親自執行所有步驟,而是: 定義想完成的目標 設計可接受的規則與權限 建立可重複使用的 Skills 決定哪些節點需要人工核准 檢查結果品質與風險 把省下來的時間投入關係、創意與決策 這和「用 AI 取代所有人」是兩件不同的事情。前者是重新設計工作的系統,後者只是把裁員當成導入 AI 的唯一答案。 結語:AI 改變的可能是公司存在的方式不要只是拿「職缺」去想像 AI,也不要只是用 AI 重現今天的公司。 真正值得思考的是: 如果 AI 的能力沒有被現在的職稱與 SOP 限制,我公司的哪些工作,甚至哪些流程,可以直接消失? 因為 AI 真正可能改變的,從來不只是某一個人的工作,而是我們過去認為「公司本來就應該這樣運作」這件事情本身。 常見問答 (FAQ)Q1:AI 員工和 AI 流程有什麼不同?AI 員工通常以人類職稱或部門為單位,模擬客服、業務或行政等角色;AI 流程則以「完成一個目標」為單位,讓 Agent 跨越多個系統與職能,直接處理一整段工作。 Q2:企業導入 AI,應該先從哪裡開始?應先盤點一段完整的端到端流程,記錄其中的交接、等待、資料重打、重複確認與人工決策,再選擇低風險、規則清楚的流程做小範圍試點,而不是先購買一個對應職稱的 AI 工具。 Q3:是不是所有流程都應該自動化?不是。導入 AI 前應先檢查每個步驟是否仍有存在必要,能合併或刪除的流程不必自動化;涉及高風險決策、法律責任、資金交易或個資的節點,仍應保留適當的權限控管與人工核准。 Q4:什麼是 AI 原生組織?AI 原生組織不是把每個人類職位各自換成一個 AI,而是以目標為中心,動態調度模型、Agent、Skills、Tools、Memory、資料、權限與工作流程來交付結果。 Q5:AI 原生組織會讓人類完全失去工作嗎?不一定。更合理的目標是消除低價值、重複與等待型工作,讓人類把時間轉向客戶關係、產品、策略、創意與需要責任判斷的任務。是否減少人力,取決於企業的策略與治理方式,不是 AI 導入的唯一衡量標準。

  • article-【AI 幫你做網站還不夠:下一代網站,應該讓 AI Agent 能直接操作】

    2026/9/7

    AI自動化 AI Agent Vibe Coding
    【AI 幫你做網站還不夠:下一代網站,應該讓 AI Agent 能直接操作】

    最近看到有人分享「MCP 網站」的概念。 他舉了一個很直覺的例子: 以前網站做好之後,想改一個標題、換一段服務說明,可能還得登入後台,甚至重新找工程師;但網站接上 MCP 之後,可以直接告訴 AI: 把首頁這段改成今年的活動內容。 AI 就能直接替你處理。 一開始我也在想: 現在 ChatGPT、Codex、Claude Code 都已經可以幫我們做網站了,那我用 AI 做出來的網站,不就算 MCP 網站嗎? 深入拆解後,我才發現這其實是兩件完全不同的事。 而且真正值得注意的,不只是 MCP。它背後其實正在浮現一種新的網站架構: Agent-native Website。 也就是網站不再只設計給「人」操作,同時也開始設計給「AI Agent」操作。 這可能會是 Vibe Coding 下一個很值得注意的發展方向。 AI 幫你做網站,不等於 MCP 網站先釐清第一個最容易混淆的地方。 假設今天我跟 ChatGPT Sites、Codex 或 Claude Code 說: 幫我做一個品牌官網。 AI 幫我完成: 首頁 商品頁 表單 後台 資料庫 部署 這叫做 AI-assisted Website Development,也就是「AI 幫我做網站」。 但網站上線之後,如果 AI 沒辦法透過標準介面去讀取、查詢、修改與操作網站,那它並不會因為是 AI 做的,就自動變成「MCP 網站」。 這兩件事情必須分開: AI 幫你建立網站≠AI 可以操作網站 前者解決的是「開發」;後者解決的是「營運」。 我反而覺得,後者可能更值得關注。 MCP 到底在網站裡扮演什麼角色?MCP 是 Model Context Protocol 的縮寫。如果用很簡化的方式理解,可以把它想成: 讓 AI Agent 知道外部系統有哪些能力,並且可以使用這些能力的一套標準介面。 傳統網站通常長這樣: 123456789使用者 ↓Browser ↓Frontend ↓Backend / API ↓Database 管理網站的人則可能走另一條路: 1234567管理者 ↓/admin ↓Backend ↓Database 所以網站其實一直都是: Human-first。 所有東西都是設計給人點的:按鈕、選單、表單、Dashboard 與 CMS。 但 MCP 加進來後,會多出另一個入口: 123456789AI Agent ↓MCP Client ↓MCP Server ↓Website Services ↓Database / CMS / API 這時候 AI 不需要像人一樣: 登入後台 → 找到文章 → 點編輯 → 修改 → 按發布。 它可能直接呼叫: 1234567get_pages()update_page()create_article()get_products()update_product()get_orders()get_analytics() 這才是 MCP 真正有意思的地方。 MCP 不是裝在網站前台這也是我一開始很容易誤解的地方。 既然叫「MCP 網站」,是不是代表要在網站裡面裝一個 MCP? 其實不應該這樣理解。比較好的架構應該是: 12345678910 ┌─ Website Frontend │Website Services ──────┼─ Admin │ ├─ REST API │ └─ MCP Server ↑ │ AI Agent Frontend 是給消費者使用。 Admin 是給管理者使用。 API 是給其他程式使用。 MCP 則是提供給 AI Agent。 所以我反而比較喜歡一個更精準的名稱: MCP-enabled Website。 因為 MCP 並不是「網站本身」,而是網站額外提供的一個 Agent Interface。 MCP 跟 API 到底差在哪裡?這也是另一個很常見的問題。 既然網站本來就有 API: 123GET /api/productsPOST /api/articlesPATCH /api/pages/123 為什麼還需要 MCP? 因為 API 主要是設計給: 程式使用。 MCP 則更進一步讓: AI Agent 理解這個系統有哪些能力,以及什麼時候該使用它。 例如原本網站有: 1GET /api/orders 可以再包裝成 Agent 容易理解的工具: 1234get_orders({ date, status}) 並且描述: 取得指定日期與狀態的網站訂單。 Agent 就比較容易知道:「當使用者問我昨天有哪些訂單時,我應該使用 get_orders。」 因此底層甚至可以完全共用同一套 Service,差別主要在於介面服務的對象不同: 1234567API ↓Program InterfaceMCP ↓Agent Interface 真正重要的其實是 Service Layer這是我研究完後,覺得 Vibe Coding 特別應該注意的一件事情。 很多人用 AI 做網站,很容易把所有商業邏輯直接寫進 UI: 12345Button ↓onClick() ↓Database 網站當然還是可以跑。 但以後想串 API、手機 App、Agent 或 MCP,就會變得很麻煩。 所以如果現在重新設計我的 Vibe Coding 網站 SOP,我會要求 Codex 或 Claude Code: 所有核心商業功能不得只存在於 UI Event Handler,必須抽象成可重複呼叫的 Service Layer,為未來 REST API、MCP Server 與 AI Agent 操作預留介面。 例如: 12345678getProducts()getOrders()getCustomers()createArticle()updateArticle()updateProduct()getAnalytics()updateHomepage() 最後變成: 123456789101112Frontend ↓ ┌────────┐Admin ─────────→│ Service│←──────── REST API │ Layer │ └────┬───┘ ↑ │ MCP ↑ │ AI Agent 這樣即使今天沒有 MCP,網站本身也已經 Agent Ready。未來要增加 MCP,就不需要把整個網站重新打掉。 如果你正在設計自己的 AI Coding 工作流,也可以延伸閱讀Skill 之後,下一個 AI 開發者一定要懂的詞:Agent Harness;它能幫助你理解 Model、Context、Tools、Skills 與權限如何組成一個可持續工作的 Agent 系統。 從 AI Website 到 Agent-native Website:五個階段我現在會把這件事情分成五個 Level。 Level 1:AI 幫你做網站12345人 ↓ChatGPT Sites / Codex / Claude Code ↓Website AI 是開發工具,網站本身仍然是傳統網站。 Level 2:AI 幫你修改網站例如: 1234567891011你 ↓Codex ↓GitHub ↓修改程式碼 ↓Commit ↓Cloudflare / Vercel 這已經很好用了,但仍然比較接近 AI Software Engineering,而不是 Agent-native Website。 Level 3:MCP-enabled Website開始讓 AI Agent 直接使用網站能力: 1234567你 ↓AI Agent ↓MCP ↓Website Services 例如: 把首頁的活動改成櫻桃季。 Agent 不一定需要修改程式碼,而是直接呼叫: 123get_campaign()update_campaign()update_homepage() 這時網站才真正開始「AI 可操作」。 Level 4:Agent-native Website這一層就更有意思了。 網站從設計第一天就同時考慮兩種使用者: Human + AI Agent。 架構可能變成: 1234567891011121314┌──────────────────────────┐│ Human Interface ││ ││ Frontend /admin │└─────────────┬────────────┘ │ Website Services │ ┌────────┼────────┐ ↓ ↓ ↓ Database API MCP ↑ │ AI Agents 這時候網站已經不只是一堆網頁,而是一組: 可以被人使用,也可以被 Agent 呼叫的商業能力。 Level 5:Self-Optimizing Website再往前一步,Agent 不只操作網站,還可以持續監測、分析、提出修改建議,並在人工核准後執行優化。 這時網站開始具備一個新的循環: 12345678910111213監測 ↓分析 ↓提出建議 ↓人工核准 ↓修改網站 ↓重新驗證 ↓持續追蹤 這條演進路線,也可以和我先前整理的 MCP、Skill 與 CLI 差異一起閱讀:前者偏向網站如何成為 Agent 可操作的系統,後者則整理 AI 工具各自扮演的角色。 Brand Agent:網站營運者不一定是人拿「鮮生小姐」來想,就會非常具體。 例如我自己的實驗專案「鮮生小姐」,未來如果把網站 Agent 化,可以提供: 12345678910get_productsupdate_productget_campaignscreate_campaignget_articlescreate_articleget_homepageupdate_homepageget_customer_inquiriesget_site_analytics 於是我不一定要登入網站後台,而是直接告訴自己的 Brand Agent: 櫻桃季快到了,幫我檢查網站有哪些內容應該更新。 Agent 可以先查詢: 1234get_productsget_campaignsget_homepageget_articles 然後告訴我: 首頁還在主推上一檔活動。 櫻桃商品頁的產季資訊需要更新。 今年還沒有建立送禮相關內容。 我再說: 幫我準備新版,但先不要發布。 Agent 建立 Draft。 我確認: OK,發布。 Agent 再透過 MCP 更新。 這時候 AI 已經不是「網站製作工具」,而是開始變成: 網站營運者。 甚至,鮮生小姐的擬人化 AI 代言人 Cherry,也可以不只是品牌角色,而是 Brand Agent。 她可以同時理解: 網站資料 訂單 商品 內容 Analytics SEO、AEO 與 GEO 接著回答: 最近櫻桃禮盒頁面的流量上升,但轉換率下降,我建議調整首頁 CTA,另外建立一篇今年櫻桃送禮指南。 這時候 IP 就開始從「虛擬代言人」進化成「可以工作的 AI 員工」。 SEO、AEO、GEO、AXO 與 MCP 如何串起來?我最近本來就在研究另一件事情:網站到底要怎麼讓 AI 更容易找到、理解、引用? 傳統網站第一層還是 SEO,例如 Title、Meta、H1-H3、Schema、內部連結與網站效能等。 接著進入 AEO/GEO,要思考的不只是排名,而是: AI 能不能理解並引用我的內容? 所以內容開始需要注意: 是否直接回答問題。 是否有明確定義。 是否標示來源、作者與更新日期。 段落能不能獨立理解。 是否有問題式標題。 是否提供比較與步驟。 是否有真正的原創經驗與案例。 再下一層則是 AXO: AI Agent 能不能理解這個網站? 最後再往下一層: AI Agent 能不能操作這個網站? 這時候 MCP 就出現了。 我開始把整套網站優化流程重新理解成: 12345678910111213141516171819Website ↓SEO讓搜尋引擎找到 ↓AEO / GEO讓 AI 理解、引用 ↓AXO讓 Agent 理解網站與能力 ↓Agent Ready整理 Service / API / 權限 ↓MCP-enabled讓 Agent 可以操作 ↓Agent Automation讓 Agent 可以持續工作 這可能會變成我以後做網站時的新 SOP。 如果想先理解 AXO 與 WebMCP 的差異,可以閱讀SEO、AEO 之後的 AXO:讓 AI Agent 真正完成網站任務。那篇文章偏向 Agent Experience 與任務完成;本文則進一步把焦點拉到網站內部的 Service、MCP 與營運治理。 Self-Optimizing Website:網站自己優化自己我原本就在規劃 AI 搜尋能見度健檢工具。 不是只給一個「GEO 72 分」,而是實際測量品牌是否被 AI 提及、是否被列為推薦選項、引用哪個頁面,以及競品出現頻率。 以前做到這裡,下一步通常是: 12345發現問題 ↓產生報告 ↓交給人修改 如果加入 Agent + MCP,流程就可能變成: 12345678910111213141516171819SEO / AEO / GEO Agent ↓掃描網站 ↓發現問題 ↓提出修改方案 ↓Human Approval ↓MCP ↓修改 Website ↓重新檢測 ↓記錄結果 ↓持續追蹤 例如 AI 發現「櫻桃送禮推薦」這個頁面被 AI 引用率偏低,就可以分析原因,建議增加: 比較表 FAQ 作者資訊 原創資料 更明確的答案段落 人工核准後,Agent 再修改網站,重新測試 ChatGPT、Gemini 或 Claude 等 AI 能見度,一個月後比較變化。 這時候網站就不只是「做好 → 上線 → 放著」,而是: 監測 → 分析 → 建議 → 修改 → 驗證 → 再優化。 MCP 很可能就是這個循環中缺少的最後一塊: Execution Layer。 Agent 權限不能全部開放當 AI 可以直接操作網站後,問題也跟著出現。 例如: 12345delete_customerrefund_orderchange_pricepublish_pagedelete_product 如果全部交給 Agent 自由操作,風險太高。 所以我認為 Agent-native Website 至少應該把權限拆成四層: 權限層級 可以做什麼 建議治理方式 Read 查詢文章、商品、訂單與流量 可讓 Agent 自動處理 Draft 建立文章草稿、活動草稿與 SEO 修改建議 可自動建立,但不直接發布 Write 修改商品、內容與首頁 視情況授權,必要時要求確認 Critical 刪除資料、退款、修改權限與重要交易 必須 Human Approval 而且所有 Agent 操作都應該留下 Audit Log: 123456Agent: SEO-AgentAction: update_pagePage: /cherry-giftReason: AEO OptimizationApproved by: SeanTime: 2026/09/07 08:30 這才會是一個真正能進企業環境的 Agent 架構。 網站後台可能會被重新定義以前 CMS 解決的是: 不會寫程式的人,怎麼修改網站? 所以我們做出了 WordPress、網站後台與 Page Builder。 但 Agent 時代開始出現另一個問題: 如果我根本不用自己操作後台呢? 我只需要說: 把今年所有過期活動整理出來。 先幫我更新成 2026 版本。 發布之前給我看。 這三頁 OK,其他先不要動。 AI 自己完成剩下的工作。 這不代表 /admin 會消失。後台仍然很重要,因為需要: 人工檢視 權限管理 Audit Log 緊急操作 資料校正 但 /admin 可能會從: 主要工作介面 慢慢變成: 管理、監督與治理介面。 真正每天工作的入口,反而可能是 AI Agent。 Vibe Coding 的下一階段,也許不是更快做網站過去兩年大家在比: 誰能更快用 AI 做出網站? 從幾天做到幾小時,再做到一句 Prompt 就能建立。 但當「建立網站」越來越便宜之後,下一個問題自然會變成: 網站做好之後,誰來經營它? 所以 Vibe Coding 下一階段可能不是: AI 幫你做網站。 而是: AI 幫你經營網站。 再下一階段甚至是: AI Agent 成為網站的一級使用者。 所以我現在會把這幾個概念清楚分開: 階段 核心能力 AI Website AI 幫你建立網站 AI-maintained Website AI 幫你修改網站 MCP-enabled Website AI 可以操作網站能力 Agent-native Website 網站從架構開始同時為 Human 與 Agent 設計 Self-Optimizing Website Agent 可以監測、分析、改善並驗證網站 這條演進路線,我覺得才是 MCP 對網站真正有趣的地方。 未來做網站,我可能不會再只問: 手機版做好了嗎? SEO 做好了嗎? AEO/GEO 做好了嗎? 還會多問兩個問題: 這個網站 Agent Ready 了嗎? 以及: 我的 AI Agent,可以安全地替我操作這個網站了嗎? 當答案是 Yes 的時候,這個網站才真正從一個「網頁集合」,開始變成一個: 可以被 AI 理解、呼叫、操作,甚至持續改善的數位商業系統。 結語:下一代網站要問的是 Agent 能不能使用我?以前我們做網站,會問: Google 搜不搜尋得到我? 後來我們開始問: ChatGPT 會不會理解並推薦我? 接下來真正重要的問題可能是: 當 AI Agent 選擇了我,它能不能順利使用我? 這就是: SEO → AEO → AXO。 從被搜尋,到被理解,再到被執行。 MCP 值得注意的地方,也不只是多了一個網站 API,而是它讓我們看見一種可能:Web 正在開始為 AI Agent 重新設計。 未來網站的競爭力,不只在於誰的介面漂亮、SEO 做得好或內容寫得完整,也可能取決於: 你的網站,準備好被 Agent 使用了嗎? 常見問答 (FAQ)Q1:AI 幫我做網站,就代表這是 MCP 網站嗎?不代表。AI 幫你建立網站屬於 AI-assisted Website Development;只有當網站提供可供 AI Agent 理解、查詢與操作的標準化介面時,才更接近 MCP-enabled Website。 Q2:MCP 和一般 API 有什麼差別?API 主要提供程式呼叫的介面;MCP 則進一步描述系統有哪些能力、工具何時適用、需要哪些參數,以及操作結果如何回傳,讓 AI Agent 更容易選擇並使用。 Q3:為什麼網站需要 Service Layer?Service Layer 能把核心商業邏輯從前端按鈕與 UI Event Handler 抽離,讓同一套能力可以被 Frontend、Admin、REST API 與 MCP 共用,降低未來擴充 Agent 操作的成本。 Q4:Agent-native Website 可以讓 AI 自由修改所有資料嗎?不建議。網站應至少區分 Read、Draft、Write 與 Critical 權限;查詢與建立草稿可以較高程度自動化,修改、發布、退款、刪除資料或變更權限等高風險操作則應保留人工核准與 Audit Log。 Q5:網站要如何開始準備 Agent-native 架構?可以先盤點使用者最常想完成的任務,再把商品、服務與限制條件整理成一致且可理解的資料,接著抽離可重複呼叫的 Service Layer,設計 API、工具描述、權限、確認與錯誤回應,最後用完整任務測試 Agent 是否真的能完成流程。

  • article-AI 時代,40 歲後最值錢的不是經驗,而是把經驗「編譯」成 AI 能執行的能力

    2026/9/6

    AI自動化 AI Agent 內容行銷
    AI 時代,40 歲後最值錢的不是經驗,而是把經驗「編譯」成 AI 能執行的能力

    最近看到一篇文章,裡面有一句話讓我想了很久: AI 愈強,40 歲以後累積的人生經驗,反而愈值錢。 我很認同,但我覺得這件事還可以再往下一層。 未來真正值錢的,可能不只是「你有多少經驗」,而是: 你能不能把自己的經驗,編譯成 AI 可以執行的能力? 做了 20 年,不代表擁有 20 年的專業我們很容易把「年資」跟「經驗」畫上等號,但其實不一定。 有人工作 20 年,只是把第一年的工作方式重複了 20 次。也有人工作 5 年,卻做過幾百個案子、碰過不同產業、失敗過很多次,也不斷修改自己的做法。 所以真正形成差距的,可能不是年齡,而是你的「判斷密度」: 你看過多少不同案例? 遇過多少種問題? 做錯過多少決定? 後來為什麼改變做法? 什麼情況下 A 有效?什麼情況下你反而會選 B? 這些東西才慢慢形成所謂的專業判斷。 AI 不必活過你的經驗,才能使用它很多人會說: AI 可以讀很多資料,但是 AI 沒有真正活過。 這句話現在沒有錯,可是我覺得不能因此太樂觀。 因為 AI 根本不需要自己活過。一個顧問做 20 年,可能服務過 500 個客戶;未來的 AI,則可能讀過大量案例、研究報告、客戶對話、論壇討論、專案紀錄與失敗經驗。 因此真正難被取代的,不應該只是「這件事情我做過」,而是: 我做過很多次之後,形成了一套別人沒有的判斷方式。 更重要的是,這套判斷有沒有辦法被留下來、被驗證,甚至被重複執行。 從經驗到 Skill:把判斷編譯成 AI 能執行的能力這是我最近研究 AI Agent、Skills、MCP 與 Agent Harness 時,愈來愈強烈的一個感覺。 以前一個專家累積很多經驗之後,大概有幾種做法:寫書、寫文章、開課或做顧問。因為我們能做的,通常就是把腦袋裡面的知識說出來。 但現在多了一條完全不同的路: 經驗 → 判斷 → Framework → SOP → Skill → Agent 這不是把文章換一個檔案格式,而是把「在什麼情況下,做什麼判斷,接著採取什麼行動」整理成可執行的結構。 先問對問題,再決定要不要用 AI例如,一家企業來找我說: 我們想導入 AI 客服。 剛接觸 AI 的人,可能第一個問題是:要用 GPT、Claude 還是 Gemini? 但如果做過很多專案,你可能第一個問題根本不是模型,而是: 每天有多少客服量? 哪些問題一直重複? 哪些回答需要查公司資料? 哪些情況涉及訂單或交易? 哪些事情 AI 絕對不能自己決定? 什麼時候必須轉真人? 問完之後,你才會判斷:這家公司需要的是 FAQ、RAG、Workflow、Agent,還是根本暫時不需要 AI。 注意一件事情:這已經不只是「經驗」了,它其實是一棵 Decision Tree。 如果我們把每一個問題、條件、判斷與下一步整理出來,就有機會先寫成 SOP,再進一步變成 Skill,最後交給 Agent 執行。原本只能存在資深顧問腦袋裡的能力,第一次開始可以被軟體化。 如果你想先了解如何把長篇提示詞整理成可重複使用的 Skill,可以參考從提示詞到 Skill:5 個實務做法打造高效率 AI 自動化工作流。 Experience Debt:專業沒有被留下來的代價我最近想到一個詞:Experience Debt,經驗債。 很多做了十幾、二十年的專業工作者,其實非常有價值,但那些價值散落在: 腦袋裡 LINE 對話裡 Email 裡 簡報裡 客戶會議裡 課堂回答裡 客戶問一個問題,你馬上知道答案;新人做錯一件事情,你一眼就知道問題在哪裡。但是如果有人問:「為什麼你知道?」你可能只能回答: 做久了就知道。 這句話其實很危險,因為它代表這套能力還沒有被結構化。 你知道,但是你的團隊不知道;你的學生不知道;甚至 AI 也不知道。AI 無法使用你沒有留下來的經驗。 所以很多 40、50 歲的專業工作者,第一件事情不一定是急著經營自媒體,而是開始把自己的腦袋數位化。 不只建立內容庫,而是建立 Judgment Library以前我們經營自媒體,很習慣建立文章庫、影片庫、素材庫與 Prompt 庫。但我覺得下一階段更重要的是: Judgment Library——判斷庫。 例如,每次做完一個案子,我們都可以留下這些句子: 大家通常以為是 A,但我後來發現其實是 B。 遇到 X 情況,我通常不建議做 Y。 如果客戶同時出現這三個條件,我會優先選擇 Z。 以前我也相信這個做法,但做過幾十次之後,我改變想法了。 這些句子看起來很普通,卻是專業人士腦袋裡最值錢的東西。因為 Google 找得到答案,AI 也可以整理知識;但是「什麼情況應該用哪一個答案」,才是真正的判斷。 一個可以持續累積的判斷紀錄格式每次完成專案後,不必寫成完整文章,先留下以下六項就足夠: 欄位 要記錄的內容 情境 當時遇到什麼問題、對象與限制? 常見假設 多數人第一時間會怎麼想? 觀察證據 哪些案例、結果或訊號改變了你的看法? 核心判斷 你最後選了什麼做法?為什麼? 適用邊界 什麼情況下這個判斷不成立? 下一步 如果再遇到類似情境,第一個要做什麼? 當這些紀錄累積到一定程度,就能看見反覆出現的條件、例外與決策順序。那時候才有機會把零散經驗整理成真正可用的 Framework。 個人品牌會從內容入口,走向可執行產品這也會改變我們經營個人品牌的方法。 以前做內容,我們會問:「今天要寫什麼?」以後可以多問三個問題: 這件事情讓我形成了什麼判斷? 這個判斷什麼時候成立,什麼時候不成立? 這個判斷能不能變成 AI 可以執行的規則? 久了以後,你累積的可能就不只是 500 篇 Facebook 文章,而是一套能力鏈: 層次 主要作用 可能形成的產品 案例庫 記錄真實情境與結果 案例資料庫 觀點庫 說明你如何理解問題 文章、影片與課程 判斷庫 說明何時採用哪個做法 決策規則 Framework 把判斷整理成可重複的方法 顧問方法論 Skill 把方法寫成 AI 可遵循的指令與檢查 可執行模組 Agent 讓 AI 使用工具、處理情境並完成工作 AI 服務 內容只是入口,Framework 是方法,Skill 是產品,Agent 則可能成為服務。 未來我們可能不是「賣知識」,而是在「出租判斷」以前專家的商業模式很簡單: 顧問:「我幫你判斷。」 講師:「我教你怎麼判斷。」 作者:「我把我的判斷寫給你。」 AI 時代開始多出第四種可能: 我把我的判斷方式封裝成 AI,讓它持續替你處理相似問題。 這代表一個人的專業能力,第一次可以從「內容產品」變成「可執行產品」。以前一本書賣的是知識,一堂課賣的是方法;未來一個 Skill 或 Agent,賣的可能是專家的判斷能力。 這不代表把所有決定都交給 AI。真正成熟的 Skill,應該同時寫清楚適用條件、禁止事項、需要查證的資料,以及什麼時候一定要交還給人處理。 從 SEO、AEO 到 Agent:讓 AI 不只引用你,也使用你這也是我覺得個人 IP 下一階段很有趣的地方。 SEO 時代,我們努力讓人搜尋到你。 AEO 時代,我們開始思考讓 AI 引用你。 Agent 時代,可能還會再往下一步:讓 AI 使用你。 不只是讓 ChatGPT 回答問題時說「某某專家曾經提出……」,而是當 AI Agent 遇到某個問題時,直接呼叫你的 Framework、Skill 或工具來完成工作。 到了那一天,衡量一個專業工作者影響力的方式,可能也會改變。除了粉絲、瀏覽與訂閱,還可能包括: 你的 Framework 被多少 Agent 使用? 你的 Skill 一天被呼叫多少次? 你的判斷模型參與了多少真實世界的決策? 這些仍是需要持續觀察的未來可能,但方向已經值得現在開始準備。 40 歲後,現在可以從哪裡開始?如果你已經累積十年、二十年的專業,不必一開始就做一個完整 Agent,可以先從以下五步開始: 每週留下一個案例。 不只記錄做了什麼,也記錄當時為什麼這樣做。 把「反直覺判斷」寫下來。 特別是大家以為 A、你卻選 B 的時刻。 補上成立條件與例外。 沒有邊界的經驗,無法安全地交給 AI 執行。 找出重複出現的判斷。 把它整理成 Framework,再寫成 SOP 或 Skill。 保留必要的人類審核。 涉及金流、個資、合約、品牌風險或重大決策時,先設定清楚的交接點。 如果你想延伸理解「專業如何被留下來並形成個人品牌資產」,可以參考AI 時代,你真正該累積的不是內容,而是「專業證據」;若想進一步理解 Agent 如何在工具與權限邊界內完成工作,也可以閱讀Skill 之後,下一個 AI 開發者一定要懂的詞:Agent Harness。 結語:把二十年的自己,編譯成 AI 可以執行的能力如果你問我:AI 愈來愈強,我們累積十年、二十年的經驗還有沒有價值? 我的答案當然是有,但我會再多補一句:不要只滿足於「我有經驗」。 因為經驗如果永遠只存在你的腦袋裡,它的延展性仍然非常有限。 真正值得做的,是開始把: 經驗變成判斷,判斷變成方法,方法變成 Skill,Skill 再變成 Agent。 以前我們花了二十年,讓自己成為一個更厲害的專家。接下來也許要開始思考另一件事:怎麼把這二十年的自己,編譯成 AI 可以執行的能力。 我覺得這才是 AI 時代,「資深」真正厲害的地方。 常見問答 (FAQ)Q1:40 歲後累積的經驗,如何轉化成 AI 時代的競爭力?關鍵不是單純累積年資,而是把案例、錯誤、選擇理由與適用邊界整理成專業判斷。當判斷能被寫成 Framework、SOP 或 Skill,就能被團隊、AI 與 Agent 重複使用。 Q2:什麼是 Experience Debt(經驗債)?Experience Debt 是指專業價值散落在個人腦袋、對話、Email、簡報與會議裡,卻沒有被整理成團隊或 AI 可理解的結構。它會讓個人知道怎麼做,但其他人無法複製,也讓 AI 無法使用這些經驗。 Q3:Judgment Library(判斷庫)和一般內容庫有什麼不同?內容庫主要保存文章、影片或知識;判斷庫則保存「什麼情況應該選哪個做法、為什麼,以及什麼時候不適用」。判斷庫的核心是條件、取捨、例外與下一步,而不只是答案本身。 Q4:要先學會 GPT、Claude 或 Gemini,才能把經驗做成 Skill 嗎?不一定。文章中的重點是先整理問題、判斷條件、禁止事項與交接邊界,再決定適合的模型或工具。若沒有清楚的方法,換模型通常只會把同樣混亂的流程交給另一個系統。 Q5:AI 可以讀過大量案例,專業人士還能靠什麼建立差異?「我做過這件事」本身不是最穩固的護城河;更有價值的是你從大量案例中形成的判斷方式,以及能清楚說明成立條件、例外與取捨的專業模型。這些內容被留下並可執行後,才有機會形成可持續的差異。

  • article-2026 數位廣告變了:兩年沒認真研究廣告,我回來一看「靠北,已經是另一個世界」

    2026/9/2

    商業策略 AI自動化 Meta Ads
    2026 數位廣告變了:兩年沒認真研究廣告,我回來一看「靠北,已經是另一個世界」

    這兩年,我把大量時間放在 AI、系統開發、自動化、內容與 SEO 上。 廣告反而真的比較少碰。 最近因為發現 GA4 居然已經可以直接串 Meta Ads、TikTok Ads 的廣告成本,我才開始回頭補這兩年的廣告更新。 結果越補越覺得: 靠北,我錯過的根本不是幾個新功能,而是整個「數位廣告怎麼玩」的底層邏輯,都快換了一輪。 先說明一下:本文提到的 Advantage+、Andromeda、AI Max、Symphony、GMV Max 等功能與名稱,會隨平台版本、帳戶、地區和方案調整。這篇文章真正想整理的,不是功能清單,而是 2026 年重新看廣告時,應該如何理解「產品、素材、資料與 AI 投放系統」之間的關係。 一、我錯過的不是幾個功能,而是廣告的底層邏輯1. 受眾設定正在退居二線以前做 Facebook 廣告,我們很愛研究受眾: 興趣怎麼切? 年齡怎麼拆? Lookalike 要幾 %? 再行銷怎麼分層? 廣告高手很大一部分的能力,是「我比別人更會找人」。 但 Meta 這兩年的方向非常明顯:你不要找了,讓 AI 找。 Advantage+ 不斷把受眾、版位、預算與素材最佳化自動化。更底層的改變,則是 Meta 在 2024 年底公開的 Andromeda——一套新的廣告推薦引擎。 簡單講,以前我們比較像是: 我先告訴 Meta 我要找誰,再讓 Meta 從裡面找可能會買的人。 現在越來越接近: 我把商品、素材與轉換資料給 Meta,讓它自己決定這個東西現在最適合給誰看。 所以我覺得,未來廣告人的核心能力,正在從 Targeting 慢慢轉成: Signal + Creative + Offer 不是你多會按受眾,而是你給演算法什麼訊號。 2. 素材不只是廣告外皮,而是 Targeting 本身以前我們會說:先選受眾,再做適合這群人的素材。 現在這兩件事情正在融合。 你拍一支「新手第一次買房最容易踩的三個坑」,跟你拍一支「資產 3,000 萬以上的人,買房最在意什麼」,演算法本身就能從內容、互動、觀看、轉換訊號中,逐漸理解這兩支素材適合誰。 換句話說:素材本身正在成為受眾訊號。 這也解釋了為什麼現在廣告越來越強調 Creative Diversification。 以前是: 一個受眾,測很多素材。 未來可能越來越像: 給系統大量不同 Angle、Hook、Persona、Format 的素材,讓 AI 自己完成「素材 × 人 × 時機」的配對。 所以素材量的重要性,比兩年前又更高了。但「素材多」不是把同一張圖片換 30 個背景,而是提出 30 個不同的市場假設。 3. AI 已經不只是幫你寫廣告文案Meta 已經可以用生成式 AI 做素材延展、尺寸調整與創意變體。Google 把 Gemini 放進廣告系統。TikTok 的 Symphony 則開始處理: 文字生成影片 圖片生成影片 商品生成影片 Avatar 配音 翻譯 從商品網址產生廣告素材 2026 年 TikTok 又推出 Symphony Agent,開始往「AI 幫你理解趨勢、想創意、找 Creator、產素材」的方向走。Google 也把 Veo 等生成能力放進廣告素材工具。 所以兩年前我們講「用 AI 幫忙做廣告」,現在比較接近:AI 本身開始成為廣告製作系統的一部分。 這差非常多。 4. Google Search Ads 也不是以前認識的 Search Ads 了以前搜尋廣告的世界很直覺: Keyword → Search Query → Ad → Landing Page 廣告人的重要工作就是關鍵字、Match Type、Negative Keyword、出價與廣告文案。 但 Google Search 本身正在 AI 化。AI Overviews、AI Mode、Lens 與多模態搜尋出現之後,「搜尋」已經不一定是一個短短的 Keyword。 Google 推出的 AI Max for Search,方向就是讓 AI 協助擴展搜尋意圖、動態調整文案與選擇 Landing Page。傳統 Dynamic Search Ads 也逐步往 AI Max 的方向遷移。 所以 Google Ads 也正在從: 我買哪些 Keyword? 慢慢走向: 我的產品、網站、素材與轉換訊號,能不能讓 AI 正確理解我要賣給誰? 這其實跟 SEO 最近發生的事情很像。若你也在處理 AI 搜尋,可以延伸閱讀「SEO 轉型攻略:AEO 與 GEO 時代的 AI 內容優化實戰指南」。 5. Performance Max 開始補黑盒子的洞我以前對 PMax 最大的不爽就是:你叫我把錢給你,然後叫我相信 AI。 到底錢花去哪裡?哪些搜尋有效?哪些素材有效?哪些受眾有效?以前真的看得很痛苦。 但這兩年 Google 一邊推 AI 自動化,一邊也在補控制權,包含: Campaign-level Negative Keywords Brand Exclusions Demographic Exclusions Search Terms Insights 更多素材與 Channel Reporting 這透露出一個有趣的方向:廣告平台不是停止自動化,而是開始研究怎麼讓人類「控制 AI」。 我覺得這才是未來廣告操作真正需要學的能力:不是跟 AI 搶方向盤,而是知道什麼時候該給 AI 開,什麼時候要把它拉回來。 6. TikTok 已經不只是買流量TikTok 這兩年也非常值得重新研究。 Smart+ 越來越像 TikTok 版的 Advantage+ 或 Performance Max,系統幫你處理受眾、版位、素材與最佳化。TikTok Shop 又有 GMV Max;到了 2026 年,甚至出現 Agentic Hub,可以透過 AI Skills 協助建立、管理、分析與最佳化廣告。 這件事情最值得注意的不是功能名稱,而是三大廣告平台最後居然走向同一條路: 平台 自動化產品方向 系統期待你提供的東西 Meta Advantage+、Andromeda 商業目標、素材、商品與轉換資料 Google Performance Max、AI Max 產品、網站、素材與轉換訊號 TikTok Smart+、GMV Max、Agentic Hub 商品、內容、目標與成效資料 名字不同,方向幾乎一樣:你給我商業目標、素材、產品與資料,剩下讓 AI 幫你跑。 7. 平台從流量最佳化走向商業結果最佳化以前我們餵平台的是 Click、Lead、Purchase。 現在越來越多平台想知道:這個客戶值多少錢?是不是新客?是不是高價值客戶?這筆轉換到底是不是廣告帶來的增量? Meta 開始往 Incremental Attribution 發展;Google 則持續往 Conversion Value、New Customer Acquisition 與 Value-based Bidding 發展。 廣告平台真正想學的,已經不只是「誰會買」,而是: 我應該把有限的廣告預算,花在哪一個人身上,才能替企業增加最多真正的商業價值? 這是完全不同的問題。 8. 歸因終於開始承認大家都有問題廣告產業最荒謬的一件事情就是: Meta 說這個訂單是我的。 Google 說也是我的。 TikTok 可能也說有我的功勞。 每一個平台的 ROAS 都很好看。全部加起來,公司應該賺爛了。 財報打開:咦? 所以當我看到 GA4 開始可以直接把 Meta、TikTok、Pinterest、Reddit、Snap 的 Cost、Clicks、Impressions 拉進來時,覺得特別有意思。 這不能解決所有 Attribution 問題,但是方向很重要:我們終於開始從「平台說自己多厲害」,走向「把大家放到同一個 Measurement Framework 裡比較」。 這時候以前大家懶得管的 UTM、CAPI、Enhanced Conversions、First-party Data 與 CRM Data,重要性全部跑出來了。 9. 廣告操作員的價值正在重新定義把這兩年的東西補完之後,我最大的感覺反而不是「AI 好厲害」,而是以前很多我們認為叫做「廣告技術」的東西,正在快速商品化: 切受眾 調版位 分預算 調 Bid 產文案 Resize 素材 甚至產影片 這些事情 AI 都越來越能做。 所以如果一個廣告人的價值只剩「我很熟 Ads Manager」,未來會非常危險,因為平台自己正在努力消滅這些操作。 反而真正越來越值錢的能力是: 你知不知道客戶為什麼買? 你能不能設計 Offer? 你能不能找到不同的 Creative Angle? 你能不能建立正確的 Conversion Signal? 你能不能判斷平台說的 ROAS 到底是不是真的? 你能不能把廣告、CRM、網站、營收與 LTV 串在一起? 如果要用一句話總結這兩年廣告發生什麼: 廣告正在從「人操作平台」,進入「人提供策略與訊號,AI 操作平台」的時代。 二、2026 年重新學 Meta Ads:以前教的哪些東西已經退居二線?前一節談的是整個數位廣告產業的方向,這一節把焦點縮回 Meta Ads,重新檢查以前那些很熟悉的操作觀念。 1. 興趣受眾沒死,但已經不是主角以前投廣告,很大一部分時間都花在猜「我的客戶對什麼有興趣?」 賣健身課程,就切健身、減脂、重訓、蛋白粉;賣行銷課程,就切數位行銷、創業、Facebook Marketing,然後一直拆 Ad Set。 以前這叫精準,現在有時候反而是在限制演算法。 Meta 手上有瀏覽、觀看、停留、互動、點擊、購買與轉換等大量行為訊號,再加上 Advantage+ Audience。現在比較合理的思維是:把受眾設定當成提示,而不是答案。 你可以告訴 Meta「我覺得這群人可能會買」,但不要再執著「只有這群人才會買」。 2. Lookalike 還活著,但地位下降了上傳顧客名單、建立 1% Lookalike,再建立 2%、3%、5%,這套方法到現在當然還能用,Custom Audience 也沒有消失。 但它已經從核心 Targeting 武器,慢慢變成演算法的其中一個 Signal。 真正重要的問題不再只是「我的 Lookalike 幾 %」,而是「我拿什麼資料給 Meta?」 100 個亂七八糟的 Lead,跟 100 個真的成交、甚至高 LTV 的客戶,都是 100 筆資料,但價值完全不同。 3. 超細受眾切割,很多時候真的可以放下了以前一個 Campaign 裡可能有:男性 25–34、男性 35–44、女性 25–34、興趣 A、興趣 B、Lookalike,Retargeting 再各自分層。最後 Ads Manager 看起來超級專業,二十幾個 Ad Set 排得整整齊齊。 現在回頭看,很多時候其實只是把資料切碎:每一組都只有一點預算,每一組都沒有足夠 Conversion Signal,每一組都在重新學習。 結果不是幫 Meta,而是在妨礙 Meta。 我的理解會偏向:能合併,就不要為了「看起來很會投廣告」硬拆。尤其預算不大的帳號更是如此。 4. ABO 與 CBO 還能討論,但不是最值得吵的問題ABO 與 CBO 到現在仍有各自的使用情境。如果要做比較受控的測試,我可能還是會想控制預算;但如果目標是「我有 10 萬元,幫我找到最多轉換」,越來越多決策本來就會交給演算法。 所以我現在反而會問:你為什麼要控制這筆預算? 如果答案只是「因為我以前都這樣投」,那就值得重新思考。 5. 廣泛受眾從偷懶投法變成正常策略以前如果跟客戶說「我受眾沒設什麼,直接 Broad」,客戶可能會想:那我找你幹嘛? 現在 Broad 反而越來越合理,因為 Broad 不代表 Meta 隨機亂撒。真正的 Targeting 發生在你看不到的地方:系統會根據素材、轉換事件、歷史資料、網站訊號、帳號行為與預測模型,持續決定下一次 Impression 應該給誰。 所以 Broad 真正的意思不是「我沒有 Targeting」,而是「我把 Targeting 的一部分交給模型」。 6. 素材測試重要性不減反增看到 Advantage+、Andromeda 與 AI 自動化,最容易得到的錯誤結論是:「那以後什麼都給 AI 就好了。」 完全相反。 當 Targeting 越自動化,Creative 的重要性反而越高。因為你可以控制的變數正在減少,真正可以製造差異的地方變成: Hook、Angle、Offer、Persona、Pain Point、Visual、Format、Story。 一支影片講「AI 可以幫你省時間」,另一支講「每天加班兩小時的人,其實都在做 AI 可以完成的事情」。產品一樣、受眾可能一樣,但後者本身就帶著完全不同的受眾訊號。 我現在會把素材理解成: Creative is Targeting. 素材不只是拿來吸引人的,它本身就在告訴演算法「什麼人會對這個訊息有反應」。如果你正在建立短影音素材系統,也可以參考建立你的短影音定位策略:用對內容才會被看見。 7. 一支神素材打天下,這個觀念反而更危險以前很愛找 Winning Creative。找到一支 ROAS 很高的,就複製、加預算、繼續操,操到死為止。 現在這個概念需要升級。不是 Winning Creative 不重要,而是演算法越強、素材生成成本越低之後,真正重要的開始變成 Creative Portfolio。 你需要的不是 20 支長得差不多的影片,而是: 不同 Persona 不同 Pain Point 不同 Hook 不同 Offer 不同使用情境 不同證據 不同敘事方式 「素材多」不是叫 AI 把同一張圖片換 30 個背景,那只是 30 個檔案,不是 30 個 Creative Concepts。 8. Pixel 沒有死,但只裝 Pixel 已經不夠了以前網站裝 Pixel,看到 Purchase 有回傳,大家就覺得好了。 現在如果真的重視廣告成效,就不能只想 Browser-side Tracking。瀏覽器限制、Cookie、iOS、Ad Blocker 與 Consent 都可能讓資料流失。 因此 Pixel 加上 Conversions API,已經是更完整的思考方式:一邊從 Browser 傳,一邊從 Server 傳,再透過 Event ID 等機制處理 Deduplication。 這背後真正重要的不是 CAPI 這三個字,而是 First-party Data Infrastructure:你的網站、CRM、會員、訂單與 Server,能不能把真正有價值的商業結果回傳給廣告系統? 這會直接影響 AI 最後學到什麼。 9. Purchase 也不是最終答案假設 A 客人買 399 元,B 客人買 30,000 元,C 客人第一次買 1,000 元但未來一年買 100,000 元。 如果三個人在廣告系統裡都只是 Purchase = 1,其實就丟掉了很多商業資訊。 所以更值得研究的是: Conversion Value Customer Value New Customer LTV Offline Conversion CRM Signal 這也是為什麼我覺得,廣告技術正在慢慢變成資料工程問題。 10. ROAS 不要完全相信平台自己講的Meta 說「這個人看過我的廣告,所以這筆訂單算我的」;Google 說「他搜尋之前點過我,所以也是我的」;其他平台也可能說自己曾經出現過。 最後 Meta ROAS 6、Google ROAS 8、TikTok ROAS 4,全部加起來公司應該準備上市。財報卻只會問:「你們到底在供三小?」 所以現在更需要在意 Incrementality,也就是: 如果我沒有投這筆廣告,這筆訂單還會不會發生? 這和 Attribution 是兩個不同問題: 問題 它想知道什麼? Attribution 這筆訂單算誰的? Incrementality 沒有這個廣告,這筆訂單還存在嗎? 後面這個問題,其實更接近老闆真正想知道的事情。若要先從行銷漏斗整理問題,可以延伸閱讀用 ChatGPT 解剖你的行銷漏斗,找出真正的痛點。 11. Retargeting 還有用,但不要把它想成魔法以前 Funnel 很漂亮: Cold Audience → Warm Audience → Retargeting → Purchase 所以我們會建立看過影片 25%、互動過粉專、網站訪客 30 天、Add to Cart 14 天、Checkout 7 天,然後每一層都建一個 Ad Set。 這套方法不是完全不能用,而是今天 Meta 本身已經能跨大量 Signal 做最佳化,很多帳號未必還需要切成這麼漂亮的「漏斗藝術品」。 真正要問的是:這個切割有沒有產生額外價值?而不是「因為 Funnel 教科書長這樣」。 12. 廣告投手到底還剩下什麼?Targeting、Placement、Bidding、Budget Allocation、Creative Variation、Copy,甚至圖片與影片,都越來越能交給 AI。 但真正的廣告高手反而會更值錢,只是值錢的地方換了。 以前我們賣的是平台操作能力;未來真正值錢的可能是商業判斷能力: 你知不知道誰會買? 你知不知道他為什麼買? 你知不知道真正的競爭對手是誰? 你能不能設計更好的 Offer? 你能不能做出 10 個真正不同的 Creative Angle? 你知不知道該回傳什麼 Conversion Signal? 你知不知道平台的 ROAS 有沒有在唬爛你? 你能不能把 Ads、Website、CRM、Revenue、LTV 接起來? 2026 年重新學 Meta Ads,第一堂課我可能不會先打開 Ads Manager,而是先講:不要再把 Meta Ads 當成一個廣告投放工具,它現在比較像是一個大型 AI 推薦系統。 你的工作不是一筆一筆告訴它「廣告要給誰看」,而是設計一個系統,持續給它好的產品、好的 Offer、好的 Creative、好的 Conversion Data 與好的 Business Signal。 三、如果重新投 Meta 廣告,我不會再建立一堆廣告組合知道 Meta 廣告變了之後,下一個問題一定是:如果今天真的拿錢出來投,到底要怎麼投? 假設網站、Pixel、CAPI 都準備好了,也有基本的購買資料,我分別拿每天 1,000 元、3,000 元與 10,000 元重新投一次 Meta Ads,會怎麼做? 先講最大的原則:2026 年,我會比以前更努力讓帳戶變簡單。 不是因為我懶,而是現在真正需要複雜的地方,已經從 Campaign Structure 移到 Creative、Offer 與 Data 了。 每天 1,000 元:拜託不要切了以前可能會忍不住建立興趣一組、Broad 一組、Lookalike 一組、Retargeting 一組,每組再塞三支素材。 看起來超級專業,但你一天只有 1,000 元,切四組之後每組 250 元,還期待 Meta 幫你學出什麼東西。 這有點像給四個業務員每人 250 元,叫他們出去開發市場,晚上再開會檢討誰比較強。 如果是我現在做,反而會非常單純: 一個主要 Sales Campaign 受眾盡量 Broad 最佳化真正想要的 Conversion 把大部分精神放到 Creative 素材可以準備痛點型、利益型、故事型、見證型、比較型、UGC 型與 Demo 型,搭配不同 Hook。 不是建立八個 Ad Set,而是建立八個不同的說服理由。 因為一天只有 1,000 元,我最怕的不是 Meta 找錯人,而是根本沒有足夠資料讓它學。 每天 3,000 元:開始建立 Creative System到了這個預算,我才會開始增加一些結構,但不是為了把受眾切得更細,而是為了回答不同問題。 例如: 主要 Campaign 負責 Scale 另外保留一小部分預算,專門做 Creative Testing 這兩個目的完全不同。 Scale Campaign 問的是「現在誰最能替我賺錢?」;Creative Testing 問的是「下一個可以替我賺錢的素材是什麼?」 很多人把這兩件事情混在一起,所以每次看到某支素材花不到錢,就說「Meta 不公平,它根本沒有測!」 其實 Meta 本來就沒有義務公平。它的工作不是當科展評審,而是替你的預算找最大機率的結果。 所以如果真的需要理解 Hook A 和 Hook B 到底誰比較強,我會另外設計測試,不會期待 Delivery System 自己幫我完成科學實驗。 每天 10,000 元:開始在意 Creative Research System一天 10,000 元,一個月大概就是 30 萬。這時候我在意的已經不是 Campaign 數量,而是我們每週可以提出多少個不同的市場假設。 同一個產品,可能有不同的 Persona: 老闆買,是為了省人力。 行銷買,是為了提高產能。 業務買,是為了多成交。 員工買,是為了不要加班。 主管買,是為了管理效率。 五個 Persona,就可能有五套完全不同的 Creative Angle。 再往下拆,也可能有怕麻煩、怕浪費錢、怕學不會、怕被淘汰、想賺更多、想省時間等不同 Motivation。 這時候素材已經不是「設計部幫我做幾張 Banner」,而是一套 Creative Research System。 一個 Ad Set 放幾支素材,不如先問它們有沒有真的不同三支、五支、八支都不是固定答案。我會先問:這五支到底有沒有真的不一樣? 如果只是同一個文案、同一個商品、同一個賣點,換五張背景,對人類來說有五個檔案,對市場來說可能只有一個 Idea。 真正有意義的五個 Creative,可以是: Creative 說服角度 A 用了之後可以得到什麼? B 不用會損失什麼? C 別人用了得到什麼? D 為什麼以前的方法錯了? E 直接 Demo 給你看。 我甚至會建立一張 Creative Matrix。 橫軸放 Persona,縱軸放 Pain Point、Desire、Objection、Use Case 與 Proof,然後開始組合:老闆 × Pain Point、老闆 × Proof、新手 × Objection、專業人士 × Use Case。 再搭配短影音、UGC、圖片、輪播、Demo 與 Testimonial,素材就不只是「這週要交五支影片」,而是「這週要驗證五個市場假設」。 這個差別非常大。 Conversion Signal 才是很多廣告課講太少的地方假設今天兩家公司都花 30 萬廣告費,Creative 差不多,產品也差不多。 第一家公司只告訴 Meta:有人 Purchase。 第二家公司告訴 Meta:Purchase、Purchase Value、新客戶、高價值客戶、CRM 成交、Offline Conversion,甚至後續 Customer Value。 長期下來,哪一個 AI 比較有機會找到真正值錢的人?答案其實很直覺。 所以我現在會把 Pixel、CAPI、CRM、GA4、UTM 與訂單資料全部當成廣告系統的一部分,不是報表做漂亮而已。因為這些資料最後都可能影響 AI 到底學到了什麼。 不只看 Ads Manager,要建立三層成效判斷Ads Manager 當然還是看,但我不會只看 Ads Manager,至少會拆成三層: 層級 指標範例 用途 Platform Metrics CPM、CTR、CPC、CPA、Platform ROAS 操作廣告與找出異常 Analytics Metrics GA4 Conversion、Revenue、Source / Medium、跨渠道成本 比較不同渠道 Business Metrics 真實訂單、毛利、新客成本、回購、LTV、總營收 判斷企業真正結果 這三層數字一定不會完全一樣,沒關係。重點是你知不知道為什麼不一樣。 ROAS 不是最後答案,尤其當預算開始變大假設廣告 A 的 ROAS 是 8,廣告 B 的 ROAS 是 4,以前很簡單:A 勝,預算加 A。 但是如果 A 全部都是本來就會買的老客戶,B 帶進來大量第一次購買的新客戶,而且這些新客戶一年平均會再買三次,那誰比較值錢?突然就不一定了。 所以預算越大,我會越想知道: New Customer CAC Contribution Margin LTV Incrementality 而不只是 Ads Manager 裡面那個漂亮的 ROAS。 Retargeting 要不要另外開?看商業邏輯答案不是一定要,也不是一定不要。 以前 Cold、Warm、Hot 一定要切,現在我不會為了讓 Funnel 看起來漂亮,硬拆一個每天只有幾百人的 Retargeting Audience。 但如果今天有特殊 Offer、棄單優惠、高客單商品、Lead Nurturing 或特定 Customer Journey,我還是可能拆。 原則只有一個:因為商業邏輯需要,所以拆;不是因為老師以前說 Funnel 要三層。 四、把 Meta Ads 看成一個 Learning Loop如果要我畫 2026 年 Meta Ads 的架構,我現在腦袋裡大概會長這樣: Market → Offer → Creative System → Meta AI Delivery → Website / Landing Page → Pixel + CAPI → CRM / Order Data → GA4 / Measurement → Revenue / LTV → 把好的 Signal 餵回去 它已經不只是一個廣告 Campaign,而是一個 Learning Loop。 你的產品與素材,教 Meta 哪些人可能有興趣;使用者的行為,教 Meta 哪些人可能會轉換;訂單與 CRM,再告訴 Meta 哪些轉換其實比較值錢。下一輪,AI 再重新分配曝光。 所以我現在越來越覺得,2026 年真正厲害的廣告人,不一定是 Ads Manager 裡面按得最快的人,而是那個可以把: 市場 → 素材 → 廣告 → 網站 → 資料 → 營收 → AI 全部串成一個循環的人。 以前我們叫這件事情「投廣告」,現在回頭看,它其實越來越像在訓練一套替公司找客戶的 AI 系統。 結語:工具變複雜,行銷核心反而變簡單兩年沒看廣告,回來一次補完,突然覺得還滿有趣的。 因為繞了一大圈,當平台把 Targeting、Bidding、Placement 與 Creative Production 全部慢慢自動化之後,最後真正拉開差距的,居然又回到最古老的那些問題: 你賣什麼? 你賣給誰? 他為什麼要買? 你要用什麼角度說服他? 工具變得非常複雜,但行銷的核心,好像反而又變簡單了。 常見問答 (FAQ)Q1:2026 年投 Meta Ads,還需要設定興趣受眾與 Lookalike 嗎?可以使用,但不必再把它們當成唯一答案。興趣受眾與 Lookalike 比較適合被視為提供給模型的提示或訊號;實際成效仍會受到素材、轉換事件、網站資料、Offer 與帳戶歷史學習影響。 Q2:每天只有 1,000 元的 Meta 廣告預算,應該怎麼開始?建議先維持一個主要 Sales Campaign,受眾盡量 Broad,最佳化真正想要的 Conversion,並把主要精力放在測試不同的 Creative Angle、Hook 與說服理由,避免把有限預算切成太多 Ad Set。 Q3:Pixel 與 Conversions API 有什麼差別?Pixel 主要從瀏覽器端回傳事件,Conversions API 則從伺服器端回傳事件。兩者搭配並使用 Event ID 做 Deduplication,可以建立較完整的轉換資料回傳,但仍需同步處理 Consent、資料品質與事件設計。 Q4:為什麼不能只看 Meta Ads Manager 的 ROAS?平台 ROAS 是依照平台自己的歸因規則計算,可能和 GA4、真實訂單、毛利、新客成本與 LTV 不一致。更完整的判斷方式,是同時比較 Platform Metrics、Analytics Metrics 與 Business Metrics,並進一步觀察 Incrementality。 Q5:素材測試和廣告放量應該放在同一個 Campaign 嗎?不一定。放量 Campaign 的任務是替目前預算找最大機率的結果;Creative Testing 的任務是回答下一個有效素材或市場假設是什麼。如果需要比較 Hook、Angle 或 Persona,最好設計相對獨立的測試,避免期待投放系統自動完成公平的科學實驗。
  • article-學 AI 影片,你最不該做的,可能是先去學怎麼當導演

    2026/8/30

    AI自動化 AI工具 影音行銷
    學 AI 影片,你最不該做的,可能是先去學怎麼當導演

    最近 AI 影片越來越強。 Seedance、Google Flow、Veo 這些工具出現之後,我發現一個很有趣的現象:很多人在學 AI 影片時,第一個反應竟然是—— 我要不要先學攝影? 我要不要學分鏡? 我要不要學景別與運鏡? 我要不要先去上導演課? 但我最近反而越來越覺得:如果你的目標是做 AI 短影音,最不需要做的事情,可能就是先把自己訓練成一個導演。 這不是因為導演不重要。恰恰相反,是因為導演本身是一門太專業、太完整的工作。 本文提到的 Seedance、Google Flow、Veo 與其他 AI 工具,是用來說明這個工作觀念的例子,不是永久性的工具排名。實際功能與品質仍會隨模型版本、方案與使用情境變動;真正值得留下來的,是你如何定義目標、判斷結果,以及指揮 AI 把作品完成。 先別急著把自己訓練成導演傳統影視教育有一套完整的知識體系:構圖、景別、鏡頭語言、燈光、場面調度、攝影機運動、剪輯、聲音與敘事。 這些知識當然都有價值。問題是:你真的需要全部學會,才有資格做 AI 影片嗎? 想想看,有了 Vibe Coding,你不需要先花一年把 Python、JavaScript、資料庫、前後端全部學完,才有資格請 AI 幫你做網站。 有了 Suno,你也不需要先學會和弦、編曲與完整樂理,才有資格做一首歌。 有了生成式 AI,你同樣不用先念完設計系,學完色彩學、排版與構圖,才能做一張社群圖片。 同樣的事情,正在發生在影片領域。 所以 AI 影片真正值得研究的問題,不是: 我要怎麼成為導演? 而是: 我要怎麼讓 AI 成為我的導演? 這個差別會改變你的學習順序。你不必先把所有專業技能都收集完,才開始創作;你應該先知道自己要達成什麼結果,再學會如何讓 AI 提出方案,最後判斷哪個方案值得留下。 導演知識仍然重要,但不必一次學完整套「不必先成為導演」很容易被誤解成「什麼都不用懂」。我認為也不是。 這就跟 Vibe Coding 一樣。真正厲害的人,不一定需要自己寫完每一行程式碼,但他通常看得出來 AI 哪裡寫得不好、哪裡不符合需求、哪裡可能造成風險。 AI 影片也是如此。你不一定要親自拍攝或操作攝影機,但最好能判斷: 為什麼這顆鏡頭沒有壓迫感? 為什麼人物看起來很假? 為什麼這個轉場的 AI 味很重? 為什麼角色明明沒有改變,下一個鏡頭卻像換了一個人? 為什麼故事此處應該緊張,觀眾看了卻完全沒有感覺? 你需要的不是完整的導演專業,而是足以看懂與驗收影片的基本素養。 AI Video Literacy 是什麼?我會把這種能力稱為 AI Video Literacy,也就是 AI 影片素養。 它不要求你親自完成所有拍攝工作,而是要求你能在 AI 參與製作時完成四件事: 能力 你需要做的事 看懂 看出畫面、節奏、角色與情緒是否符合預期。 判斷 分辨產出是有效解法,還是只是看起來很華麗。 指揮 把觀眾、情緒、故事與商業目標交代給 AI。 修正 找出失敗原因,提出下一輪更具體的調整。 這四件事比背熟多少個運鏡名詞,更接近 AI 時代的影片工作。 Prompt 應該從控制攝影機,轉向描述觀眾意圖以前我們寫 AI 影片提示詞,很容易寫成一張施工圖: 35mm 鏡頭,低機位,攝影機向右環繞,人物往左走兩步,鏡頭慢慢推近,接著快速切換特寫。 這種寫法並沒有錯。當你需要精準控制畫面、維持角色連貫,或模型還無法理解抽象指令時,具體的視覺描述仍然有用。 但如果模型本身已經越來越懂攝影、構圖與運鏡,另一種 Prompt 會變得更重要:不要只告訴 AI 攝影機怎麼動,也要告訴 AI 你希望觀眾感受到什麼。 例如: 前三秒必須讓觀眾感覺事情不太對勁。 人物表面非常有自信,但觀眾要比角色更早發現危險。 這一段需要逐漸增加壓迫感,最後兩秒突然反轉。 接下來才讓 AI 思考:要用低機位、推鏡、手持、快速切鏡、特寫,還是完全不同的方法? 這是一個重要轉變:從控制畫面,變成描述意圖。 好的 AI 影片工作流,不是永遠只用抽象描述,也不是把每一個畫面細節都寫死,而是先說清楚結果,再依照模型與任務需要補上視覺限制。順序可以是: 先定義觀眾與商業目標。 再描述希望觀眾產生的情緒與行動。 請 AI 提出腳本、分鏡與視覺方案。 人再挑選、修改並補充必要的攝影細節。 短影音的基本單位,可能已經不是鏡頭,而是注意力如果你今天做的是電影,當然可以研究電影導演;但如果你做的是 TikTok、Reels 或 Shorts,我反而會建議你多研究短影音創作者。 因為兩者面對的是完全不同的戰場。 電影導演思考的是: 這個故事怎麼說最好? 短影音創作者第一個問題卻是: 怎樣讓他不要滑走? 電影可以用五分鐘鋪陳一個角色,短影音可能連五秒都沒有。你的觀眾正躺在床上,一隻手拿著手機;上一支是美女,下一支是貓,再下一支是搞笑影片,而你的作品夾在中間。 他沒有義務理解你的藝術理念,甚至沒有義務給你十秒。 因此,短影音真正的基本單位,可能已經不是「鏡頭」,而是注意力。 我甚至會把「分鏡設計」重新稱為「注意力設計」。一支 30 秒短影音可以先用這樣的方式規劃: 時間 注意力任務 0–2 秒 停滑:讓觀眾立刻感覺有事情值得看。 2–5 秒 建立問題:讓觀眾知道自己為什麼要繼續看。 5–10 秒 第一次刺激:提供新的資訊、畫面或情緒變化。 10–18 秒 衝突升級:讓問題變得更難、更急或更意外。 18–25 秒 答案/反轉:回收前面的期待,或重新定義問題。 25–30 秒 高潮/CTA:把情緒推到最高點,再引導下一個行動。 這不是保證每支影片都有效的公式,而是一個讓你在安排鏡頭之前,先安排觀眾注意力的思考框架。 當你這樣看影片,景別、構圖與運鏡就會回到正確的位置:它們是工具,不是目的。真正的目的,是讓觀眾接下來三秒仍然想看。 如果你還在建立短影音的受眾與內容定位,也可以延伸閱讀本站的〈建立你的短影音定位策略:用對內容才會被看見〉,先把「誰會看」與「為什麼值得看」想清楚。 用五層能力,重新設計 AI 影片學習路徑如果要重新設計一套 AI 影片學習方法,我會把它拆成五層。這五層不是線性課綱,而是每一次製作都可以回頭檢查的順序。 1. Audience:誰會看?先不要急著問「要用哪個工具」,先問: 這支影片是給誰看的? 他現在處於什麼情境? 他為什麼會在這一秒停下來? 他看完之後,應該產生什麼理解或行動? 受眾不是影片完成後才拿來解釋成效的名詞,而是生成腳本與畫面之前的輸入條件。沒有受眾,AI 很容易做出所有人都看得懂、卻沒有人特別想看的內容。 2. Emotion:你要讓他感受到什麼?接著要決定主要情緒:好奇、害怕、爽、笑、驚訝、感動,或是其他更精準的感受。 情緒不是在 Prompt 裡塞幾個形容詞就完成了。你要知道情緒如何逐步發生:開頭先讓觀眾不安,中段讓他以為自己猜到了答案,最後再透過反轉改變理解。這些情緒變化,才是 AI 需要協助你設計的內容。 3. Story:怎麼讓人想知道結局?一支短影音不一定要有複雜劇情,但通常需要清楚的注意力路徑: Hook → 衝突 → 升級 → 反轉 → Payoff 這裡的 Hook 不只是第一句台詞或第一個畫面,而是觀眾願意繼續看下去的理由。衝突讓問題成立,升級讓觀眾不能太早離開,反轉重新安排理解,Payoff 則回收前面的期待。 如果故事本身沒有讓人想知道結局,再漂亮的 AI 畫面也可能只是短暫的視覺展示。 4. Visual:現在才讓 AI 規劃畫面到了這一層,才開始處理場景、角色、構圖、景別、運鏡、光影與視覺效果。 這時候導演知識就會變得很有用,但它的角色是「幫你判斷與溝通」,而不是一道必須先修完的入場考試。 你可以請 AI 根據前面三層提出多個版本,再檢查: 這個畫面是否真的服務情緒? 運鏡是否讓觀眾更接近衝突? 角色在不同鏡頭裡是否仍然一致? 視覺效果是否搶走了故事重點? 如果你想把這一層落成更具體的分鏡工作流,可以參考本站的〈用 AI 快速生成短影音?九宮格分鏡技巧解決人物變形〉。那是一種實作方法,不代表所有 AI 影片都必須使用九宮格。 5. Iteration:生成只是開始最後一層是 Iteration,也就是反覆迭代:生成、挑選、修改、A/B Test,再生成。 很多人把 AI 影片想成「Prompt 寫好,按下生成,作品完成」。但真正的製作能力,往往體現在你能不能看出第一版為什麼不對,並把問題轉成下一輪可執行的調整。 例如: 觀眾沒有停下來,可能是 Hook 不清楚,而不一定是畫質不夠高。 角色看起來不一致,可能需要先固定角色描述與參考素材,而不只是再加更多形容詞。 反轉沒有感覺,可能是前段沒有埋下足夠的期待,而不只是剪接速度太慢。 工具會換,模型會換,按鈕的位置也會換;但觀眾為什麼停下來、為什麼看完、為什麼分享與購買,沒有那麼快改變。 AI 短影音能力,是流量、故事、審美與 AI 的交集如果要重新定義 AI 短影音能力,我會把它寫成: AI 短影音能力 = 網紅的流量感 × 編劇的故事感 × 最低限度的導演審美 × AI 的執行力 你不需要變成 Joeman,也不需要變成電影導演,更不用先花三年把所有影視專業學完。 但你要開始知道: 什麼東西大家會看? 什麼故事大家會想知道結局? 什麼畫面看起來是好的? 什麼樣的節奏能讓人看完? 怎麼把這些意圖交給 AI? 這幾件事組合起來,才是能真正落地的 AI 影片能力。 下一步不只是 Vibe Filming,而是 AI 製片人現在的 AI 製片流程,大概還是: 人 → Prompt → AI → 影片 但再往下一個階段走,我認為可能會變成: 人 → 商業目標 → AI Agent → 完整影片 例如,未來你可能只需要說: 我要賣這盒中秋禮盒,TA 是 30–45 歲女性。請研究近期熱門的送禮短影音,整理爆款影片常見的 Hook,設計三個不同版本。每支 20 秒,前兩秒要能停滑,中間至少出現一次情緒反轉,最後導到 LINE。演員、場景、腳本、分鏡、B-roll、運鏡、音樂、字幕與剪輯節奏,請全部提出規劃。 接下來,Agent 可能協助完成研究爆款、分析模式、寫腳本、做分鏡、生成素材、配音、配樂與剪輯,最後把多個版本交給你比較。這裡描述的是一個未來工作流想像,不是對目前所有工具能力的保證。 到了那一天,人真正重要的工作,可能只剩下一件事:判斷。 這是不是我要的? 這是不是我的品牌? 這是不是我的觀眾會看的? 這是不是能達成我的商業目的? 所以 AI 時代,我們不一定每個人都需要成為導演,但每個人都要開始學會另一個角色:AI 製片人。 傳統導演想的是: 這顆鏡頭我要怎麼拍? AI 製片人想的卻是: 我要什麼結果? 誰會看? 我要讓他產生什麼感覺? 為什麼他會看完? AI,你給我三種最好的做法。 這可能才是 AI 影片真正的 Vibe Filming。 不是你把每一顆鏡頭都想清楚,再命令 AI 忠實執行;而是你知道自己要去哪裡,然後讓 AI 幫你找到更好的路。 結語:真正的差距在於判斷與指揮未來真正拉開差距的,可能不是誰最會下運鏡指令,而是誰最會提出意圖、判斷結果,然後指揮 AI 把作品做到最好。 這也是為什麼 AI 影片素養比「背熟某個工具的按鈕位置」更值得學。當工具與模型不斷更換,你仍然可以從受眾、情緒、故事、視覺與迭代五個層次重新開始。 如果你也在建立更完整的人機協作能力,可以延伸閱讀本站的〈4D Framework:比 Prompt Engineering 更完整的 AI Fluency 框架〉,把「委派、描述、判斷、盡責」的思考方式帶回 AI 影片之外的工作。 常見問答 (FAQ)Q1:學 AI 影片之前,一定要先學完整套導演或攝影專業嗎?不一定。若目標是製作 AI 短影音,應先學會定義受眾、情緒、故事與商業目標,再補足能看懂和判斷畫面的基本導演審美;不需要先把完整影視專業學完才開始創作。 Q2:AI 影片 Prompt 應該寫攝影機指令,還是描述觀眾感受?兩者都可以使用,但建議先描述觀眾、情緒與故事意圖,再依任務需要補充景別、運鏡、角色與畫面限制。這樣 AI 有機會提出多種視覺解法,而不是只照著一張固定施工圖執行。 Q3:為什麼短影音要先做注意力設計,而不是先做分鏡?因為短影音觀眾可能在幾秒內滑走。先規劃停滑、問題、刺激、衝突、反轉與 CTA 等注意力任務,能讓景別、構圖與運鏡服務觀眾留存,而不是只追求畫面漂亮。 Q4:AI Video Literacy 具體包含哪些能力?AI Video Literacy 包含看懂、判斷、指揮與修正四種能力。你要能看出影片哪裡不符合預期、說明問題原因、把意圖交給 AI,並根據結果提出下一輪可執行的修改方向。 Q5:什麼是 AI 製片人?AI 製片人是以商業目標、受眾、情緒與成果為核心,指揮 AI 規劃腳本、分鏡、素材、聲音與剪輯,並負責比較與判斷最終結果的人。他不必親自完成每一個技術步驟,但必須對作品方向與採用結果負責。

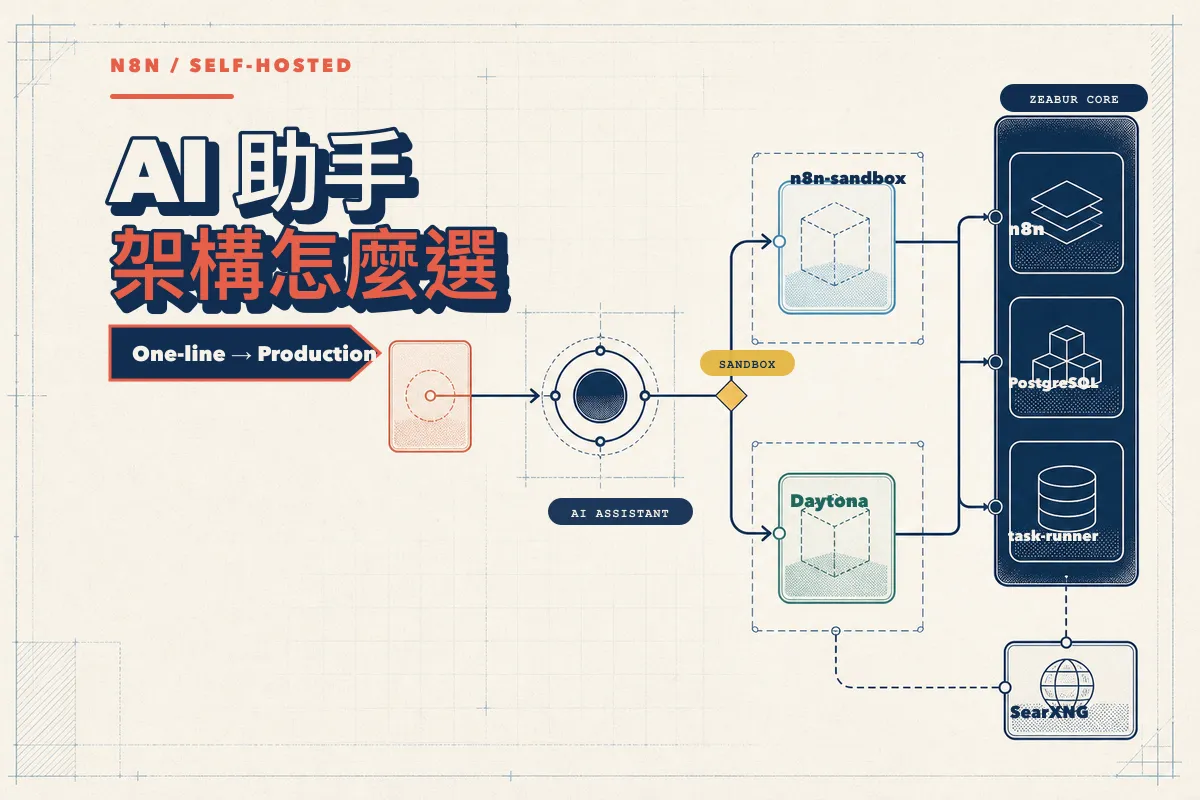
  • article-n8n 自架版 AI Assistant:One-line setup、Sandbox 與 Zeabur 架構

    2026/8/26

    AI自動化 n8n n8n新手教學
    n8n 自架版 AI Assistant:One-line setup、Sandbox 與 Zeabur 架構

    如果你跟我一樣是自己架 n8n,最近這個更新很值得注意。 n8n 官方社群公告指出,從 n8n 2.35 開始,Self-hosted AI Assistant 的設定流程變得簡單許多。以前要自己開啟相關模組、準備 Sandbox、設定模型,再視需要接上 Web Search;現在新的 Docker-based n8n instance 可以透過 One-line setup 預先建立 Sandbox、SearXNG 與 AI Assistant,最後再由你在 UI 中連接模型提供者。 不過,這次更新真正重要的地方,不只是「安裝變簡單」。 它讓 n8n 的使用方式開始從: 我自己拖 Node、寫 Expression、測試 Workflow。 慢慢走向: 我先把需求描述清楚,再讓 AI 協助我建構 Workflow。 官方目前仍將 Self-hosted AI Assistant 標示為 preview,功能與行為可能持續變動。本文因此會把版本與環境變數視為「目前文件的設定方式」,正式環境升級前仍要重新確認官方說明、備份與資料邊界。 先說結論:One-line setup 解決快速開始,不等於完成 Production 架構新的 One-line setup 適合: 第一次在本機學習 n8n。 想快速測試 AI Assistant 的 Workflow Builder。 想做 Demo 或驗證自動化想法。 不想一開始就手寫完整的 Docker Compose。 它不會替你完成所有事情。Docker 仍然要先安裝並啟動,模型 API 金鑰仍然要自己準備;SQLite、HTTPS、備份、權限與 Sandbox 隔離,也要按照正式環境需求重新設計。 可以先用這張表定位自己的路線: 你的情境 先選哪一條路線 判斷重點 新環境、本機測試或短期 Demo One-line setup + n8n-sandbox 先快速驗證 AI Workflow Builder。 已有 Zeabur + n8n + PostgreSQL + task-runner 保留既有服務,Sandbox 評估 Daytona 不必為了 AI Assistant 重建整套正式環境。 資料不能離開指定基礎設施 自架 n8n-sandbox,或暫不啟用 Builder 先確認 privileged Runner、資料政策與隔離邊界。 如果你已經有一套正在運作的 Zeabur + n8n + PostgreSQL 架構,也不需要為了 AI Assistant 直接打掉重來。比較合理的做法是先理解既有元件的責任,再決定要把 Sandbox 放在哪裡。 AI Assistant 不是 AI Agent Node:先分清楚兩個層次這兩個名字很像,但負責的工作不同。 AI Agent Node:工作流裡的一個節點以前我們在 n8n 裡使用 AI,通常會把 AI Agent 拉進 Workflow: 123456789Webhook ↓AI Agent ↓OpenAI / Claude / Gemini ↓Google Sheets ↓LINE 這裡的 AI Agent 是 Workflow 裡的一個處理步驟。它可以理解輸入、呼叫工具、查詢資料,再把結果傳給下一個 Node。 AI Assistant:幫你製作 Workflow 的助手AI Assistant 位於另一個層次。它不是你最後交付給使用者的 Workflow,而是協助你規劃、建立與修正 Workflow 的建構助手。 你可以這樣描述需求: 幫我建立一個 LINE 預約系統。收到 LINE Webhook 後判斷使用者操作;如果使用者要預約,就讀取 Google Calendar 的可預約時段,再產生 LINE Flex Message;預約成功後,把資料寫進 Google Sheets。 以前你可能要自己完成: 123456789找 Node ↓設定 Credential ↓寫 Expression ↓查 API 文件 ↓測試與除錯 AI Assistant 想協助的是: 12345678910111213理解需求 ↓規劃 Workflow ↓產生 Workflow 程式碼 ↓在 Sandbox 中編譯與測試 ↓修正錯誤 ↓產生有效的 Workflow JSON ↓儲存到 n8n 所以 n8n 的學習重點,會逐漸從「我知道每個 Node 在哪裡」延伸到「我能不能把需求、資料結構與限制描述清楚」。 如果你想先理解 LLM 與 AI Agent Node 的選擇差異,也可以延伸閱讀 何時該用 LLM?何時該派 AI Agent 上場?。 Self-hosted AI Assistant 其實由三個部分組成可以先用這個架構理解: 123456789101112 ┌─ OpenAI ├─ Anthropic你 → n8n AI Assistant ─ OpenRouter └─ OpenAI-compatible API │ ├──────── Web Search │ ├─ Brave Search │ └─ SearXNG │ └──────── Sandbox ├─ n8n-sandbox └─ Daytona 1. Model Provider:AI 的大腦你仍然要自行選擇模型提供者並準備 API Key,例如: Anthropic。 OpenAI。 OpenRouter。 其他 OpenAI-compatible API。 n8n 不會附送模型,也不會替你支付模型使用費。One-line setup 做的是準備 AI Assistant 所需的執行環境;模型連線與費用仍然由你的模型提供者決定。 2. Sandbox:AI 的隔離工作區AI Assistant 的 Workflow Builder 不是只回傳一段文字。它可能需要建立檔案、寫入 TypeScript、執行編譯器、安裝套件、執行程式,再根據錯誤反覆修正。 這些工作不應直接在正式 n8n Host 上執行,因此需要一個專用 Sandbox: 123456789AI Assistant ↓寫入 workflow.ts ↓TypeScript type-check ↓執行並產生 Workflow JSON ↓驗證成功後才交回 n8n 如果沒有可用的 Sandbox,Workflow Builder 的能力就無法完整使用。要注意的是,Sandbox 提供的是程式碼執行隔離,不等於自動完成權限控管、資料遮罩或人工作業確認。 3. Web Search:讓 AI 查得到最新資料如果你要求 AI 協助串接最新 API,它可能需要查詢官方文件、Endpoint、Authentication 或 Request Format。Web Search 就是提供這一層能力。 依照 n8n 目前的 Instance AI 設定文件,搜尋提供者的優先順序是: 12345Brave API Key ↓ 沒有SearXNG URL ↓ 都沒有Web Search disabled 沒有 Search Provider 時,fetch-url 仍可能可以使用,但 AI Assistant 不會具備主動 Web Search 能力。若希望搜尋也留在自己的基礎設施,可以考慮在同一個網路環境部署 SearXNG;若追求較少維護元件,則可評估 Brave Search。 新環境:One-line setup 會幫你準備什麼?執行前先準備 DockerOne-line setup 不會替你安裝 Docker。先確認 Docker Engine 或 Docker Desktop 已啟動,而且 Docker Compose v2 可以使用: 1docker compose version Windows 使用者若要依照 POSIX shell 流程執行,建議使用 Docker Desktop 搭配 WSL2,並在 WSL Terminal 中操作。不同平台與 Docker 版本仍應以官方文件的當期說明為準。 官方快速指令在準備好的目錄執行: 1curl -fsSL https://get.n8n.io | sh 它不是「免安裝 Docker」,而是把原本要自己撰寫與組合的 Docker Compose 設定、資料卷、Sandbox 與 Web Search 服務整理成較容易開始的流程。完成後通常可以從以下位置開啟 n8n: 1http://localhost:5678 One-line setup 背後的服務官方 Docker Compose 文件中的主要元件包括: 12345n8n├── sandbox-certs├── sandbox-api├── sandbox-runner-1└── searxng n8n:Workflow Editor 與主要應用程式。 sandbox-certs:產生 Sandbox 服務需要的 TLS 憑證。 sandbox-api:n8n 與 Sandbox 溝通的控制層。 sandbox-runner-1:建立與執行 Sandbox 的 Runner。 searxng:AI Assistant 的 Web Search 後端。 這個快速架構預設沒有另外建立 PostgreSQL 服務,測試環境通常會使用 SQLite。若要長期承載團隊或企業工作流,資料庫、備份與復原策略要另外規劃。 遠端腳本不要盲目直接執行curl ... | sh 很方便,但它也代表把遠端下載的內容直接交給 shell。即使來源是官方,重要主機仍可先下載、閱讀,再執行: 123curl -fsSL https://get.n8n.io -o get-n8n.shless get-n8n.shsh get-n8n.sh 正式環境還要確認目前目錄、資料卷、備份與更新策略,不要把測試環境的指令直接套到含有重要資料的主機。 既有 n8n:不要為了 AI Assistant 直接重建整套環境如果你已經使用 Docker 或 Zeabur 部署 n8n,建議採取漸進式流程: 123456789101112131415備份 Workflow、Credentials 與資料庫 ↓確認目前 n8n 版本與升級相容性 ↓升級到支援 AI Assistant 的版本 ↓確認原有 Workflow 正常 ↓設定 Model Provider ↓選擇 Sandbox Provider ↓選擇 Brave Search 或 SearXNG ↓用測試 Workflow 驗證 AI Assistant 官方公告將 n8n 2.35 或更新版本列為 Self-hosted AI Assistant 的前提之一,但版本與設定仍會更新。不要只因為看到一個新的功能,就直接替換正在服務中的 n8n;先確認資料庫、Encryption Key、Webhook、Credentials 與現有 Workflow 都能復原。 Sandbox 有兩種路線:n8n-sandbox 或 Daytona這是整篇最容易被忽略、但最值得先做決策的部分。 方案一:n8n-sandboxn8n-sandbox 是由你自己管理的 Sandbox 服務。以 Docker Compose 部署時,n8n、Sandbox API、Runner 與 SearXNG 可以放在同一套基礎設施中: 1234567自己的 VPS 或 Docker Host│├── n8n├── PostgreSQL├── SearXNG├── sandbox-api└── sandbox-runner-1 它的優點是控制權高,資料與執行環境可以盡量留在自己的 Infrastructure,適合: 本機開發。 課程 Demo。 測試 AI Workflow Builder。 有能力維護 Docker-in-Docker 的自架環境。 公司政策要求資料不能離開指定基礎設施。 但要注意,官方 Compose 中的 sandbox-runner-1 使用 privileged: true,而且透過 Docker-in-Docker 建立與執行其他 Sandbox Container。這不是一般的 PostgreSQL 或 n8n Container;官方文件也提醒不要把 Runner 的連接埠暴露到 Internet,並應將它視為高權限元件。 官方文件目前以至少 4 GB RAM、2 vCPU 作為這套 Compose Sandbox 的起始資源參考。實際需求仍會受到同時執行的 Workflow、模型與 Sandbox 工作量影響,不能把它當成所有 Production 環境的保證規格。 方案二:DaytonaDaytona 是另一個 Sandbox Provider。架構會變成: 1234567891011你的 n8n Host│├── n8n├── PostgreSQL└── Web Search │ │ API ↓ Daytona │ └── AI Sandbox Container n8n 透過 Daytona API 建立或管理隔離的 Sandbox,AI Assistant 在其中寫檔案、執行 TypeScript、檢查錯誤,再把通過驗證的 Workflow 交回 n8n。這樣 AI 建構程式碼的執行環境就不必與正式 n8n Host 共用同一個 Docker-in-Docker Runner。 Daytona 的代價是增加第三方服務依賴、API Key、使用量與費用。更重要的是,AI Assistant 建構過程所需的檔案與資料可能進入外部 Sandbox;如果你的流程包含高度機敏企業資料、金融資料或特殊個資,必須先做資料邊界與供應商政策審查。 兩種 Sandbox 怎麼選? 使用情境 建議與理由 個人電腦測試、課程或短期 Demo 選 n8n-sandbox,先用 Docker Compose 快速重現環境。 完全 Self-hosted、資料希望留在自己的基礎設施 選 n8n-sandbox,但要接受 privileged Docker-in-Docker Runner 的維運與安全責任。 已有正式 n8n、希望降低維運 評估 Daytona,避免自行維護高權限 Sandbox Runner。 Zeabur 上的既有 n8n 保留 n8n、PostgreSQL 與 task-runner,Sandbox 優先評估 Daytona。 資料不得離開指定環境 先以資料政策與隔離要求為前提,評估自架 n8n-sandbox 或暫不啟用 Builder。 Self-hosted 不代表「所有東西都一定要塞在同一台 Server」。比較成熟的判斷方式是:哪些核心資料與自動化服務值得自己管理,哪些短生命週期的 AI 執行環境可以交給專門的 Sandbox Provider。 Zeabur + n8n + PostgreSQL + task-runner:我會怎麼選?如果你的現有架構是: 12345Zeabur Project│├── PostgreSQL├── task-runner└── n8n 我會先保留這套核心環境,讓 AI Assistant 的 Sandbox 走 Daytona: 12345678910Zeabur│├── PostgreSQL├── task-runner├── n8n└── SearXNG(可選) │ └──────── API ──────── Daytona │ └── AI Sandbox 原因不是 Daytona 一定比較安全或一定比較便宜,而是這個選擇與 Zeabur 的部署方式比較相容。 task-runner 不等於 AI Assistant Sandbox這裡非常容易混淆。 官方 task runners 文件把 task runner 定位為執行 Code Node 中 JavaScript 與 Python 程式碼的機制;它可以作為 n8n 的外部 Runner,隔離一般 Workflow 執行時的使用者程式碼。 AI Assistant Sandbox 則負責另一個流程: 123456789AI Assistant ↓建立 workflow.ts ↓執行 TypeScript 編譯與測試 ↓修正錯誤 ↓產生有效 Workflow JSON 因此: 1task-runner ≠ AI Assistant Sandbox 即使 Zeabur 裡已經有 task-runner,也不代表 AI Assistant 的 Workflow Builder 已經具備可用的 Sandbox。兩者可以同時存在,角色也不互相取代。 為什麼不直接把 n8n-sandbox 塞進 Zeabur?Zeabur 官方目前說明,不能直接從 Docker Compose YAML 部署服務;可以改用 Dockerfile、Docker Image 或轉成 Zeabur Template YAML 等方式組合服務。 而 n8n 官方 Sandbox Compose 還包含 sandbox-api、sandbox-runner-1、TLS 憑證,以及 privileged: true 的 Docker-in-Docker Runner。這代表它不是把一個普通 Docker Image 加進專案就結束。 如果你真的想在 Zeabur 部署自架 Sandbox,需要逐項確認: 目前使用的 Server 或 Plan 是否支援所需的高權限容器能力。 Sandbox API 與 Runner 能否以 Zeabur 支援的 Template 或服務方式部署。 內部網路、TLS、Runner 註冊與持久化資料如何配置。 Runner 是否會被錯誤暴露到公開網路。 發生 Sandbox 失敗時,n8n 與 PostgreSQL 是否仍然可用。 如果只是想在既有 Zeabur n8n 上加入 AI Assistant,我不會把這些基礎設施風險當成第一個實驗步驟。 Zeabur + Daytona 的取捨12345678910正式自動化平台Zeabur├── n8n├── PostgreSQL├── task-runner└── SearXNG(可選)AI 建構工作區Daytona└── Sandbox 優點: 不用先改動目前正常運作的 n8n、PostgreSQL 與 task-runner。 不必在 Zeabur 內維護 Docker-in-Docker privileged Runner。 正式 n8n 與 AI 建構程式碼的執行環境分開。 Daytona 發生問題時,主要影響 AI Workflow Builder,不一定等於既有 Workflow Runtime 全部停止。 缺點: 多一個外部服務、帳號、API Key、費用與供應商依賴。 AI Assistant 的 Sandbox 資訊可能進入第三方環境,需要檢查資料政策。 Daytona 的 API、方案、計費與支援範圍會變動,不能把本文的選擇當成永久答案。 所以我的判斷會是: n8n、PostgreSQL、task-runner 與搜尋服務自己控制;AI Assistant 的臨時執行環境交給 Daytona。 但如果企業資料政策不允許資料離開指定 Infrastructure,就應該改評估自架 n8n-sandbox,或先不要啟用 AI Workflow Builder。 Web Search:Brave Search 還是 SearXNG?這個選擇可以獨立於 Sandbox Provider。 選 Brave Search適合希望減少自行維護服務的人: 12345Zeabur└── n8n ├── Model Provider ├── Daytona Sandbox └── Brave Search API 需要管理 API Key 與使用量,也要確認資料是否符合公司的第三方服務政策。 選 SearXNG適合希望把搜尋服務放在自己控制的網路環境的人: 12345Zeabur├── n8n└── SearXNG │ └── 內部網路 SearXNG 是一般服務,與需要 privileged Docker-in-Docker 的 Sandbox Runner 不同。這也是為什麼在 Zeabur 架 SearXNG,通常比直接照搬整套 n8n-sandbox Compose 更容易拆分與管理。 設定時可以參考哪些環境變數?以下只展示名稱與結構,不要把真實 API Key 寫進公開文章、Git Repository 或截圖: 1234N8N_INSTANCE_AI_SANDBOX_ENABLED=trueN8N_INSTANCE_AI_SANDBOX_PROVIDER=daytonaDAYTONA_API_URL=https://app.daytona.io/apiDAYTONA_API_KEY=請填入自己的金鑰 如果採用 n8n-sandbox,則要依目前版本的官方設定文件提供 Sandbox Service URL 與必要的認證資訊。以目前設定文件的概念,可以先理解成: 1234N8N_INSTANCE_AI_SANDBOX_ENABLED=trueN8N_INSTANCE_AI_SANDBOX_PROVIDER=n8n-sandboxN8N_SANDBOX_SERVICE_URL=http://sandbox-api:8080N8N_SANDBOX_SERVICE_API_KEY=請填入自己的 Sandbox 金鑰 不同 n8n 版本的 Compose 範例與環境變數名稱可能調整,不要直接複製舊文章中的設定到 Production;部署前應以當期官方文件與 UI 中的 Sandbox connection 為準。 Web Search 的設定概念則是: 12345# Brave 有設定時優先使用 BraveINSTANCE_AI_BRAVE_SEARCH_API_KEY=請填入自己的金鑰# 或使用自架 SearXNGN8N_INSTANCE_AI_SEARXNG_URL=http://searxng:8080 實際欄位可在 n8n UI 的 Instance AI 設定中管理;如果同時設定兩者,依目前官方 configuration 文件,Brave 會優先於 SearXNG。 我會用這五個能力迎接 Vibe Automation這個更新不代表以後不用學 n8n。相反地,以下五個能力會更重要: 1. 需求描述不要只說「我想自動化」,而要說清楚: 當 A 發生時,取得 B 資料,判斷 C 條件,再執行 D;如果失敗,要通知誰、留下什麼紀錄? 2. 流程設計AI 可以產生 Workflow,但你仍然要判斷流程是否合理: 1234567891011Trigger ↓驗證輸入 ↓讀取資料 ↓判斷條件 ├── 成功路徑 └── 例外路徑 ↓通知與紀錄 3. 資料結構你至少要看得懂輸入與輸出的 JSON,才能判斷 AI 是否接錯欄位: 12345678910{ "customer": { "name": "王小明", "phone": "09xxxxxxxx" }, "appointment": { "date": "2026-09-01", "time": "14:00" }} 4. 系統整合Workflow 的價值不在於 Node 越多,而在於它能否穩定串接 Webhook、資料庫、API、LINE、Google Calendar 與通知服務。 5. 判斷 AI 做得對不對AI 產生的 Workflow 仍然需要測試: 1234567891011正常輸入 ↓邊界條件 ↓Credential 失效 ↓API timeout ↓重複事件 ↓資料是否正確寫入 「可以產生」與「可以安全交付」是兩件不同的事。 我的建議:先保留現在的 n8n,再逐步接上 AI Assistant如果你的 n8n 已經架在 Zeabur,而且 PostgreSQL、task-runner、Webhook 與既有 Workflow 都正常,我會採用以下順序: 12345678910111213① 備份目前 n8n、PostgreSQL 與 Credentials ↓② 確認目前版本與官方 AI Assistant 相容性 ↓③ 升級 n8n,先驗證原有 Workflow ↓④ 在 n8n 設定 OpenAI / Anthropic / OpenRouter 等模型 ↓⑤ Sandbox 選 Daytona,或依資料政策自架 n8n-sandbox ↓⑥ Web Search 選 Brave,或在 Zeabur 部署 SearXNG ↓⑦ 用測試 Workflow 驗證建構、修正與儲存流程 不要因為想玩一個新功能,就先把正常環境打掉重來。 Self-hosted 真正重要的能力,不是「什麼東西都自己架」,而是: 哪些東西值得自己管理,哪些東西交給專門服務反而更合理? 對 Zeabur + n8n 來說,我目前會把界線畫在: 1234567核心自動化平台與資料 ↓由 Zeabur 控制AI Assistant 的短生命週期執行環境 ↓交給 Daytona,或依資料政策自架 Sandbox 這樣既保留 Self-hosted n8n 的控制力,也不必為了 AI Assistant 把所有基礎設施一次複雜化。 參考文件 n8n Community:AI Assistant on self-hosted n8n: easier setup in 2.35 n8n 官方 One-line setup 文件 n8n 官方 Docker Compose 安裝文件 n8n Instance AI configuration n8n Instance AI sandboxing n8n task runners 文件 Zeabur:Deploying with Dockerfile 常見問答 (FAQ)Q1:One-line setup 會自動安裝 Docker 嗎?不會。你必須先安裝並啟動 Docker,且 docker compose version 可以正常執行;One-line setup 主要負責建立 n8n、Sandbox、SearXNG 與相關 Docker Compose 設定。 Q2:n8n 的 task-runner 和 AI Assistant Sandbox 是同一個東西嗎?不是。task-runner 主要負責執行 Workflow 中 Code Node 的 JavaScript 或 Python 程式碼;AI Assistant Sandbox 則提供 Workflow Builder 建立檔案、編譯 TypeScript、執行測試與產生 Workflow JSON 的隔離工作區。 Q3:n8n-sandbox 和 Daytona 該怎麼選?n8n-sandbox 適合本機開發、測試與希望所有資料留在自己 Infrastructure 的環境;Daytona 適合希望把 AI 產生程式碼的執行環境與正式 n8n Host 分開、降低自維護 Docker-in-Docker 複雜度的 Production 情境。若資料不得離開指定環境,應優先評估自架 Sandbox 或暫不啟用 Workflow Builder。 Q4:如果我已經在 Zeabur 使用 n8n 和 task-runner,還需要 Sandbox 嗎?需要。task-runner 不會自動提供 AI Assistant Workflow Builder 所需的 Sandbox;兩者用途不同,可以同時存在。你仍然要另外設定 n8n-sandbox 或 Daytona 作為 Sandbox Provider。 Q5:Daytona 會帶來哪些風險或成本?Daytona 會增加第三方服務依賴、API Key、使用量與費用,而且 AI Assistant 建構過程的檔案與資料可能進入外部 Sandbox。使用前應檢查企業資料政策、供應商條款、敏感資料遮罩與可接受的服務中斷範圍。 Q6:沒有 Web Search Provider 時,AI Assistant 還能使用嗎?可以使用部分功能,但主動 Web Search 會被停用;依目前 n8n 設定文件,fetch-url 仍可能可用。若需要查詢最新 API 文件,應設定 Brave Search 或 SearXNG,並確認搜尋資料的合規要求。 Q7:One-line setup 適合直接拿來跑企業 Production 嗎?它適合快速學習、測試與 Demo,但不等於完整的企業 Production 架構。正式環境仍要評估 PostgreSQL、HTTPS、備份與復原、權限、監控、更新回滾、Sandbox 隔離與資料邊界。