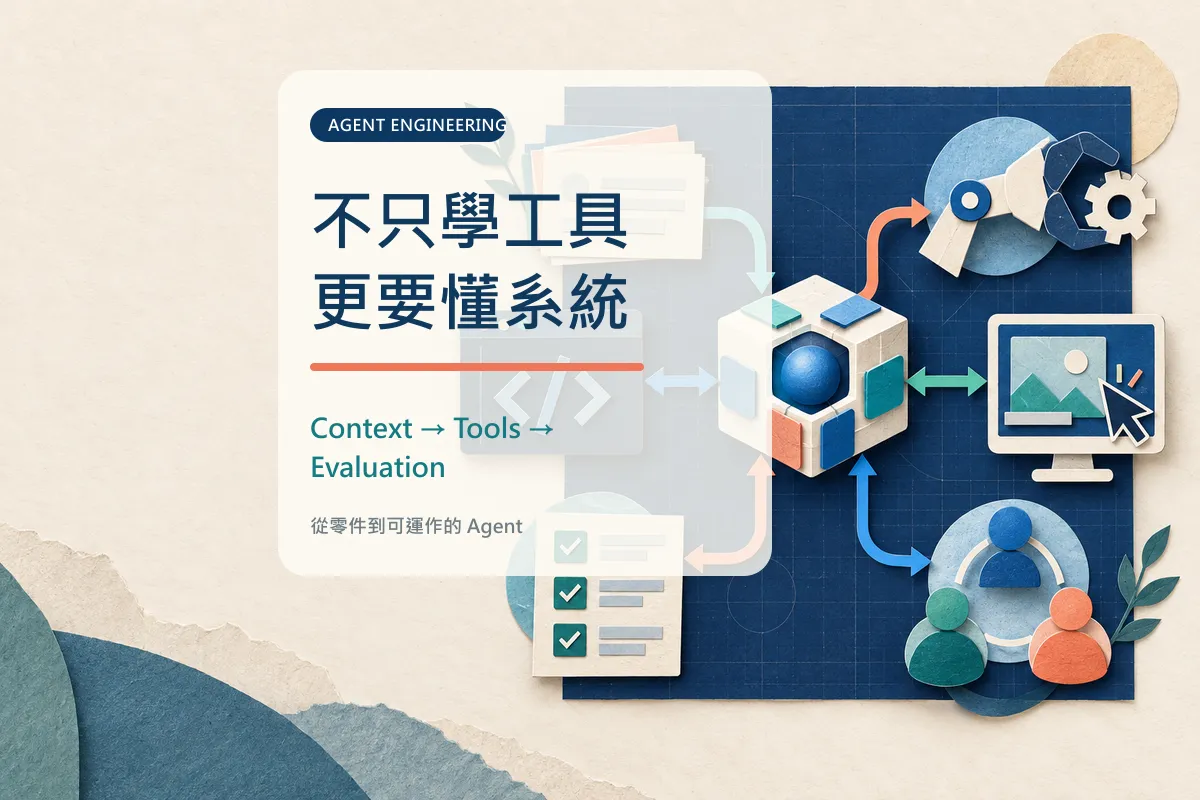
從 Prompt 到 Skill Library:我從吳奇老師的 Agent Skill 講座學到什麼?以及如何打造自己的 AI 工作能力庫
最近我看了「數位敘事力期刊」舉辦的一場直播講座,主講人是吳奇老師,主題是:
《Agent skill:為何需要 skill?與 skill 的極限》
直播原始影片:
YouTube|Agent skill:為何需要 skill?與 skill 的極限
看完之後,我最大的感受不是「又多了一個 AI 新名詞」,反而是很多我最近一直在做的事情突然被串起來了。
這一兩年我們從 Prompt、GPTs、Gems、MCP、Agent,一路走到 Skills。
表面上工具一直換,但底層其實是在解決同一件事:
怎麼讓 AI 不只是回答問題,而是學會「我們平常到底怎麼工作」。
尤其我自己最近大量使用 Codex、Claude Code、Agent、MCP 做課程教材、簡報、網站、影片、自動化工作流,更能感受到一件事:
真正有價值的,已經慢慢不是那一句「神 Prompt」。
而是:
你有沒有辦法把自己做事的方法,整理成 AI 可以重複使用的 Skill。
這篇文章就是我從吳奇老師直播中吸收之後,再搭配目前 OpenAI、Anthropic 與 Agent Skills 官方規格,重新整理出來的一套理解。
最後也會實際設計我準備使用的:
「享哥 Skill Library」
一、先用一句話理解什麼是 Agent Skill
我目前最喜歡的理解方式是:
Tool / MCP 告訴 AI「你可以做什麼」,Skill 告訴 AI「這件事情應該怎麼做」。
例如我今天給 Agent:
- Gmail
- Google Drive
- Calendar
- Browser
- Terminal
- Python
- ImageGen
這代表它有很多工具。
但是:
有工具,不代表會工作。
就像今天公司請了一位新員工,給他:
- 電腦
- Gmail
- ERP
- Excel
- 公司帳號
不代表他就知道:
收到客戶詢問後,可以依序判斷:
- 先確認什麼?
- 哪些資料要查?
- 哪些狀況要升級處理?
- 最後要填哪張表、寄什麼格式的信?
這中間缺的就是:
SOP、判斷規則、範本與經驗。
而 Skill 就是在做這件事。
OpenAI 現在也把 Skill 定義為可重複使用的工作流程,讓 ChatGPT 或 Agent 不需要每一次都重新被解釋流程。
二、我會把 AI Agent 能力拆成四層
從吳奇老師直播裡的 Workspace、Tools / MCP、Skill 架構,我自己重新整理成下面四層。
| 層級 | 解決問題 | 可以怎麼理解 |
|---|---|---|
| Model | AI 會不會思考 | 大腦 |
| Workspace / Runtime | AI 在哪裡工作 | 辦公室 |
| Tool / MCP | AI 可以操作什麼 | 工具 |
| Skill | AI 應該怎麼做 | SOP+教師手冊 |
例如:
1 | GPT / Claude |
這四層要放在一起看。
因為 Skill 並不是魔法。
假設 Skill 裡面寫:
打開瀏覽器登入後台,把資料輸入 ERP。
但是這個 Agent 根本:
- 沒 Browser
- 沒 Computer Use
- 沒帳號
- 沒權限
那 Skill 寫得再漂亮,也執行不了。
所以 Skill 能力永遠是:
1 | 模型能力 |
三、MCP 跟 Skill 到底差在哪?
這是很多人第一次接觸 Skill 最容易混在一起的地方。
假設 MCP 提供三個工具:
1 | search_customer() |
這代表 AI:
能查客戶、能查行事曆、能寄信。
可是它不知道什麼時候該用哪一個。
Skill 就可以寫:
1 | 當使用者要求安排客戶會議時: |
所以:
1 | MCP = Capability |
OpenAI 官方文件也把兩者定位為互補層:MCP Server 提供即時資料、授權與受控動作;Skill 則說明何時呼叫工具、依什麼順序處理,以及如何處理不完整結果與整理輸出。我會把它簡化記成:MCP 提供能力,Skill 描述工作流程。可參考 OpenAI Developers:Skills 與 MCP 的分工。
這個觀念非常重要。
因為我們以前很容易覺得:
「接上 MCP 就完成 Agent 了。」
其實不是。
MCP 比較像把工具箱交給 Agent。
Skill 才是在告訴它:
「我們公司拿這套工具到底怎麼做事情。」
四、Skill 不只是一個比較長的 Prompt
第一次看到 Skill 很容易想:
那不就是把 Prompt 存成 Markdown?
某種程度沒錯。
但如果只這樣理解,又會低估 Skill。
一個正式 Skill 通常是一個資料夾。
目前 Agent Skills 開放規格要求每個 Skill 至少包含 SKILL.md;scripts/、references/、assets/ 則依需求加入:
1 | my-skill/ |
其中:
SKILL.md
核心操作說明。
定義:
- 這個 Skill 做什麼
- 什麼時候使用
- 需要哪些輸入
- 工作流程
- 判斷規則
- 輸出格式
- 完成前檢查
references/
參考知識。
例如:
1 | 課綱 |
assets/
可重複使用的素材。
例如:
1 | PPTX 模板 |
scripts/
需要確定性執行的程式。
例如:
1 | Python |
這些目錄名稱對應 Agent Skills 開放規格列出的常見支援資源;除了 SKILL.md 之外,其餘目錄都是可選。
五、真正重要的設計:Progressive Disclosure
吳奇老師直播中,我非常認同的一個關鍵概念叫:
Progressive Disclosure
中文可以理解成:
漸進式揭露。
以前我們很常幹一件事情:
把所有規則全部塞進 System Prompt。
例如:
1 | 50 頁品牌規範 |
然後每一次對話全部讀。
結果就是:
- Token 增加
- Context 變亂
- AI 抓不到重點
- 不相關的規則互相干擾
Skill 的做法不同。
第一層:
1 | name |
AI 只先知道:
「有這個 Skill 存在。」
第二層:
只有判斷目前任務需要它時,才載入:
1 | SKILL.md |
第三層:
真的遇到某種工作,才讀:
1 | references/ |
Anthropic 把這套機制明確稱為 Progressive Disclosure;Agent Skills 官方規格也建議 Skill 啟動前先只載入名稱與描述,啟動後才載入完整 SKILL.md,需要時才讀其他資源。
所以好的 Skill Architecture 不是:
1 | 一個 50,000 字 SKILL.md |
而是:
1 | SKILL.md |
這一點對大型工作流非常重要。
六、Skill 真正封裝的是四種知識
這是我看完直播之後,自己再整理出來最重要的一個框架。
一個成熟 Skill,其實可能封裝四種東西。
第一層:Declarative Knowledge
也就是:
「知道什麼」
例如:
1 | AI 課程有哪些工具? |
這些比較適合放:
1 | references/ |
第二層:Procedural Knowledge
也就是:
「知道怎麼做」
例如:
1 | 收到課程需求 |
這就是:
1 | SKILL.md |
真正主要封裝的內容。
第三層:Executable Knowledge
也就是:
「真的幫我做」
例如:
1 | scripts/ |
這時 Skill 不只是叫 AI:
「記得檢查。」
而是直接:
「執行檢查程式。」
這會比靠 LLM 自己判斷穩定很多。
第四層:Decision Knowledge
這一層我認為最值錢。
也就是:
「專家為什麼這樣判斷?」
例如我在規劃 AI 課程時,真正有價值的不只是:
1 | 先做課綱 |
而是:
1 | 如果學員第一次接觸 Agent |
這些東西不一定寫在書裡。
它們來自:
做過很多次之後形成的經驗。
而這也是我認為 Skill 最有價值的一件事:
把 Human Skill 慢慢轉成 Agent Skill。
七、直播裡提到的 5 種 Skill 建立方式
吳奇老師整理了幾種 Skill 的建構方式。
我把它們重新整理一下。
方法一:Manual
最直接。
自己寫:
1 | SKILL.md |
適合:
本來就已經有完整 SOP 的人。
方法二:生成式建構
不是自己從空白開始。
直接讓 Agent 幫你建立。
OpenAI 現在也有 Skill Creator。
在 Codex 裡可以呼叫:
1 | $skill-creator |
OpenAI 官方文件目前也推薦使用內建的 Skill Creator 開始建立 Skill。
例如:
1 | $skill-creator |
接著 Agent 就可以協助建立基本架構。
方法三:逆向工程/工作流蒸餾
這是我自己最推薦的方法。
因為大部分人:
會做工作,但不一定會寫 SOP。
那怎麼辦?
先跟 AI 把工作做一次。
例如:
1 | 討論需求 |
做到最後直接告訴 Agent:
1 | 分析我們剛才完整的工作流程。 |
這件事情我會叫:
Workflow Distillation
工作流蒸餾。
它其實非常符合現在 Vibe Coding 的工作方式。
方法四:Record & Replay
這種比較像:
「不要聽我解釋,看我做一次。」
例如:
1 | 登入網站 |
Agent 透過:
- Browser Use
- Computer Use
- RPA
學會操作順序。
這類 Skill 未來會跟 GUI Agent 高度整合。
方法五:Decision Distillation
這比 Record & Replay 更進階。
不是觀察:
「你按哪個按鈕?」
而是觀察:
「你為什麼做這個決定?」
例如蒐集一位資深講師過去的:
1 | 50 個課程案例 |
再抽出:
1 | 什麼情況用 A |
這就從:
操作自動化
進化到:
決策經驗數位化。
八、其實這 5 種方法可以再濃縮成三類
我後來發現,它們本質上就是:
1 | 第一種 |
也就是:
1 | Write |
這樣一來 Skill 就不只是 AI 工程師的東西。
任何專業工作者都可以做。
九、Skill 跟 GPTs / Gems 有什麼不同?
直播裡用了一個很好懂的方式,把 GPTs / Gems 理解成預設 Prompt,而 Skill 是完整工作流程。
這樣入門非常好懂。
不過如果要更精確,我會稍微補充。
GPT / Gem 比較像:
「一個已經設定好的 AI 助手」
裡面可以包含:
- Instructions
- Knowledge
- Tools
- Persona
- 對話設定
Skill 比較像:
「這個 AI 助手可以學會的能力模組」
例如:
1 | 一個 Agent |
所以我自己會用更簡單的方式教:
GPT 比較像員工。
Skill 比較像員工會的技能。
而且 Skill 更強調:
模組化、可組合、可攜與按需載入。
目前 OpenAI 已支援 Agent Skills 開放格式,官方也把 SKILL.md 定義成可移植、可分享、可版本管理的工作流程格式。
十、Skill 最大的問題:不是越多越好
這也是我最近特別有感的事情。
GitHub 現在 Skill 越來越多。
我前陣子也研究過一次:
146 個免費 Agent Skills。
第一反應很容易是:
全部裝!
但是其實這不一定是好事。
例如你裝:
1 | presentation-design |
每一個 Description 都寫:
做簡報時使用。
那 Agent 到底選哪個?
這會產生:
Trigger Collision
所以一個 Skill 最容易被低估的欄位其實不是 Instructions。
而是:
1 | description: |
因為它其實也是:
Router
Agent Skills 官方規格明確要求 description 不只寫 Skill 做什麼,還應寫出「什麼情況使用」。OpenAI 也指出 Agent 主要根據 Skill 的 name 與 description 判斷是否需要呼叫。
例如不要寫:
1 | description: Helps create presentations. |
而是:
1 | description: > |
這就清楚很多。
十一、Skill 有自己的極限
看完直播後,我把 Skill 的極限整理成七個。
1. Model Ceiling
Skill 不會讓能力差的模型突然變成頂級模型。
它只能讓模型:
更了解怎麼使用既有能力。
2. Tool Ceiling
沒有 Browser:
就不能瀏覽網站。
沒有 CLI:
就不能執行 Terminal。
3. Permission Ceiling
有 Gmail Tool:
不代表有你的 Gmail 權限。
4. Context Ceiling
Skill 太長、太多:
還是可能造成 Context 干擾。
5. Knowledge Ceiling
Skill 不會自動擁有你的專業經驗。
你沒有把經驗整理進去:
它就不知道。
6. Environment Ceiling
同一個 Skill 放到:
1 | Codex |
可以執行的內容未必完全相同。
因為環境能力不同。
7. Security Ceiling
尤其外部 Skill 要非常小心。
因為 scripts/ 可能做:
1 | 執行 Bash |
OpenAI 現在也特別提醒,使用外部 Skills 前應檢查 Skill 與其支援檔案,尤其具有網路或 Shell 權限時,可能產生提示注入或資料外洩風險。
十二、模型越強,Skill 反而應該越薄
這是一個很有趣的現象。
以前模型比較弱,我們寫:
1 | 第一步做什麼 |
寫 300 條。
但模型越強之後:
很多事情其實它自己已經知道。
OpenAI 在 2026 年 9 月甚至特別發文提醒,新的模型能力提升後,要重新檢查累積已久的 Skill、AGENTS.md 與 Prompt,因為過度 scaffolding 可能造成 Context 膨脹與不必要限制。
所以未來好的 Skill 可能反而更像:
1 | Goal |
而不是:
1 | 滑鼠往右 10px |
這很像管理人。
員工能力越強:
管理者越不應該 Micro Management。
十三、我自己認為真正的 Skill 成熟度,可以分成 8 層
整理完直播內容後,我自己建立了一個 Skill 成熟度模型。
1 | Level 0 |
我覺得這套分類也很好跟之前談過的:
RPA Level 1~5
放在一起。
因為兩者其實描述兩個不同維度。
1 | Automation Level |
十四、最終一定會走向 Multi-Agent
直播最後談到:
1 | 校長 Agent |
不同 Agent 各自帶著自己的 Skill。
表面是在講 Multi-Agent。
但我反而覺得真正的問題是:
Organization Design
因為你要回答:
1 | 誰負責什麼? |
也就是企業本來就在做的:
1 | 角色 |
所以未來 Multi-Agent 最大的問題可能根本不是:
「我要用 GPT 還是 Claude?」
而是:
「這份工作到底怎麼拆?」
這才是 Skill 往下一層走真正困難的地方。
十五、看完這場直播,我決定不要再只是收藏 Skill
這就是整場直播對我自己最大的啟發。
最近我一直在研究:
- Codex
- Claude Code
- Agent Harness
- MCP
- Presentation Skill
- Product Design
- Slide Manifest
- Video Skill
- GSAP Skill
- 各種 GitHub Skill
如果一直照現在的方式,很容易變成:
1 | 收藏 50 個 |
結果:
真正屬於自己的工作方法沒有留下來。
所以我接下來比較想做的是:
「享哥 Skill Library」
把這幾年真正累積的工作流程,一個一個數位化。
十六、享哥 Skill Library 不應該按照工具分類
我不打算這樣分:
1 | Gemini Skill |
因為工具會換。
今年 Claude 強。
半年後可能 Codex 強。
再半年又有新東西。
真正不容易過時的是:
工作場景。
所以我的 Skill Library 應該按照:
1 | 我要完成什麼工作? |
來分類。
十七、第一版「享哥 Skill Library」
我目前會先規劃下面這些。
1 | xiang-skill-library/ |
01|course-intake
用途:
收到邀課需求之後,先判斷資訊是否足夠。
輸入:
1 | 單位 |
輸出:
1 | 已知條件 |
02|course-design
用途:
1 | 需求 |
包含:
- 定位
- 學習目標
- 單元
- 時數
- 工具
- 實作
- 成果
- 前置能力
03|slide-manifest
這個是我最近特別重要的一個 Skill。
以前常遇到:
課程大綱跟最後 PPT 不一致。
所以現在增加中間層:
1 | Course Outline |
Slide Manifest 應記錄:
1 | slide_id |
讓後續所有教材都吃同一份「簡報真相來源」。
04|presentation
輸入:
1 | Slide Manifest |
輸出:
1 | PPTX |
同時加入:
- 我的簡報 DNA
- 字體
- 圖文比例
- 圖像風格
- 排版
- ImageGen 規則
- Speaker Notes
這樣就不需要每次重新解釋:
「我喜歡什麼簡報。」
05|student-handout
把:
1 | 課程內容 |
並且保留:
1 | 提示詞 |
06|social-article
把:
1 | 研究 |
轉換成我的部落格與社群文章。
裡面可以慢慢累積:
1 | 我的語氣 |
07|social-visual
輸入:
1 | 文章 |
判斷:
1 | 主視覺概念 |
08|video-script
把文章轉:
1 | Hook |
09|course-review
這個我覺得會非常重要。
每次教材完成後:
不要直接交件。
由另一個 Skill 做:
1 | 對抗式 Review |
檢查:
- 時數合理嗎?
- 新手做得完嗎?
- 工具有沒有過時?
- 提示詞太長嗎?
- 實作真的能執行嗎?
- Slide Manifest 跟 PPT 一致嗎?
- 講義跟簡報一致嗎?
10|workflow-distiller
我覺得這會變成整套系統裡最重要的一個 Skill。
它的工作不是直接處理業務。
而是:
幫我製造 Skill。
流程:
1 | 讀完整對話 |
也就是:
Skill Factory。
11|skill-security-review
這是我另外會加的。
任何 GitHub 下載下來的 Skill:
先不要直接安裝。
全部先過:
1 | skill-security-review |
檢查:
1 | SKILL.md |
這會是未來 Skill 越來越普及之後,很實際的一個需求。
十八、實際開始:不要一次做 20 個 Skill
我反而建議:
從一個最常重複的工作開始。
對我而言,第一個很可能就是:
1 | course-design |
十九、第一步:先找一個「已經成功過」的案例
不要幻想 SOP。
直接找:
「我上一次做得很好的課程。」
把:
1 | 邀課需求 |
全部交給 Agent。
然後問:
1 | 分析這個專案。 |
二十、第二步:請 Skill Creator 建立 Skill
在 Codex 可以直接:
1 | $skill-creator |
然後:
1 | Create a skill named course-design. |
二十一、我會讓 SKILL.md 長這樣
1 |
|
你會發現:
真正好的 Skill 不一定要很長。
二十二、把詳細經驗拆出去
例如:
1 | course-design/ |
當課程是行政人員:
才讀:
1 | corporate-training.md |
當課程是新手:
才讀:
1 | beginner-course.md |
這就是 Progressive Disclosure。
二十三、第三步:一定要測試「什麼時候不該啟動」
很多人測 Skill 只測:
「它會不會啟動?」
其實還要測:
「它會不會亂啟動?」
例如 course-design:
應該啟動:
1 | 幫我規劃一堂 6 小時 Codex 課程 |
應該啟動:
1 | 這堂 AI 課只有 3 小時,怎麼調整? |
不應啟動:
1 | 幫我查明天天氣 |
不應啟動:
1 | 幫我修這段 JavaScript |
這就是:
Skill Routing Test。
二十四、Skill 不是做好就結束,而是要做 Evals
這也是我認為下一階段很重要的觀念。
OpenAI 已經專門提出:
Testing Agent Skills Systematically with Evals
因為只靠感覺:
「好像 V2 比 V1 好。」
是不夠的。
應該建立固定測試題。
例如:
1 | 10 個應該啟動 |
測:
1 | Trigger Accuracy |
OpenAI 官方現在也建議用 Evals 系統化測試 Skill 是否正確觸發、是否漏步驟,以及不同版本是否發生 Regression。
二十五、Skill 也應該像軟體一樣 Versioning
例如:
1 | course-design |
使用一段時間後發現:
人數超過 50 人的實作常失敗。
加入規則。
變成:
1 | v1.1 |
後來又發現:
Windows / Mac 混合班不能設計太多 OS-specific 操作。
再加入:
1 | v1.2 |
久了之後:
Skill 就變成:
我的數位工作經驗。
二十六、這其實才是 AI 時代真正的個人資產
模型會換。
Prompt 會過時。
工具會消失。
今天:
1 | Claude |
明天:
1 | Codex |
後天:
又有新的 Agent。
但是:
1 | 我怎麼設計課程 |
這些東西:
才是真正屬於自己的。
而 Skill 做的事情,就是:
把 Human Skill 變成可以被 AI 使用的 Digital Asset。
二十七、我現在會把整個發展路線理解成這樣
1 | Prompt |
以前大家問:
「Prompt 要怎麼寫?」
接下來可能會開始問:
「你的 Skill Library 裡面有什麼?」
再下一階段可能變成:
「你的 AI Organization 有哪些角色與能力?」
我覺得這才是 Agent 時代真正開始有趣的地方。
二十八、我的下一步:不是再找更多 Skill,而是開始蒸餾自己的工作
看完吳奇老師這場直播之後,我最大的改變是:
以前看到:
146 個免費 Skill
我的第一反應可能是:
趕快下載。
現在我的第一個問題會變成:
「這個 Skill 能不能補我的工作流程?」
如果不能:
其實沒有必要裝。
真正值得做的反而是:
每完成一個重要專案,就問一次:
1 | 這次有哪些做法值得留下來? |
然後:
1 | Project |
如果一年做 100 個專案:
不需要留下 100 個 Skill。
但也許可以留下:
20 個真正代表自己工作方法的高品質 Skill。
那個東西的價值,很可能遠高於收藏 1,000 個別人的 Skill。
最後
如果要我用三句話總結這次學到的內容:
第一句:
MCP 給 Agent 工具,Skill 教 Agent 怎麼工作。
第二句:
Skill 最有價值的地方,不是把 Prompt 存起來,而是把人的工作流程與判斷經驗保存下來。
第三句:
真正值得建立的,不是全世界最大的 Skill 收藏庫,而是最了解自己工作的 Skill Library。
所以我接下來真正想做的事情,就是:
享哥 Skill Library
不是一次做完。
而是一個專案、一個流程、一個判斷慢慢累積。
最終把:
1 | 我的課程 |
逐漸變成一組 AI 可以真正理解、呼叫、組合與執行的能力。
我覺得這才是 Skill 時代真正值得玩的地方。
延伸閱讀與參考資料
1. 本文主要學習來源
「數位敘事力期刊」直播講座,吳奇老師主講:
《Agent skill:為何需要 skill?與 skill 的極限》
2. OpenAI Academy|Using Skills
適合第一次理解 Skill。
OpenAI 把 Skill 定義成可以重複使用、分享的工作流程。
3. OpenAI API|Skills
比較技術面的官方規格,包括:
- SKILL.md
- references
- scripts
- assets
- Skills API
- Agent Sandbox
- Skill Discovery
4. OpenAI|Build Skills
想使用 Codex 建立 Skill,這篇非常值得看。
包含:
1 | $skill-creator |
以及 Skill 如何搭配 MCP。
OpenAI Developers:Build skills
5. OpenAI|Testing Agent Skills Systematically with Evals
Skill 做好之後不要只靠感覺測試。
這篇專門講:
1 | Skill Evals |
OpenAI Developers:Testing Agent Skills Systematically with Evals
6. OpenAI|Rethinking skills and prompts
模型能力變強之後,Skill 不一定要越寫越長。
這篇很適合理解為什麼 Skill 也需要定期「瘦身」。
OpenAI Developers:Rethinking skills and prompts for GPT-6 Astra
7. Anthropic|Agent Skills
Anthropic 對 Agent Skills 的完整概念說明。
包含:
- Skill 架構
- Progressive Disclosure
- VM
- Scripts
- References
- Skill Trigger
8. Anthropic Engineering|Equipping agents for the real world with Agent Skills
想理解 Progressive Disclosure,非常推薦這篇。
Anthropic Engineering:Equipping agents for the real world with Agent Skills
9. Agent Skills Open Standard
如果你要自己開發 Skill,非常建議直接收藏規格。
目前核心格式就是:
1 | skill-name/ |
10. Agent Skills GitHub
開放規格、文件與相關開源內容。
11. OpenAI Developers|Skills 與 MCP
OpenAI 對 Skills 與 MCP Server 分工的說明,可對照本文第三節。
給自己的提醒
以後再看到新的 Skill,不要第一時間問:
「我要不要安裝?」
先問:
「它解決的是我的哪一個工作流程?」
而每一次自己把一件事情做到滿意之後,也不要直接關掉對話。
最後多問 Agent 一句:
「把我們這次成功的流程蒸餾成一個 Skill。」
長期累積下來,那才會真正變成自己的 AI 能力庫。
常見問答 (FAQ)
Q1:MCP 和 Agent Skill 的差別是什麼?
MCP Server 提供 Agent 可使用的即時資料、工具、授權與受控動作;Skill 則描述完成一類工作的步驟、工具使用順序、判斷點與輸出要求。簡單記法是 MCP 提供能力,Skill 說明如何把能力用在工作流程裡。
Q2:建立自己的 Skill Library,第一步應該做什麼?
先挑一個經常重複、而且已有成功案例的工作。整理它的輸入資料、固定步驟、決策規則、常見例外與成功輸出,再把穩定流程寫成一個 Skill;細節資料則視需要拆到 references/、assets/ 或 scripts/。
Q3:Skill 是不是越多越好?
不是。從一個常見工作開始,確認它確實能減少重複說明或提升流程一致性,再逐步擴充。Skill 數量增加時,也要檢查描述是否重疊、觸發時機是否清楚,並用代表性案例測試它該啟動與不該啟動的情境。
Q4:使用外部 Skill 前需要檢查什麼?
先閱讀 SKILL.md 和支援檔案,特別檢查 scripts/、依賴套件、網路請求、檔案讀寫、環境變數及刪除操作。只有在了解它會執行什麼、存取哪些資料與權限後,才決定是否使用。